Python机器学习模型评估与数据集分离策略详解
本文深入解析Python机器学习中的模型评估与数据集分离技术。详细对比了训练集/测试集简单划分、K折交叉验证、弃一交叉验证及重复随机分离四种方法,并探讨了分类准确度、分类报告、平均绝对误差、均方误差及判定系数等核心评估指标,帮助开发者选择最优模型验证策略。
2026-10-14
5

本文深入解析Python机器学习中的模型评估与数据集分离技术。详细对比了训练集/测试集简单划分、K折交叉验证、弃一交叉验证及重复随机分离四种方法,并探讨了分类准确度、分类报告、平均绝对误差、均方误差及判定系数等核心评估指标,帮助开发者选择最优模型验证策略。
本文详细介绍Python中KMeans聚类算法在数据化运营中的应用,涵盖用户群体分类、产品价值组合及异常值发现等场景。重点解析Inertias、调整兰德指数、轮廓系数等核心评估指标的计算方法与意义,并提供完整的代码实现与可视化方案,助力提升运营精细化水平。

本文详细介绍Python中线性回归的应用,涵盖最小二乘法、贝叶斯岭回归、弹性网络及支持向量机回归等多种算法。通过完整代码示例,展示如何生成模拟数据、训练不同回归模型,并利用交叉检验、均方误差及R²等指标评估模型效果,最后实现可视化对比与新数据预测。
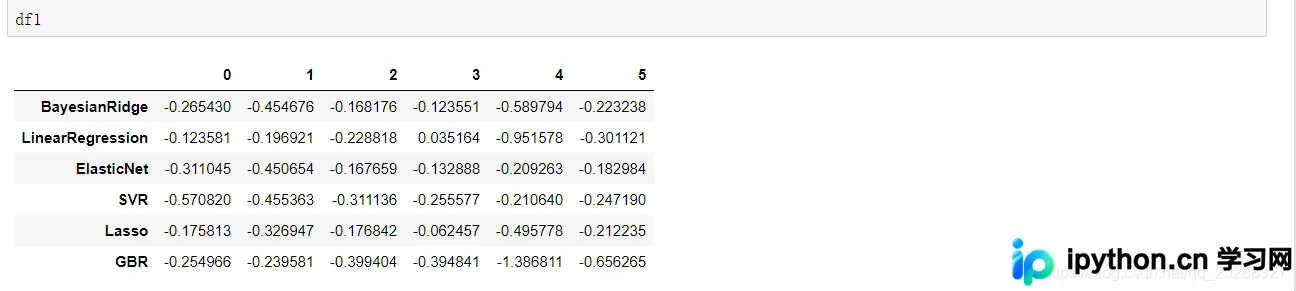
本文详细介绍K-means聚类算法的原理、目标函数及Python实现流程。涵盖初始化质心、迭代更新与收敛判断,提供基于sklearn与手动实现的代码示例,并分析算法优缺点及注意事项。
本文深入解析Python中random seed的作用机制,通过标准库random与numpy模块的实例,展示如何固定随机数生成顺序以实现结果复现。文章探讨了不同分布、形状及干扰函数对种子状态的影响,揭示跨平台代码复现的关键细节。
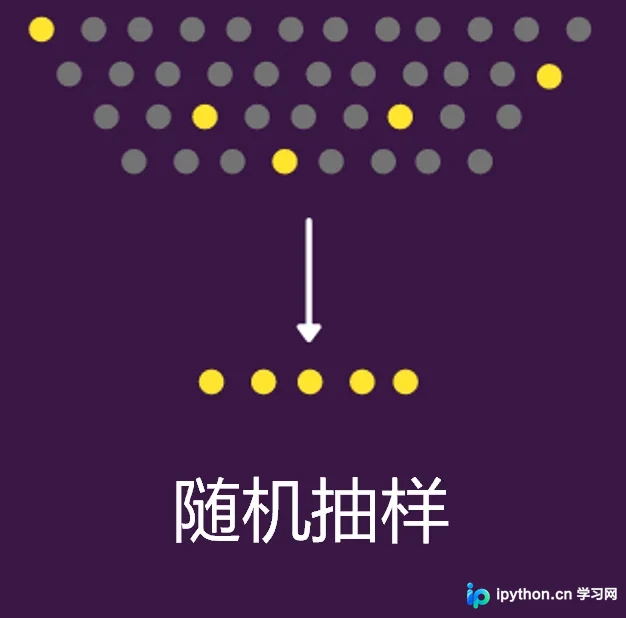
本文详细介绍Python中实现的8种常用抽样方法,涵盖概率抽样(随机、分层、聚类、系统、多级)与非概率抽样(简单、自愿、雪球)。通过具体代码示例与参数设置,解析如何在机器学习与统计推断中应用不同策略,确保样本代表性与模型质量。
本文详细介绍Python中matplotlib库绘制散点图的方法。重点解析scatter函数的常用参数,如颜色映射cmap、点大小s及标记类型marker。通过随机生成正态分布数据的实例代码,演示如何绘制并美化散点图,帮助开发者理解数据可视化在机器学习和数据分析中的应用。

本文详细介绍如何使用matplotlib库绘制混淆矩阵与正确率曲线。通过展示分类模型预测结果与真实属性的矩阵关系,直观评估分类器性能。同时,结合训练与测试数据的迭代过程,绘制正确率变化曲线,辅助分析模型收敛情况与泛化能力。
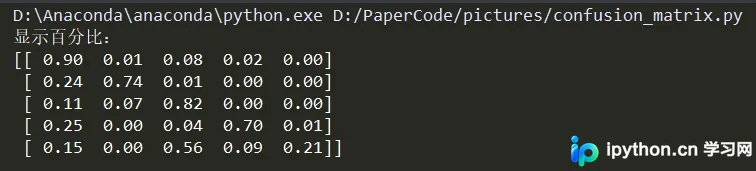
本文介绍如何使用Matplotlib绘制机器学习多分类模型的混淆矩阵,涵盖显示百分比和具体数值两种场景。通过示例代码展示如何配置参数以生成清晰的可视化图表,适用于论文撰写及模型评估分析。
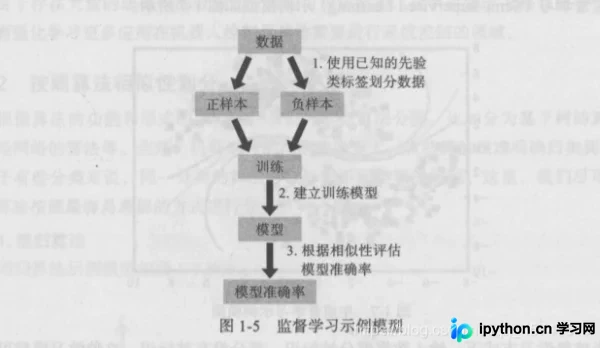
本文系统梳理Python机器学习的基础知识,涵盖其作为人工智能核心学科的定义与跨学科属性。详细解析了监督、半监督、无监督及强化学习等分类方式,并列举回归、聚类、决策树等主流算法。同时探讨了面向任务、认知模型与理论分析三大研究方向,为初学者构建完整的知识框架。
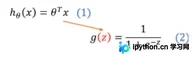
本文详细介绍在Python环境下使用逻辑回归解决二分类问题的完整流程。内容涵盖Sigmoid函数原理、对数损失函数的推导,并对比实现了梯度下降法与牛顿迭代法两种参数优化策略。通过具体实验数据,分析学习率对收敛速度的影响,展示如何计算分类边界及预测录取概率,为机器学习初学者提供从理论到代码的实操指南。
本文深入解析Python中的线性回归模型,涵盖最小二乘法(OLS)的原理与代码实现、梯度下降算法的迭代优化过程,以及多项式回归的特征转换技巧。通过具体代码示例,展示如何利用statsmodels和scikit-learn构建模型,帮助读者掌握从基础线性拟合到非线性多项式处理的完整技术路径。