

Python在数据科学与AI领域的崛起历程
深入剖析Python如何在数据科学与人工智能领域逐步成为主导语言,全面解析从底层数值扩展到大模型基础设施的技术演进、架构机制与生态建立过程。
一、基础奠定:从通用脚本到数值计算底座(1995-2005)
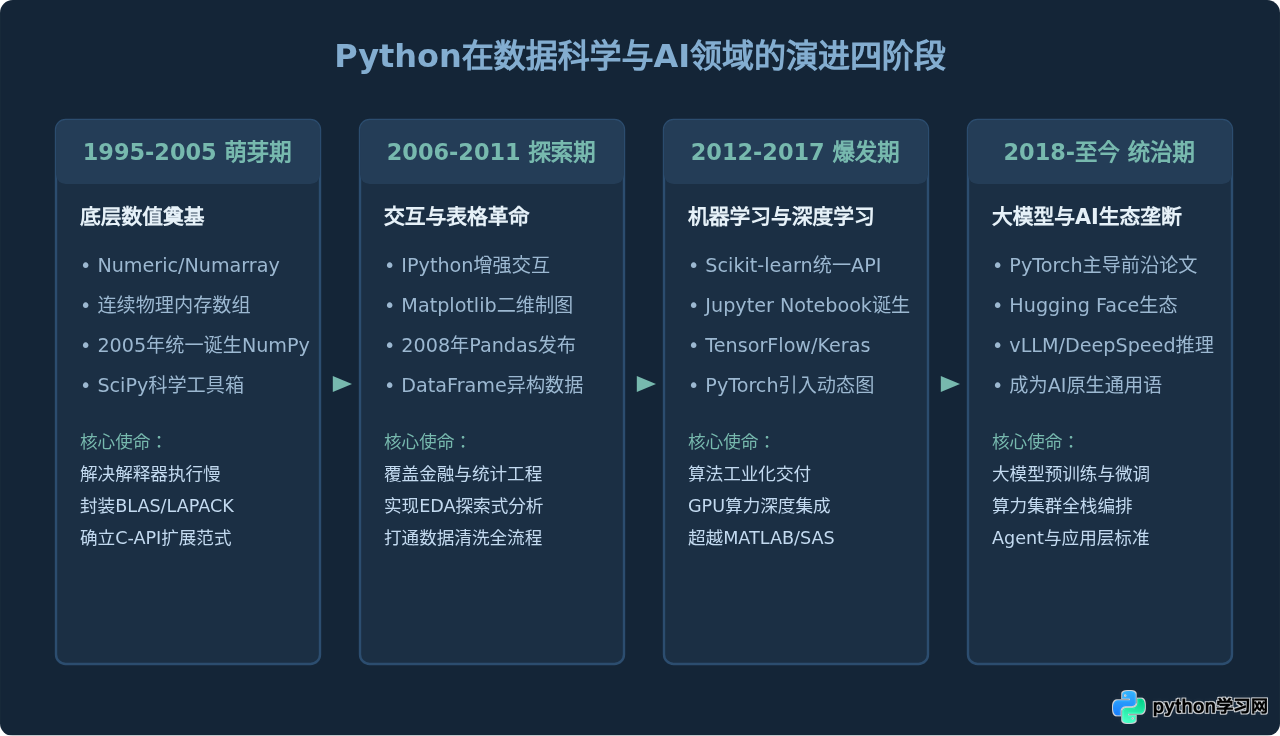
在1990年代中后期,Python最初被普遍视为一种易读的通用脚本语言,主要用于系统管理、文本处理和胶水粘合。然而,科学计算领域的研究人员很早就发现其语法表达与数学逻辑高度贴合。1995年,Jim Hugunin等人编写了Numeric模块(后被称为Numerical Python),首次为Python引入了同构、连续内存分布的N维数组对象。
原生Python列表(List)在数学计算上存在天然缺陷:Python列表本质上是指针数组,每个元素都是完整的Python对象,不仅存在巨大的内存开销(每个整型对象都有引用计数和类型指针),而且数据在物理内存中随机分散,无法利用现代CPU的L1/L2高速缓存与SIMD(单指令多数据)向量化指令。Numeric通过连续内存块存储同构基本类型(如C语言中的double或float),奠定了高性能向量计算的物理基石。
随后,社区出现了另一个分支Numarray,导致生态出现短暂分裂。直到2005年,Travis Oliphant主导将Numeric和Numarray的优势特性重构融合,正式创建了NumPy,并同步推动了集成科学计算库SciPy的成熟。NumPy定义了标准的多维数组对象ndarray、广播机制(Broadcasting)以及对BLAS(基础线性代数子程序)和LAPACK的高性能C/Fortran接口封装,彻底终结了底层数组实现的碎片化。
二、工作流革命:Pandas与交互式环境的破局(2006-2011)
尽管NumPy解决了同构数值矩阵的高效存储,但在真实的商业与科研场景中,数据绝大多数是异构的:包含时间戳、字符串、缺失值(NaN)以及不同类型列的表格。在2008年之前,针对这类数据的统计分析工作基本被R语言、SAS或SQL垄断。
当时任职于AQR资本管理公司的Wes McKinney面临高频金融时序数据的分析瓶颈,于2008年启动了Pandas项目。Pandas构建在NumPy之上,引入了结构化的Series和DataFrame数据结构,直接对标R语言的data.frame,但具备更加严谨的对齐索引机制与高性能的Cython加速内核。Pandas补齐了数据预处理、合并清洗、分组聚合(GroupBy)与重采样(Resampling)的关键能力,使数据科学家能够在一门通用语言内闭环完成“提取-清洗-建模”全部链路。
与Pandas几乎同步发展的还有Fernando Pérez等人推动的IPython项目。传统的编译执行模式严重阻碍了探索性数据分析(EDA):数据科学家需要不断查看数据分布、调整特征并立即观察绘图反馈。IPython提供了富文本终端交互,随后演化出的IPython Notebook(即后来的Project Jupyter),创造了代码、LaTeX数学公式、图表和文档交织的原生笔记本环境。这种所见即所得的计算范式,直接重构了全球高校、科研机构与工业界的数据研究习惯。
三、技术架构:胶水语言的底层性能解耦机制
常有开发者质疑:“Python作为一门带全局解释器锁(GIL)的动态解释型语言,为什么能承担算力吞吐量极大的深度学习与科学计算?”答案在于Python极为彻底的“双层解耦架构”。
在数据科学与AI的技术栈中,Python从未直接参与矩阵乘法、卷积运算或反向传播的逐元素循环。Python在上层扮演的是“控制平面”(Control Plane),负责模型结构定义、计算图调度、超参数控制和数据流转组织;而真正的“数据平面”(Data Plane)完全下沉到用C、C++、Fortran或CUDA编写的原生扩展中。
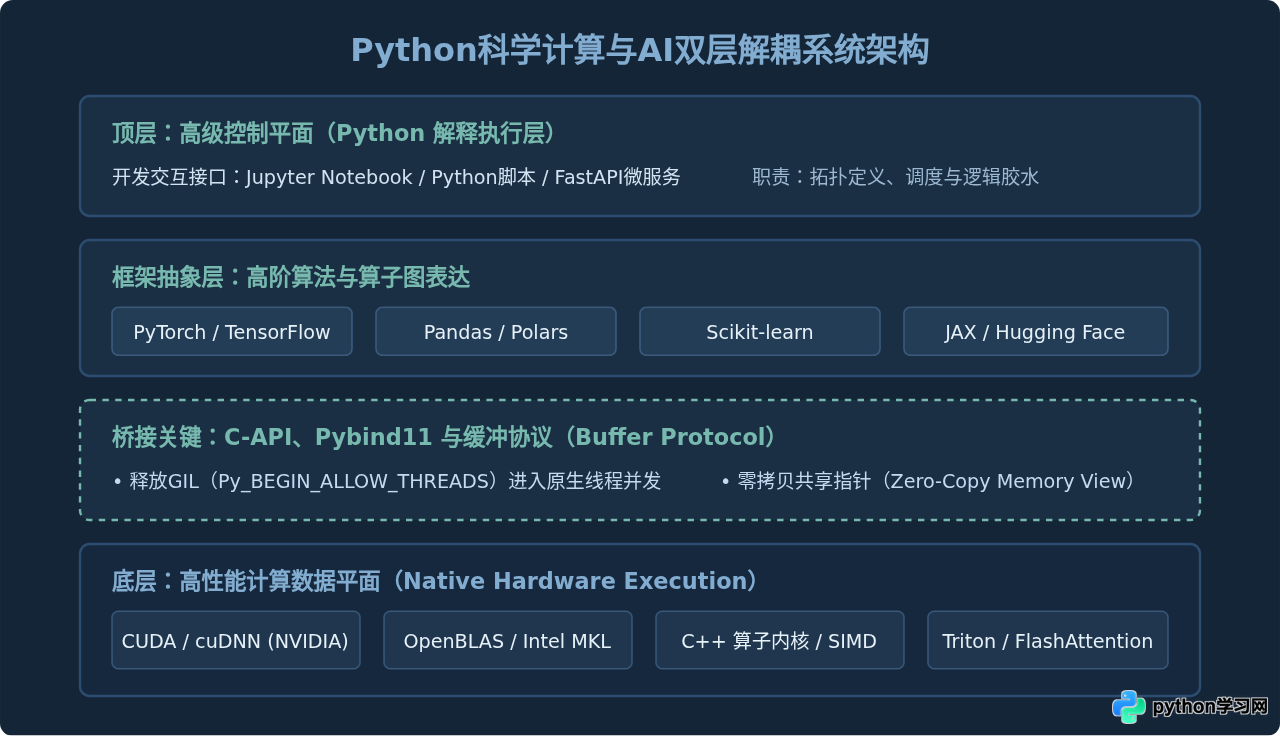
这一架构之所以能高效运行,依赖于三个核心机制:
- 缓冲协议(Python Buffer Protocol): 在C-Python规范中,缓冲协议允许第三方扩展直接暴露其内部的原始内存缓冲区地址。NumPy数组、PyTorch的Tensor以及Cython内存视图在互相传递海量数据时,无需经过序列化,直接传递内存首地址指针与跨度(strides),实现纳秒级的零拷贝传递。
-
执行期释放GIL:
Python的全局解释器锁仅作用于字节码的解释执行。当NumPy调用BLAS矩阵乘法,或者PyTorch将计算任务下发给CUDA内核时,底层C代码会显式调用
Py_BEGIN_ALLOW_THREADS宏,立即释放GIL。此时底层计算可独占多核CPU或上万个GPU流处理器,Python主线程仅保持轻量级事件监听。 - 无缝的硬件生态对接: 从2007年NVIDIA发布CUDA开始,硬件厂商优先为C/C++提供SDK。由于Python拥有成熟的C-API接口(如早期ctypes、SWIG到如今的Pybind11),社区能在几天内将最新的硬件加速指令包装为Python模块,极大缩短了科研原型向新算力迁移的周期。
四、机器学习爆发与深度学习霸权确立(2012-2020)
2010年前后,基于Python的经典机器学习生态开始形成统一范式。由INRIA等机构主导的Scikit-learn确立了著名的三件套API设计:
# Scikit-learn 标准化 API 范式
model.fit(X_train, y_train)      # 训练/参数估计
X_test_trans = model.transform(X_test) # 特征转换
predictions = model.predict(X_test)    # 推理输出
这种一致、清晰且遵循最小惊奇原则(Principle of Least Astonishment)的面向对象接口,彻底降低了特征工程与模型评估的使用门槛,让逻辑回归、支持向量机(SVM)、随机森林和梯度提升树(GBDT)在工业界大规模落地。
2012年AlexNet在ImageNet竞赛夺冠,宣告了深度学习时代的到来。在深度学习框架的演进初期,市场曾出现激烈竞争:
- Theano(蒙特利尔大学):率先探索符号计算图与自动微分,奠定了Python定义图、C++生成执行代码的技术路线。
- Caffe(UC伯克利):以C++为主,通过Protobuf配置文件定义网络,速度快但在复杂控制流与动态网络上拓展受限。
- TensorFlow 1.x(Google):采用静态计算图模式(Define-and-Run)。尽管利于生产端图优化与移动端部署,但调试极其困难,堆栈报错往往脱离Python上下文。
- PyTorch(Meta):2017年推出,核心主打动态计算图(Define-by-Run)。代码即网络,完全融入Python原生的循环、条件分支与pdb断点调试,迅速在学术界引发海啸式迁移。
PyTorch的胜利本质上是“Pythonic优先”理念的胜利——当算力足够充裕时,开发者的调试效率和学术原型的迭代速度成为了决定性因素。随着后来TensorFlow 2.x全面转向Keras并拥抱动态执行,Python已彻底筑牢了深度学习研究的第一入口。
五、多维度技术选型横向对比
为了客观理解Python的胜出条件,我们需要将Python与数据科学历史上几个最具竞争力的技术路线进行横向对比。
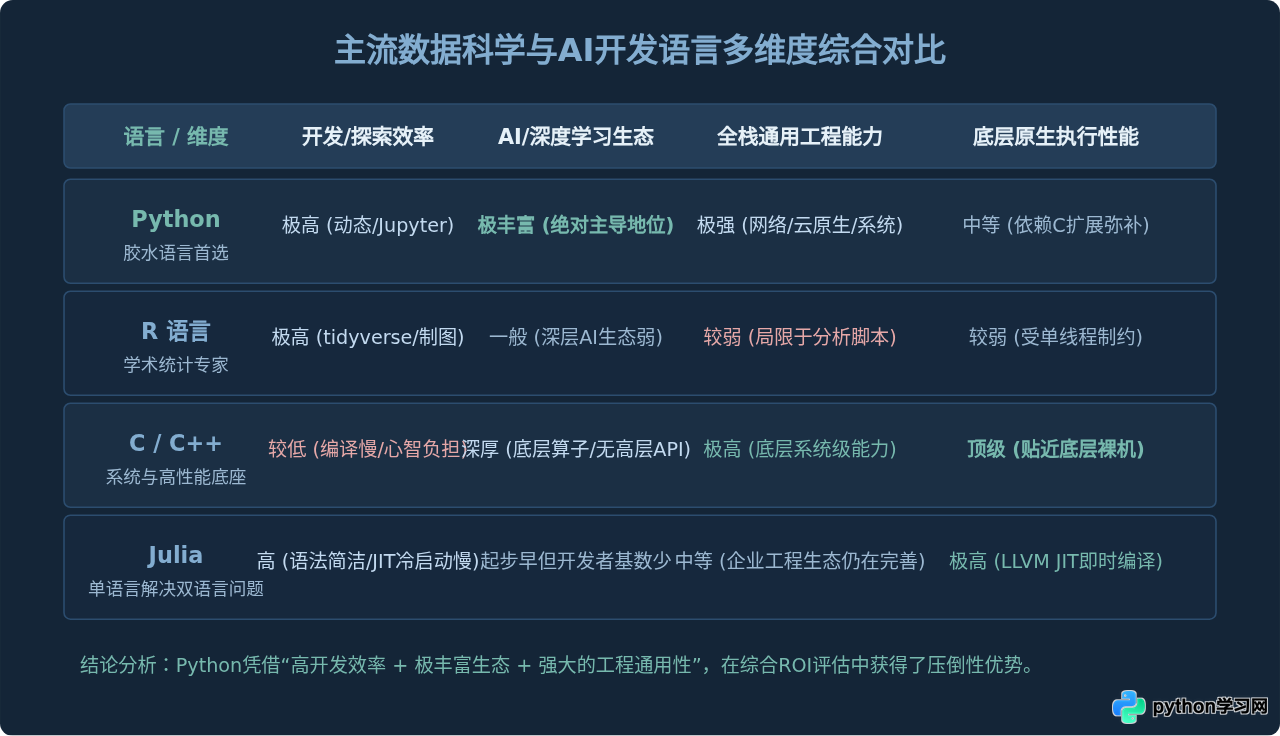
从对比中可以得出几个关键推论:
- R语言受限于工程外延:R在纯生物统计、学术制图(ggplot2)和计量经济学中依然优秀,但它很难被用来编写高并发的异步网络服务、消息队列消费者或操作系统底层的守护进程。
- C/C++因研发成本被挤压至底层:现代软件工程的成本主要由人力时间决定。直接使用C++构建上层多变的数据清洗逻辑,会导致研发周期拉长数倍且容易引发内存越界等稳定性风险。
- Julia面临生态滚雪球阻力:Julia在语言设计上试图通过多重分派与JIT编译在单门语言中消除“双语言问题”。然而,当Julia走向成熟时,Python已经在深度学习框架、模型权重仓库(Hugging Face)以及企业工程化栈中形成了庞大的网络效应(Network Effect)。
六、现代全景:大模型时代下的AI原生基础设施(2021至今)
进入2021年以来的大语言模型(LLM)时代,Python不仅没有被替代,反而进一步确立了垄断地位。现代AI开发已经从“从零编写算法模型”演变为“围绕大模型基座进行权重微调、算力编排、推理加速与智能体(Agent)开发”。
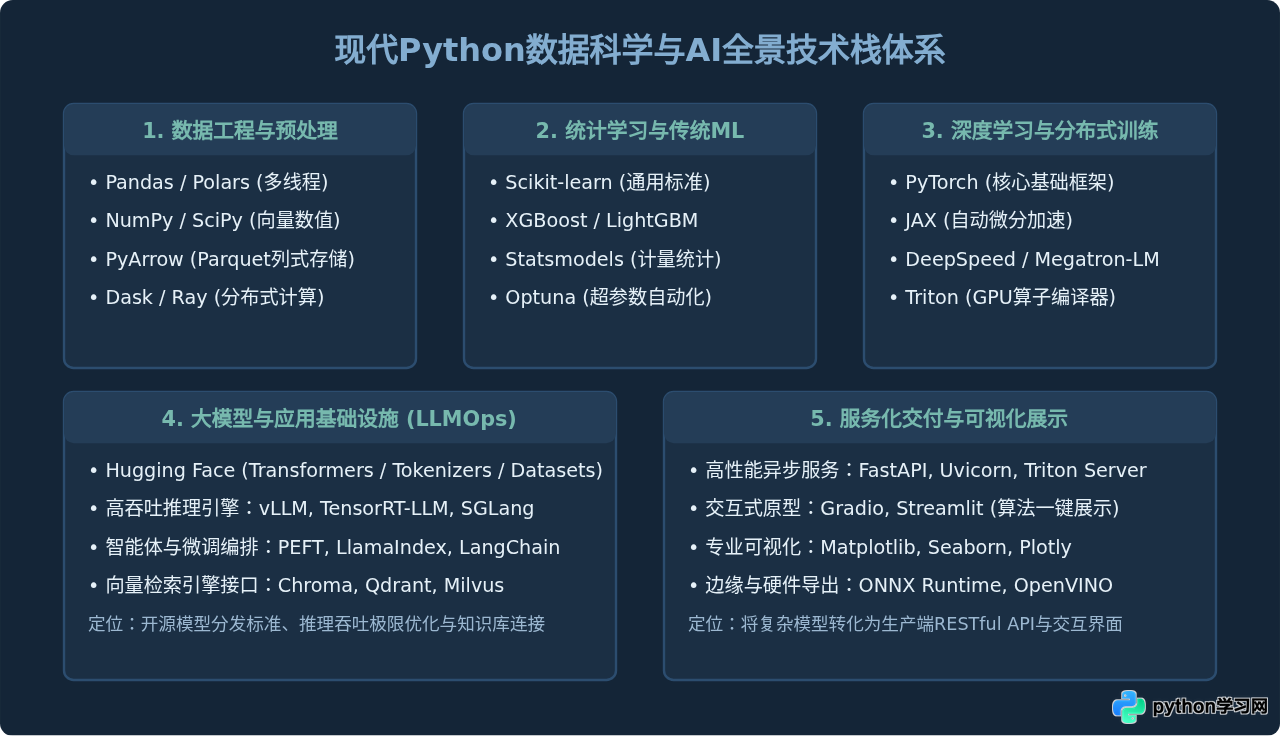
在大模型技术栈中,三个决定性枢纽将Python与AI彻底绑定:
- 模型权重分发标准(Hugging Face Hub): 全球主流开源大语言模型(如Llama系列、Qwen系列、Mistral等)的配置参数、Tokenizer切词规则和权重加载代码均默认以Python类库提供。开发者只需两行代码即可下载并拉起千亿参数模型。
- 显存受限下的前沿算子(Triton & FlashAttention): 过去编写高性能GPU算子需要手写复杂的CUDA C/C++代码,并精细管理线程块与共享内存。OpenAI开发的Triton编译器允许开发者直接使用Python编写定制化的GPU核心算子,编译器会自动将其转换为高效的高性能汇编代码,大幅降低了底层算子创新的门槛。
- 服务化落地闭环(FastAPI + vLLM): AI模型不再是孤立的离线脚本。通过vLLM的连续批处理(Continuous Batching)结合FastAPI的高并发异步事件循环,开发者可以在几个小时内将一个开源模型包装为兼容OpenAI规范的高吞吐流式API,直接服务于前端业务。
七、工程边界与选型注意事项
尽管Python在数据科学与AI领域占据绝对优势,但在具体工程落地中仍需明确其适用边界,避免出现技术误用:
工程落地的关键限制与应对:
1. 极低延迟关键路径(微秒级): 高频量化交易系统(HFT)的核心撮合引擎或自动驾驶线控执行模块,仍需使用C++或Rust编写。Python在此类场景通常仅用于离线策略回测和参数调优。
2. 原生单线程CPU瓶颈: 在非数值密集型的纯Python业务循环中,GIL依然会导致多线程无法利用多核。对于需要并行处理的大规模文本切分或解析任务,应优先采用多进程模型(multiprocessing)、Polars的Rust后端或集成Cython/C++模块。
3. 资源受限的边缘嵌入式设备: 当部署目标为单片机或微控制器(如Cortex-M系列)时,通常需要通过ONNX Runtime、TensorFlow Lite或编译为纯C++代码运行,而不是在端侧部署完整的Python运行时。
回顾Python的崛起历程,它的成功并非源于语言本身在执行速度上的极致,而是精准契合了科学探索与现代软件工业的演进规律:用极简统一的语法降低认知门槛,用开放解耦的架构拥抱底层硬件红利,最终通过庞大且自我强化的开发者生态,构筑起不可替代的AI工程高地。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









