

Python主要就业方向有哪些?Web、数据与AI岗位解析
全面解析Python三大主流就业方向:Web开发、数据科学与工程、人工智能与大模型开发。详解各方向核心技术栈、岗位职责、学习路径与选型建议。
刚掌握 Python 基本语法、数据结构与面向对象编程的求职者,打开招聘网站时常会产生困惑:同是标明“招聘 Python 开发”,有的职位要求精通 Django、异步网络编程与 MySQL 优化;有的职位强调 SQL 取数、统计学模型与商业 BI 看板;还有的职位则要求深度学习框架、Transformer 架构与大模型 RAG 应用开发。这三个主流方向——Web 后端、数据分析与工程、人工智能与大模型——在技术门槛、日常业务与职业演进路径上存在本质差异。搞清楚各方向的具体要求并针对性积累项目经历,是求职落地的关键基石。
一、Web 开发方向:稳定可靠的企业级服务后端
Python 在 Web 领域的就业定位主要集中于后端 API 研发、微服务架构以及内部业务系统构建。与注重高并发极端吞吐的部分底层技术相比,Python 在后端开发中的核心优势是交付效率高、生态完备、代码可维护性强,广泛应用于中大型互联网公司的业务线后端、产业互联网平台以及新兴 AI 产品的服务层封装。
1. 细分岗位与工作职责
- Python 后端开发工程师:负责核心业务逻辑编码、RESTful / GraphQL 接口设计、数据库表结构设计与读写调优,处理认证鉴权与第三方系统集成。
- API 与微服务工程师:在高吞吐与分布式场景下,基于异步协议构建轻量级微服务,对接消息中间件处理削峰填谷任务。
- 全栈开发工程师(以 Python 为主):在初创团队或企业内部效能工具开发中,使用 Python 构建后端接口,并配合 Vue 或 React 完成管理控制台开发。
2. 核心技术栈与实操要求
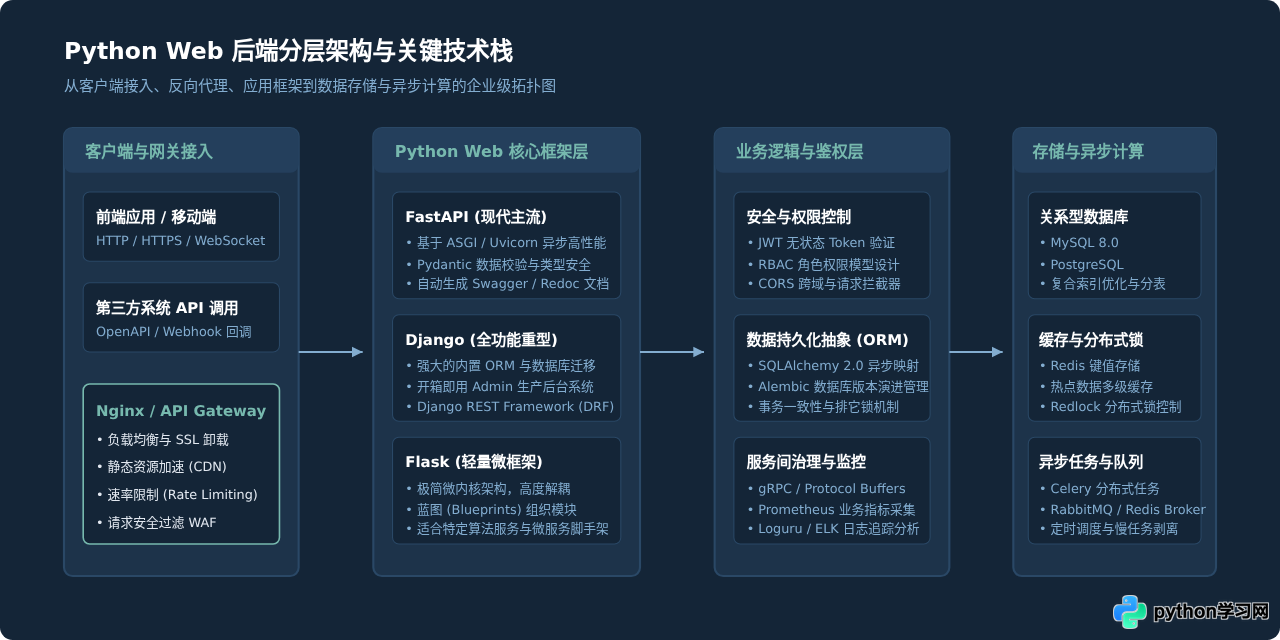
在工程实践中,框架选择通常取决于系统规模与性能要求:
- Django:适合业务逻辑复杂、需要快速上线的后台系统。Django 内置强大的 ORM、Admin 管理后台与表单验证体系,求职者需要熟练掌握 Django ORM 的查询优化,避免
n + 1查询瓶颈。 - FastAPI:当前增长最快且极受青睐的现代框架。基于 ASGI 与类型注解(Type Hints),原生支持异步协程(
async/await),自动生成 OpenAPI 接口文档,是构建微服务和大模型模型推理接口的首选。 - Flask:轻量级微框架,扩展性极高,常用于轻量级服务或高度定制化的中间件开发。
- 周边生态:关系型数据库(MySQL / PostgreSQL)、内存缓存(Redis)、异步任务队列(Celery + RabbitMQ)、容器化部署(Docker)。
二、数据方向:从底层采集、加工到商业智能决策
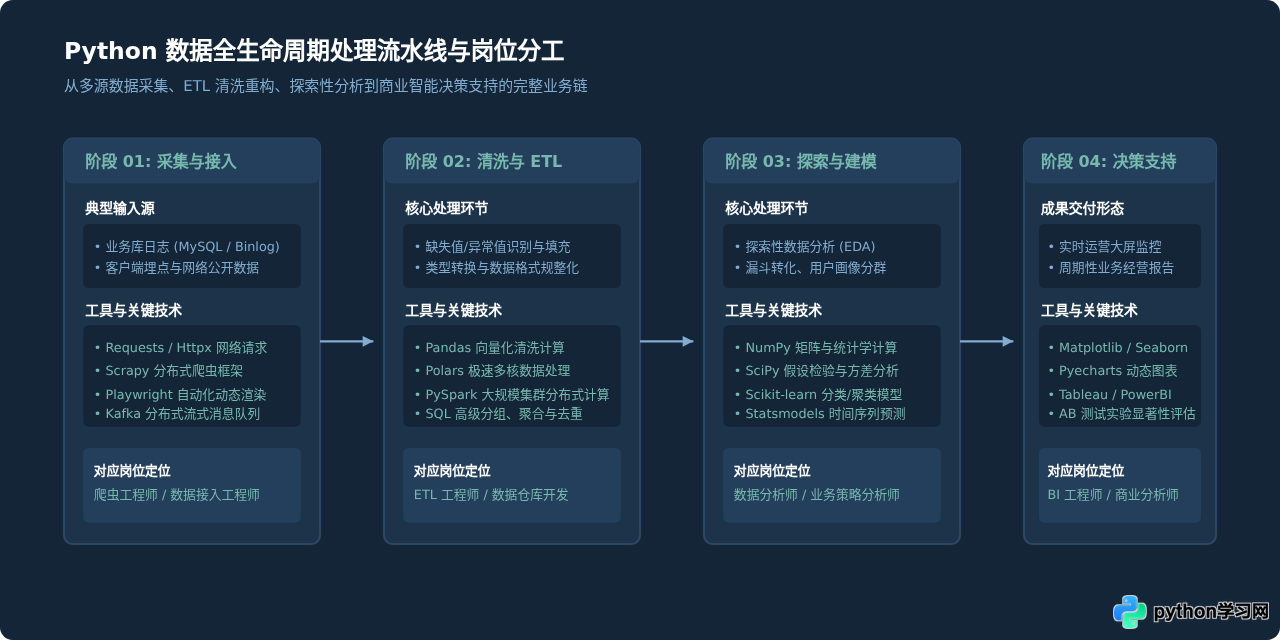
数据领域是 Python 最稳固且需求量最大的基本盘。Python 凭借其简洁的胶水语言特性以及底层的 C/C++ 加速库,构建了全世界最繁荣的数据处理工具链。在就业市场中,数据方向并非单一岗位,而是覆盖从底层数据流转到顶层业务决策的多层次体系。
1. 细分岗位与工作职责
- 数据分析师(Data Analyst / BI 工程师):以业务需求为驱动,运用 SQL 与 Python 对海量用户行为、交易记录进行清洗、聚合与统计建模。核心产出是数据看板、漏斗分析报告、归因分析以及 AB 测试实验评估。
- 数据开发 / ETL 工程师:负责将分散在各业务系统、第三方平台中的原始数据通过管道抽取、清洗并写入数仓(Data Warehouse)或数据湖,保证数据产出的准时性与一致性。
- 网络爬虫 / 数据采集工程师:针对公开网络资源进行规模化合规采集,应对 JS 逆向、字体混淆、验证码识别及反爬代理池建设,完成反解析后结构化入库。
2. 核心技术栈与实操要求
从事数据方向必须跨越“语法掌握”到“数据思维与性能优化”的鸿沟:
- 数据处理三剑客:
NumPy负责底层向量化运算;Pandas是结构化表格数据处理的核心,必须深入理解矢量化操作(Vectorization),杜绝在数据量超百万行时依然使用低效的iterrows()遍历;Polars作为新一代高性能多线程数据分析框架也正在快速普及。 - SQL 能力:无论求职数据分析还是数据开发,SQL 的熟练度在技术面试中权重往往高于 Python。需要熟练编写窗口函数(
ROW_NUMBER(),RANK(),LEAD/LAG)、复杂多表关联、CTE 通用表表达式,并具备执行计划分析与索引调优能力。 - 可视化与 BI 工具:使用 Matplotlib 与 Seaborn 绘制统计学图表,或使用 Pyecharts 构建交互式图表;结合企业级 BI 工具(Tableau, PowerBI, FineBI)呈现核心运营指标。
三、AI 与算法方向:从底层模型研究到大模型工程落地
人工智能方向是当前技术讨论度最高、薪资空间诱人但技术与学历门槛也最为分明的领域。在过去的深度学习时代,算法岗位普遍要求名校硕博与顶会论文;而随着大语言模型(LLM)的爆发,行业中迅速分化出以“工程落地”为核心的新型开发岗位,降低了对纯底层数学推导的严苛门槛,更看重工程架构能力。
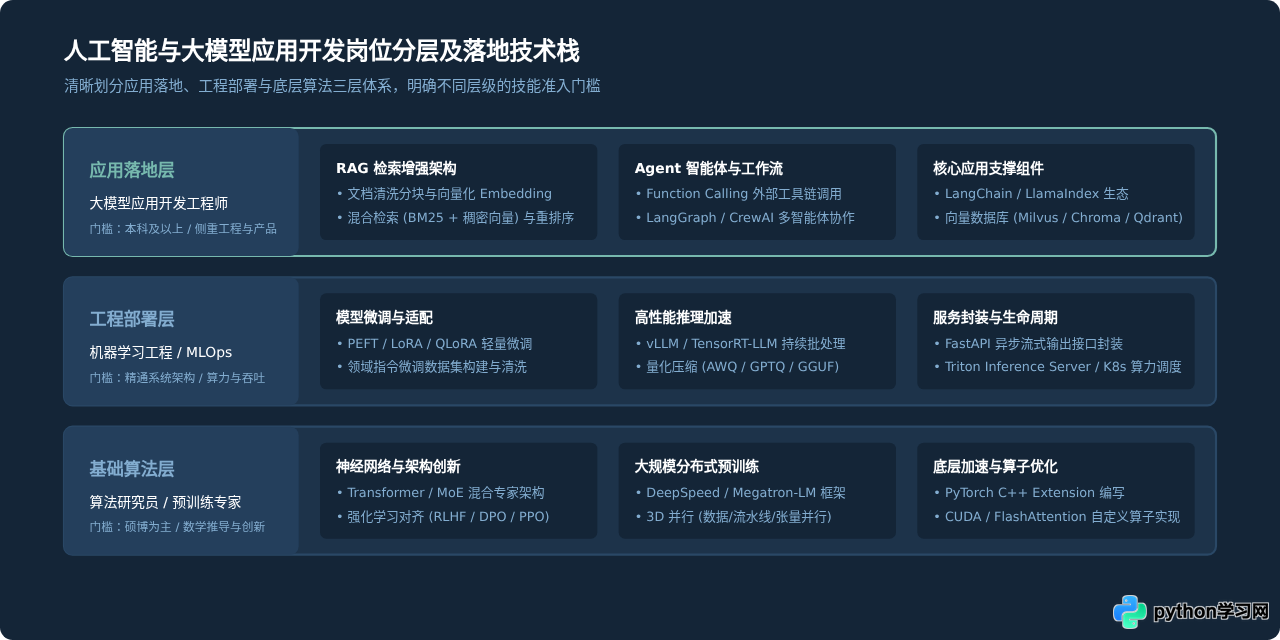
1. 细分岗位与技术分层
- 算法研究员 / 核心算法工程师:聚焦于模型结构的创新、预训练(Pre-training)、基础大模型的研发与数学优化。对数学、概率统计、论文复现及底层算子(CUDA / C++)优化有极高要求,主要吸纳顶尖硕博人才。
- 机器学习工程 / MLOps 工程师:负责将算法团队训练完成的模型工程化上线。核心职责包括模型格式转换(ONNX / TensorRT)、推理加速部署、在线服务封装与监控回流。
- 大模型应用开发工程师(LLM Application Engineer):当前招聘需求最为旺盛的新兴岗位。利用开源或商业大模型能力,结合 Python 生态完成企业垂直业务场景落地。核心技术包括 RAG(检索增强生成)、向量数据库调优、Agent 智能体规划与工作流编排。
2. 核心技术栈与实操要求
从事 AI 方向的技术积累应当围绕目标层级展开:
- 深度学习底座:
PyTorch已经成为学术界与工业界的事实标准,必须掌握张量操作、自动求导(Autograd)、DataLoader 编写及分布式训练基础(DDP)。 - 大模型核心工具:掌握 Hugging Face 生态(
Transformers,Datasets,PEFT,Accelerate),熟悉主流开源模型(如 Llama、Qwen)的轻量化微调技术(LoRA / QLoRA)。 - 应用层框架与向量数据库:掌握
LangChain或LlamaIndex构建多步推理管道;掌握向量检索与嵌入机制(Embedding),熟练使用 Milvus、Chroma 或 Qdrant 完成文档分块与混合检索(Hybrid Search);熟练掌握基于 FastAPI 的流式响应输出(Server-Sent Events)。
四、方向抉择:不同专业背景与求职周期的适配策略
许多初学者容易犯的典型错误是试图“全都要”——上午写 Django,下午看数据清洗,晚上硬啃深度学习数学推导。求职市场更看重候选人在特定领域的技术深度。根据自身背景合理匹配方向,能大幅提高简历筛选与技术面试的通过率。
1. 如果具备扎实的计算机网络、操作系统基础,喜欢设计清晰的 API、构建稳定高可用系统,选择 Web 后端开发 是最扎实的路径;
2. 如果具备统计学、金融学、市场营销等跨学科背景,对业务指标波动高度敏感,擅长用数据讲故事,优先选择 数据分析 / BI 工程师;
3. 如果具备良好的学术科研底子与数理推导能力(理工科硕博),且对前沿模型演进充满热情,可以主攻 基础算法岗;如果是统招本科且工程编码能力出色,转型 大模型应用开发 / RAG 工程师 是性价比极高的新赛道。
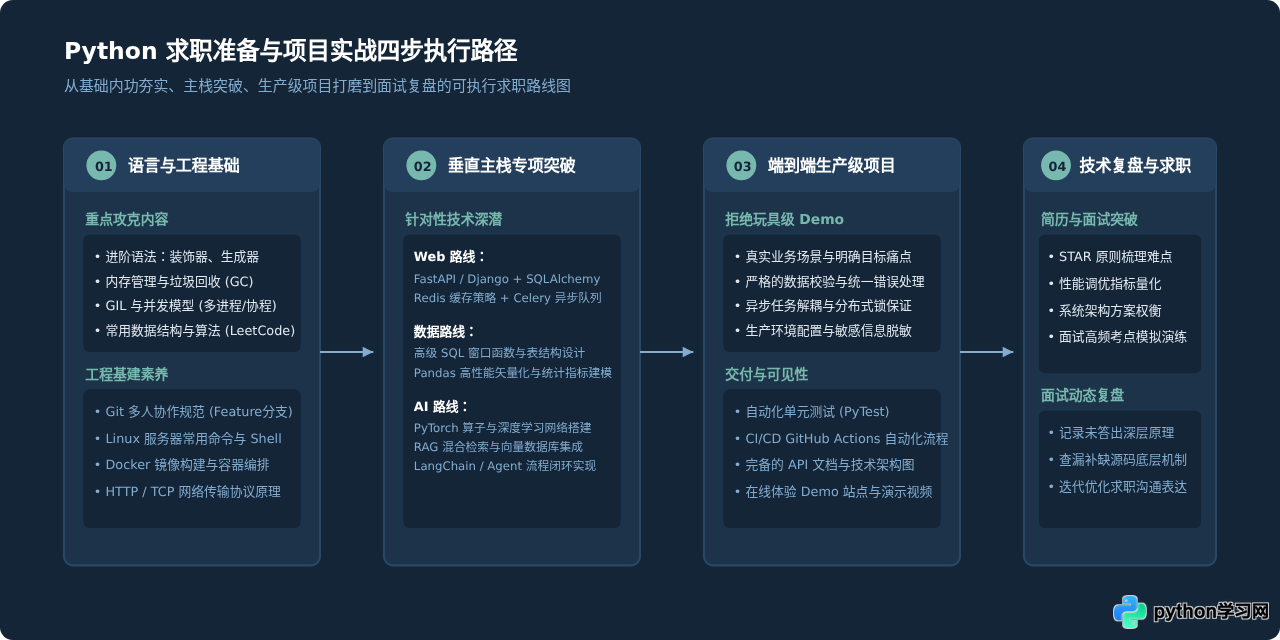
五、求职落地:从基础夯实到实战产出的四步路线
无论选择上述哪个方向,单凭网课视频的“随堂练习”无法打动技术面试官。企业招聘的核心逻辑是评估候选人能否独立接手实际业务需求。遵循以下四个阶段逐步推进,可以建立起具有区分度的求职竞争力。
步骤 1:夯实语言与计算机通用工程基础
深入理解 Python 运行机制,包括内存管理与垃圾回收机制(引用计数 + 分代回收)、装饰器(Decorator)原理、生成器与迭代协议、GIL(全局解释器锁)的工作原理与规避方案。同时补齐 Linux 命令行操作、Git 版本控制与 Docker 容器化打包能力。
步骤 2:主攻单一技术栈核心框架与原理
选定方向后,彻底吃透主框架: Web 方向必须亲手实现过基于 FastAPI 或 Django 的异步鉴权、数据库复杂关联查询; 数据方向必须能熟练用纯 SQL 和 Pandas 处理分组统计、去重排重与漏斗分析; AI 方向必须跑通本地大模型微调流程,并理解 LoRA 矩阵秩分解的数学含义。
步骤 3:独立构建一个具备工程规范的生产级项目
杜绝简历上充斥“图书管理系统”、“Titanic 生存率预测”等千篇一律的模板项目。合格的求职项目必须具备三个要素: 明确的业务背景与难点定义(如:高并发缓存穿透解决方案、海量文档混合检索准确率优化、亿级日志多维聚合查询调优); 工业级的代码组织(分层解耦、类型注解、单元测试 Coverage、异常捕获规范); 完备的部署与上线验证(附带 Dockerfile、API 文档在线预览或演示系统)。
步骤 4:技术复盘与高频面试考点专项攻坚
针对选定方向的高频考核点进行针对性自查。例如 Web 方向的“三次握手、MySQL 聚簇索引、Redis 持久化 RDB/AOF 对比”;数据方向的“SQL 窗口函数实战、慢查询分析、AB 测试样本量计算”;AI 方向的“Transformer 注意力机制计算公式、向量数据库检索原理、提示词工程与幻觉抑制策略”。
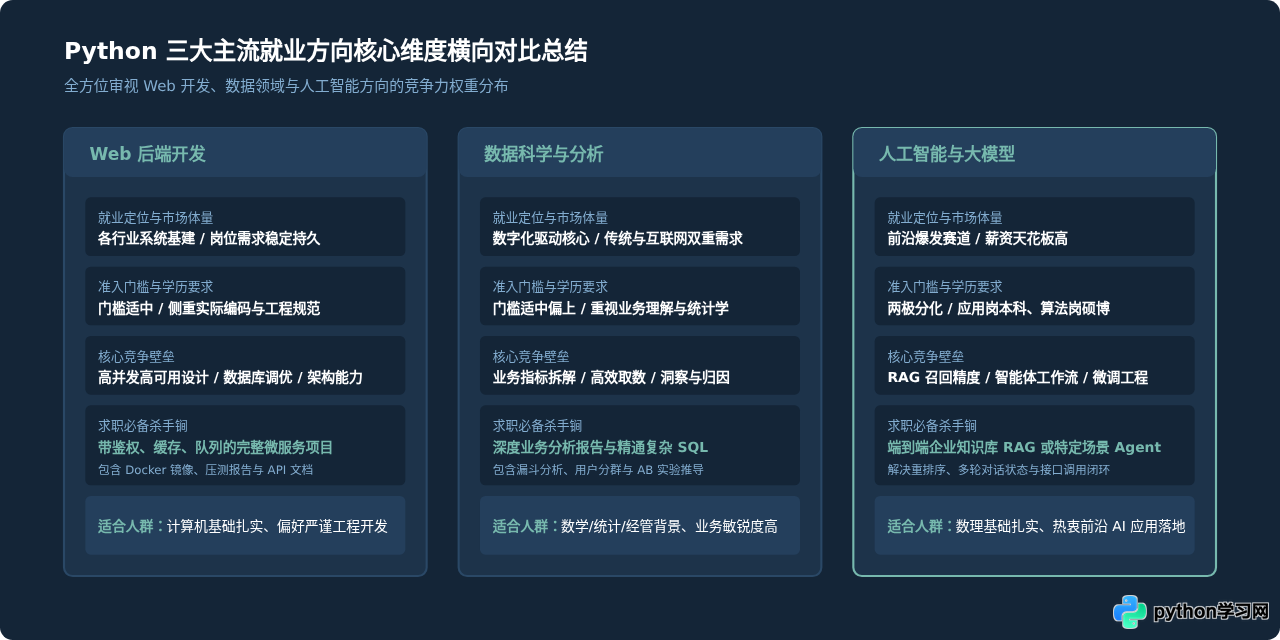
六、三大方向全维度横向对比与总结
为了让不同背景的读者在选型时拥有清晰客观的数据参考,下表汇总了三大就业方向在核心考察重点、入门门槛、招聘需求面及技术天花板等维度的综合对比:
| 对比维度 | Web 后端与服务开发 | 数据科学与数据工程 | 人工智能与大模型应用 |
|---|---|---|---|
| 核心解决问题 | 系统高可用、数据持久化、业务接口高效交付 | 数据清洗入库、业务规律洞察、指标监控与商业决策 | 垂直场景认知增强、多模态智能体、复杂任务自动化 |
| 核心代表技术 | FastAPI, Django, MySQL, Redis, Celery, Docker | SQL, Pandas, NumPy, Scrapy, Tableau, PySpark | PyTorch, LangChain, Transformers, Milvus, LoRA |
| 数理门槛 | 低(重在逻辑严谨性与系统架构思维) | 中等(需掌握统计学推断、概率论、假设检验) | 中高至极高(应用岗需逻辑链梳理,算法岗需矩阵与概率论) |
| 学历与专业倾向 | 统招专科/本科,重实际编程能力与工程规范 | 统招本科及以上,理工科、统计学、经管类皆可转 | 应用岗统招本科;核心算法与预训练岗普遍要求名校硕博 |
| 招聘需求特征 | 需求量基础稳定,中小企业与大厂各业务线均有设立 | 覆盖各行各业,数字化转型传统企业需求广泛 | 行业热度极高,新型 AI 初创团队与大厂重点扩招 |
| 常见技术考核难点 | 高并发接口优化、数据库事务锁、缓存雪崩/击穿/穿透 | 复杂 SQL 关联与窗口函数、海量数据去重、数据倾斜处理 | RAG 文档召回精度调优、长上下文抗幻觉、微调参数配比 |
学习 Python 的最终目的是解决实际业务场景中的问题。无论选择深耕业务后端的稳定性、挖掘海量数据背后的商业价值,还是利用前沿大模型赋能智能交互,最忌讳的是走马观花式的浅尝辄止。找准与自身背景最为匹配的跑道,以工程规范和生产级实战项目为牵引,持续沉淀底层原理,便能在竞争激烈的求职市场中脱颖而出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









