

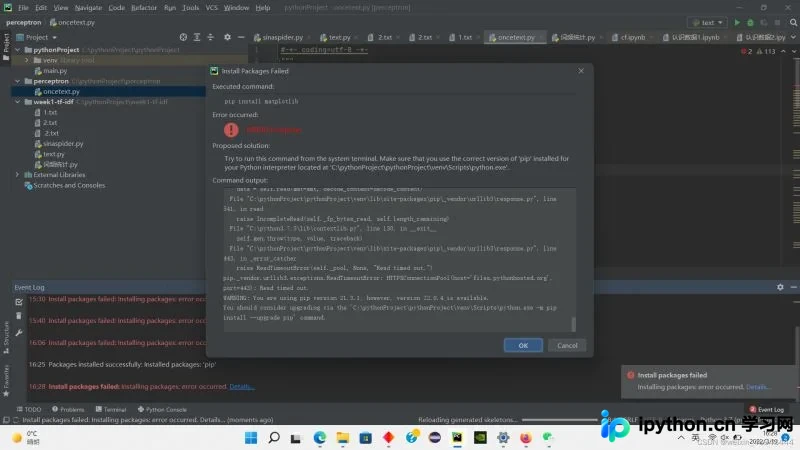
Python 3.7 安装 Matplotlib 失败的排查与解决
本文针对 Python 3.7 环境下安装 Matplotlib 库失败的问题,提供了完整的排查与解决步骤。文章指出在尝试直接安装失败后,通过升级 Pip 至最新版本仍无法解决,随后通过验证版本兼容性并切换至国内清华镜像源,成功完成了安装。此方法适用于 Windows 系统下因网络或版本兼容导致的常见库安装错误。
2026-10-15
7

本文针对 Python 3.7 环境下安装 Matplotlib 库失败的问题,提供了完整的排查与解决步骤。文章指出在尝试直接安装失败后,通过升级 Pip 至最新版本仍无法解决,随后通过验证版本兼容性并切换至国内清华镜像源,成功完成了安装。此方法适用于 Windows 系统下因网络或版本兼容导致的常见库安装错误。
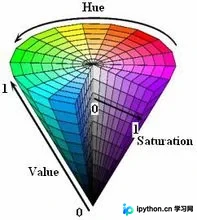
本文介绍如何利用Python和OpenCV进行HSV颜色分割,以交通信号灯检测为例。详细解析HSV模型中H、S、V参数的含义及取值范围,并通过createTrackbar函数实现阈值动态调整,最终生成掩码以提取感兴趣区域,提升识别准确率。
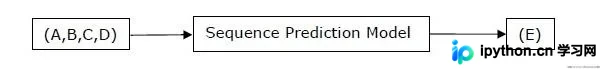
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
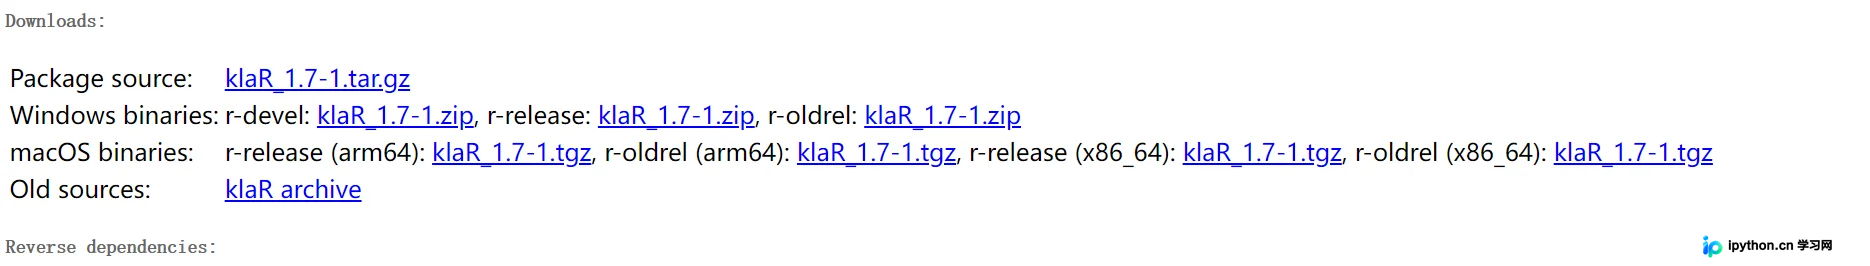
在R语言进行机器学习开发时,常因版本兼容性问题需要手动升级或降级特定包。以解决klaR包报错为例,详细介绍如何通过CRAN Archive安装历史版本,包括卸载旧包、指定tar.gz源码路径及重新安装的全过程,确保模型训练环境稳定。
本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
AutoTS是一个开源Python库,旨在通过一行代码自动化训练ARIMA、SARIMAX、FB Prophet和VAR等多个时间序列模型。它利用遗传规划优化和交叉验证技术,自动处理数据预处理、异常值删除及最佳NaN值学习,从而快速生成最强时序基线模型,适合初学者及需要快速评估多种算法的场景。
本文深入解析最小二乘法的两种核心推导路径:基于代价函数偏导数的代数解法,以及基于向量到子空间距离的几何解释。通过Python与MATLAB代码对比,验证了自定义实现与内置函数polyfit、regress在多项式拟合及多元线性回归中的一致性,展示了从理论到工程应用的完整闭环。
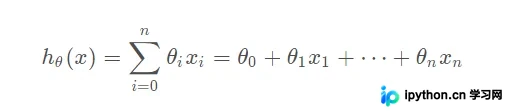
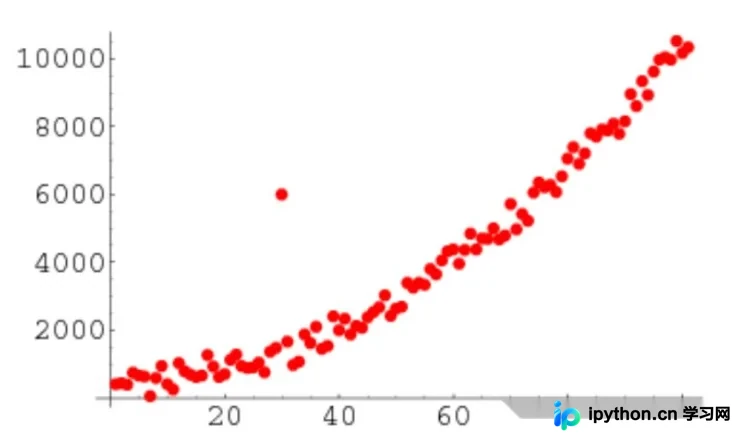
本文详解Python中异常值的定义及两种主流检测方法:基于正态分布的3σ原则和基于四分位距的箱型图法。通过Pandas库对啤酒数据集进行实战演练,展示如何定位并处理如abv字段中的极端离群值,提供完整的代码实现与索引定位技巧,帮助开发者掌握数据清洗核心技能。
本文详细介绍Python中PCA降维的两种实现方式。首先解析PCA将高维数据投影到低维空间以保留最大信息量的原理及标准步骤,随后通过矩阵运算手动实现PCA,并对比使用sklearn库中PCA算法的调用方法。文章涵盖代码解析、可视化结果分析及重构误差说明,帮助开发者掌握特征降维技术。
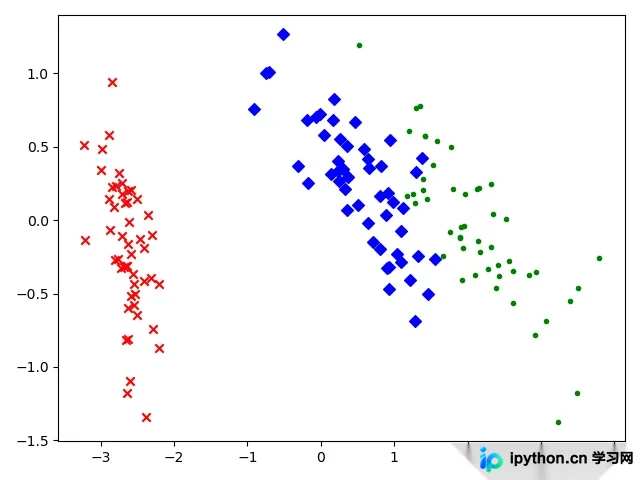
本文详细介绍基于Python的K-Means聚类算法实现。作为典型的无监督学习算法,K-Means通过计算对象间距离来划分紧凑且独立的簇。文章提供了完整的Python代码示例,涵盖算法初始化、迭代优化及可视化预测过程,帮助开发者快速掌握该核心聚类技术。
本文深入探讨Python中从概率分布采样的方法,重点介绍二项、伯努利、多项、均匀及狄利克雷分布。通过具体代码示例,解析各分布的参数设置、函数原型及在实际机器学习场景中的应用,如样本分配与权重生成,帮助开发者掌握核心采样技巧。
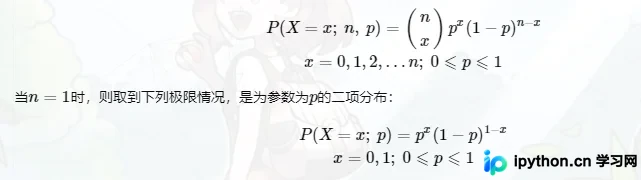
本文深入解析Python中的随机采样机制,涵盖random模块与numpy库的核心函数。详细对比random.choice、random.choices(支持权重与有放回)及random.sample(无放回)的使用场景,并介绍基于Random实例的采样方法。同时解析numpy.random.choice的参数配置,包括权重、大小及替换选项,助你在机器学习数据预处理中精准控制采样逻辑。