

Python主要用来做什么:从Web开发到人工智能的应用场景
全面解析Python的核心应用场景,涵盖Web服务端开发、数据分析与科学计算、人工智能与机器学习,以及自动化脚本与系统运维。结合架构全景、决策路径图及常见认知辨析,帮助读者准确理解Python的技术边界与选型依据。
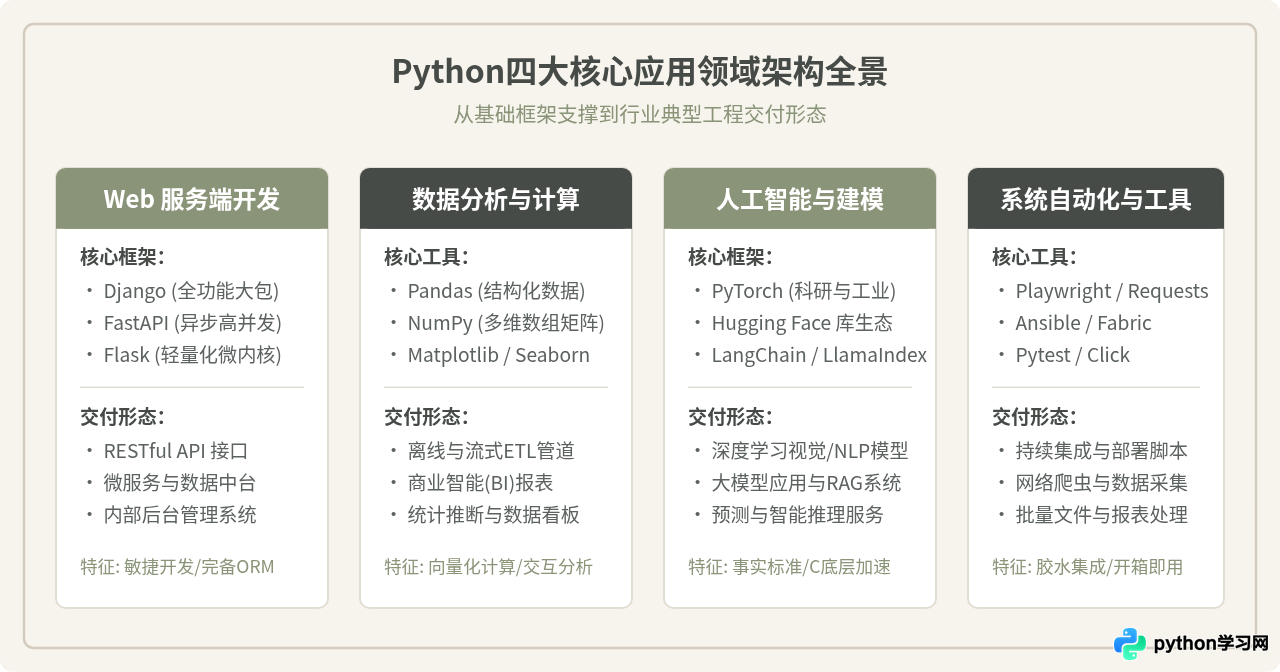
Python 作为当今应用最为广泛的高级编程语言之一,其核心竞争力在于极高的代码表达能力、丰富的标准库以及高度繁荣的第三方生态。从实际工程落地的角度来看,Python 的核心用途主要聚焦在四大支柱领域:Web 服务端开发、数据分析与科学计算、人工智能与机器学习,以及系统自动化与日常运维脚本。了解 Python 在这些场景中的真实运作机制、典型工具链及其适用边界,能够帮助开发者与技术团队做出更为精准的技术选型与工程规划。
一、Web 服务端开发:从轻量 API 到企业中台
在网络后端开发领域,Python 并不依赖执行原始 CPU 密集型循环的速度,而是依托清晰的业务抽象能力和高效的 I/O 处理机制。现代 Web 应用绝大部分的时间消耗集中在数据库查询、外部网络请求以及磁盘读写上,Python 凭借成熟的生态能以极低的编码心智成本快速交付稳定可靠的服务。
1. 主流 Web 框架定位
- Django:采用“全功能自带电池(Batteries-Included)”理念,内置完善的对象关系映射(ORM)、管理员后台、身份认证系统及防跨站安全防护。非常适合业务逻辑复杂、需要快速搭建完整前后端管理后台的企业级应用。
- FastAPI:基于 Python 原生类型注解与 ASGI(异步服务器网关接口)规范,利用 Pydantic 进行请求验证并自动生成 OpenAPI/Swagger 规范文档。其高吞吐的异步特性使其成为当前构建高并发微服务和 AI 推理接口的首选。
- Flask:以精简内核和高度灵活的扩展机制著称,允许开发者按需自由组合数据库驱动与鉴权方案,适合中小型微服务、内部轻量原型及高度定制化的中间件系统。
2. FastAPI 异步接口落地示例
以下为一个基于 FastAPI 编写的标准数据查询与模型预测代理接口,演示了类型提示、异步 I/O 及结构化响应的实现方式:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
import asyncio

app = FastAPI(title="业务推理服务示例")

class QueryPayload(BaseModel):
    query_id: str
    feature_vector: list[float]

class QueryResponse(BaseModel):
    query_id: str
    status: str
    score: float

@app.post("/api/v1/predict", response_model=QueryResponse)
async def predict_endpoint(payload: QueryPayload):
    if not payload.feature_vector:
        raise HTTPException(status_code=400, detail="特征向量不能为空")

    # 模拟异步数据库查询或非阻塞外部调用
    await asyncio.sleep(0.05)

    # 业务规则或轻量计算
    calculated_score = sum(payload.feature_vector) / len(payload.feature_vector)

    return QueryResponse(
        query_id=payload.query_id,
        status="success",
        score=round(calculated_score, 4)
)生产部署注意点:运行 Python Web 服务时,切勿在生产环境直接使用 python main.py 的单进程开发模式。标准做法是使用 Gunicorn 配合 Uvicorn Worker 组成多工作进程池(Multi-Process Worker Model),以此充分利用多核服务器的物理计算资源。
二、数据分析与科学计算:业务洞察与量化决策
在商业智能、金融量化及学术研究领域,Python 早已取代多种传统工具成为数据处理的事实标准。Python 之所以能在计算密集的数据领域脱颖而出,根本原因在于其底层的 C/Fortran 向量化绑定机制:开发者编写高层 Python 语法,而底层的矩阵运算直接交由预编译的高度优化数学库执行。
1. 核心数据工具链
- NumPy:提供高性能的 N 维数组对象(
ndarray)以及广播运算(Broadcasting),是所有科学计算库的底层基石。 - Pandas:提供类似于电子表格或 SQL 表的
DataFrame数据结构,具备极强的数据清洗、时间序列处理、分组聚合(GroupBy)与缺失值填充功能。 - Matplotlib 与 Seaborn:用于将统计结果转化为专业图表,支持直方图、热力图、散点矩阵等多样化图元呈现。
以下示例展示了使用 Pandas 完成电商订单数据清洗、按品类汇总销售额并计算客单价的典型流水线:
import pandas as pd

# 读取原始数据集
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "category": ["电子数码", "日用百货", "电子数码", "书籍文具", "日用百货"],
    "amount": [1299.0, 45.5, 2499.0, 88.0, 120.0],
    "is_paid": [True, True, True, False, True]
}

df = pd.DataFrame(raw_data)

# 数据清洗:仅保留已支付订单
paid_orders = df[df["is_paid"] == True].copy()

# 分组聚合:计算每个品类的总销售额与平均客单价
category_summary = paid_orders.groupby("category")["amount"].agg(
    total_sales="sum",
    avg_ticket="mean",
    order_count="count"
).reset_index()

# 示例输出查看
print(category_summary)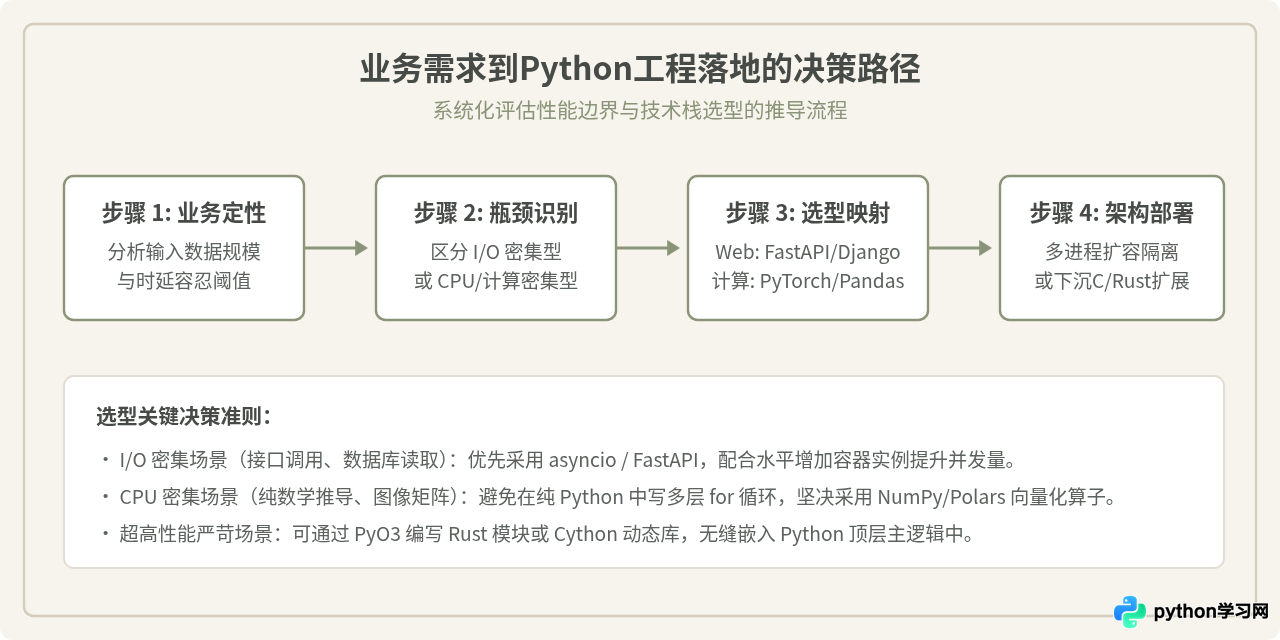
三、人工智能与机器学习:从底层算法到大模型应用
如果说科学计算奠定了 Python 的数学根基,那么人工智能的爆发则将 Python 推上了科技工业的舞台中央。今天,全球绝大多数前沿的深度学习架构、开源大模型(LLM)以及计算机视觉算法,均以 Python 作为第一交互界面。
1. 为什么 Python 能够垄断 AI 领域?
很多初学者会产生疑问:既然 Python 运行效率不如 C++,为何 AI 没有全面采用 C++ 编写?其技术真相在于“计算在下,控制在上”的双层软件设计架构:
- 高性能底层(Heavy Lifting):张量乘法、卷积运算与反向传播求导等严苛计算,全部由 C++、CUDA 与特定硬件驱动(如 cuDNN)实现。
- 高层胶水层(Orchestration):Python 负责定义网络拓扑结构、编排训练数据流水线、调整超参数并监控指标。这种分工让算法工程师免于陷入内存手动分配和底层编译细节,大幅缩短了实验迭代周期。
2. 核心技术框架与生态
- PyTorch:由 Meta 主导开源,采用动态计算图(Dynamic Computation Graph),调试直观方便,是当今科研学术界与产业大模型预训练的事实标准。
- scikit-learn:经典机器学习工具包,涵盖随机森林、支持向量机(SVM)、K-means 聚类等标准算法,广泛用于风控、预测与特征工程。
- Hugging Face 生态:提供
transformers、datasets等模块,极大降低了对 BERT、Llama 等开源前沿大模型的微调(Fine-Tuning)与部署门槛。 - 应用编排(LangChain / LlamaIndex):连接检索增强生成(RAG)管道、向量数据库(Vector DB)与智能体(Agent)工作流,是当前大语言模型落地应用的核心框架。
四、自动化脚本与系统集成:工程提效的通用利器
除了大规模后端与算法训练,Python 最接地气的定位是“胶水语言”与系统级瑞士军刀。在任何需要整合异构系统、消除重复机械劳动、批量转换格式或做自动化验证的场景,几行简洁的 Python 脚本往往能节省大量人力。
1. 典型应用分支
- 网络数据采集与爬虫:利用
Requests抓取结构化 API 数据,或通过Playwright/Selenium驱动无头浏览器渲染动态 JavaScript 页面。 - 自动化测试:以
Pytest为核心构建单元测试、接口端到端集成测试,支持参数化测试与灵活的 Fixture 依赖注入。 - 跨平台运维自动化:通过
Ansible编写声明式剧本完成成百上千台服务器的环境部署,或使用Paramiko建立安全 SSH 隧道批量执行指令。 - 办公自动化与文档转换:利用
OpenPyXL自动化批量读写 Excel 报表,或利用pdfplumber提取合同与账单中的表格内容。
五、适用边界与技术选型辨析
为了在实际工程中做出理性决策,必须客观看待 Python 的能力边界,不盲信“万能论”,也不因纯语言性能数字而对其产生轻视。
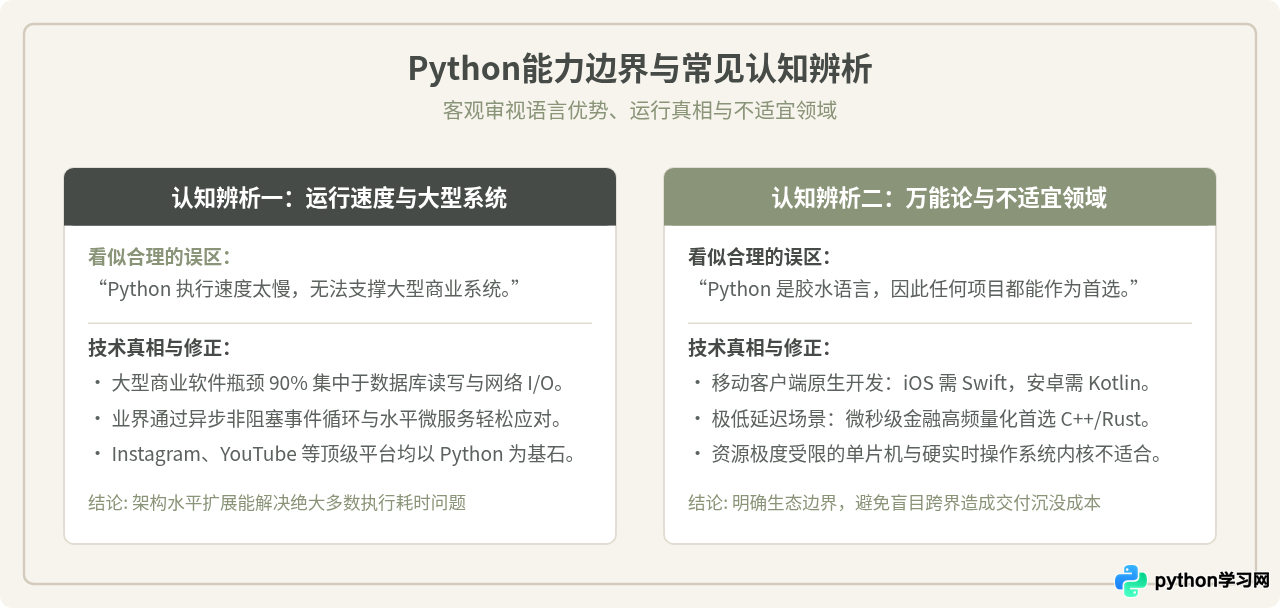
1. 为什么“Python 运行慢”在大部分业务中不是致命伤?
许多初学者或从静态语言转来的工程师常以 Micro-benchmark(微基准测试)中的数十倍性能差异否定 Python。这一判断在逻辑上忽略了生产系统的实际运行架构:
- I/O 耗时远大于 CPU 解释耗时:一次跨可用区的数据库查询通常需要 2 至 10 毫秒,网络往返需要数十毫秒;而 Python 解析几十行路由逻辑仅需几十微秒。耗时的大头在于 I/O 等待,而非语言解释器本身。
- 开发与试错成本是更大的经济指标:在互联网与数字化业务中,能否在两周内验证一个商业模型,远比让单台机器节省 10% 的 CPU 利用率更有商业价值。Python 带来的极高研发交付效率能够为团队争取宝贵的市场窗口期。
- 热点模块下沉策略:当真正遇到性能瓶颈时,业内标准方案是采用“80/20 法则”——仅将那 5% 的关键计算循环使用 Rust(借助 PyO3)或 C++ 重新封装为扩展模块,顶层依旧保留 Python 的敏捷调用能力。
2. 明确不推荐使用 Python 的场景
以下场景由于硬件架构、运行时环境或实时性硬指标的限制,Python 并不是首选方案:
- 移动端原生 App 开发(iOS 与 Android):虽然存在 Kivy 或 BeeWare 等打包方案,但在安装包体积、启动性能、电池功耗以及原生 UI 控件渲染方面,与 Swift/SwiftUI、Kotlin/Compose 或跨端的 Flutter 相比差距明显。
- 大型 3D 商业游戏引擎核心:顶级 3D 游戏(如虚幻引擎项目)要求极高帧率下的稳定内存控制和无停顿垃圾回收,必须使用 C++。Python 在游戏工业中主要充当关卡策划工具、自动化打包管线及后端脚本。
- 微秒级低延迟金融高频交易(HFT):在对网络跳步和指令周期敏感的高频撮合场景中,垃圾回收(GC)引起的延迟抖动是无法容忍的,业界普遍选用 C++、Rust 或经过特化的 Java。
- 内存严重受限的硬实时嵌入式硬件:单片机仅有数十 KB 内存时,即便是 MicroPython 也难以胜任高严格的硬实时控制任务,此时 C 语言依然是唯一选择。
六、总结与落地建议
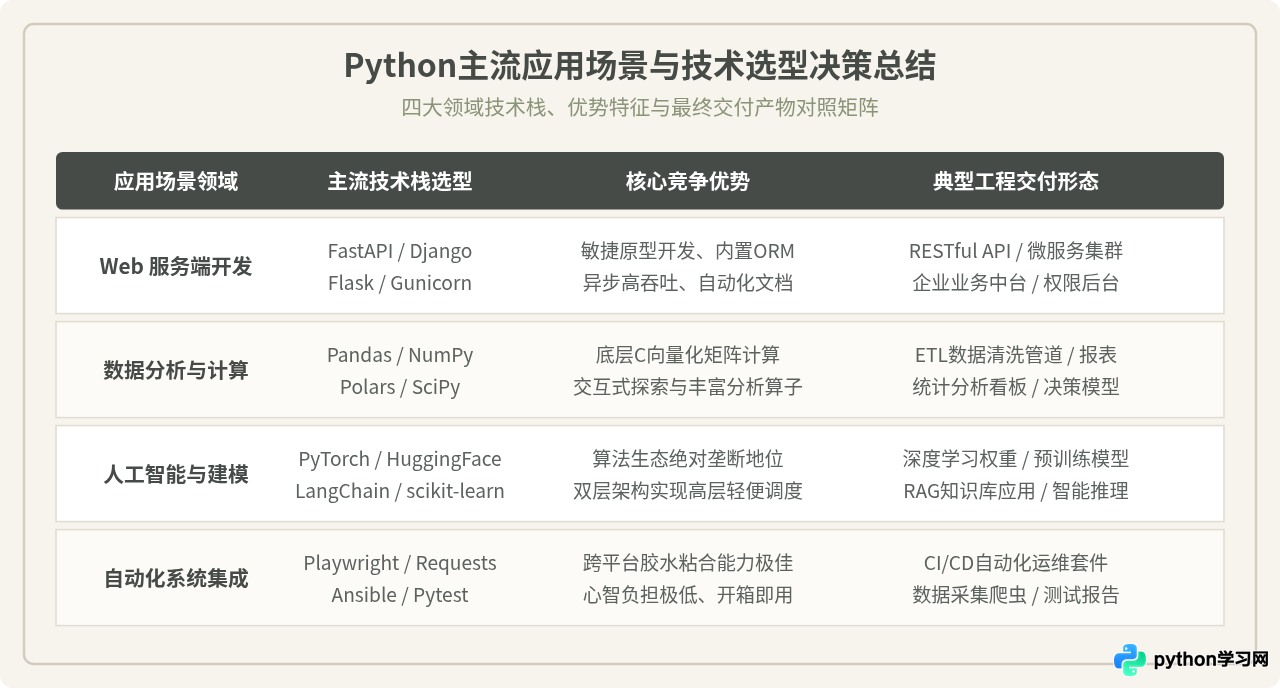
回答“Python 主要用来做什么”,本质上是回答在当今的软件工程体系中,如何利用有限的人力最大化技术产出。Python 并不是在所有性能指标上都拔得头筹的语言,但它凭借强大的语言表现力和近乎无所不包的开源库,在 Web 服务构建、数据深度分析、人工智能算法研究与工程自动化 四大领域建立了牢不可破的生态壁垒。
对于技术团队和学习者而言,理解 Python 的应用场景不应停留在语法层面,而应关注其生态链工具的具体用法与业务适配度:在重视高并发与规范的接口场景选择 FastAPI,在需要快速沉淀业务数据时采用 Pandas,在接入智能化功能时以 PyTorch 和大模型生态为支点,并利用轻量脚本完成工作流的无缝串联。明确其优势与边界,方能在工程实践中最大限度发挥这门语言的效能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









