

神经网络基础与Python实现:从结构到反向传播算法详解
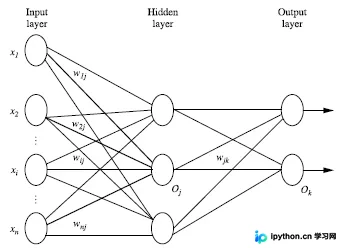
本文详细解析多层前向神经网络的结构设计、交叉验证方法及反向传播(BP)算法原理。通过Python代码示例,展示如何使用NumPy实现包含tanh和sigmoid激活函数的神经网络,涵盖权重初始化、前向传播、误差反向传递及权重更新全过程,帮助读者掌握神经网络核心机制。
2026-10-12
6

本文详细解析多层前向神经网络的结构设计、交叉验证方法及反向传播(BP)算法原理。通过Python代码示例,展示如何使用NumPy实现包含tanh和sigmoid激活函数的神经网络,涵盖权重初始化、前向传播、误差反向传递及权重更新全过程,帮助读者掌握神经网络核心机制。
本文详细介绍Python中K均值聚类的具体实现代码,涵盖数据集加载、欧几里得距离计算、质心初始化及迭代优化过程。通过二分K均值和地理聚类实例,展示如何生成散点图并可视化聚类结果,帮助读者深入理解算法原理与编程实践。
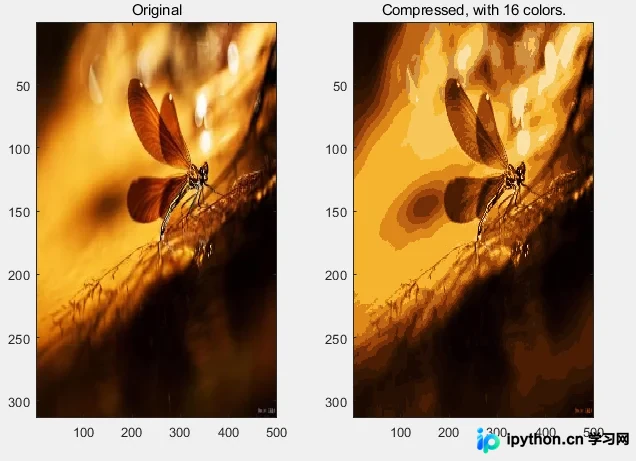
本文深入解析K-Means聚类算法的核心原理,涵盖初始化簇中心、簇分配及中心移动三个关键步骤,并探讨如何通过减少颜色数量实现图片压缩。文章提供Python环境下的完整代码示例,帮助开发者理解并应用K-Means进行数据降维与图像优化。
本文详细介绍Python科学计算库numpy的核心概念。内容涵盖ndarray与list的区别、多种数组创建方法(如empty、arange、zeros、ones、diag),演示数组间的加减乘除运算规则,并深入解析广播机制在多维数组计算中的应用,帮助读者掌握numpy基础操作。
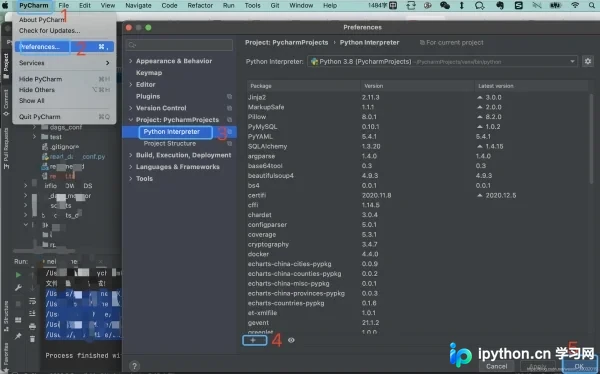
本文系统介绍Python数据分析生态中的七个核心库,涵盖NumPy、SciPy、Pandas、Scikit-learn及Matplotlib等可视化工具。详细解析各库功能特性,并提供Anaconda发行版、pip命令及PyCharm环境下的多种安装指南,最后通过NumPy的vdot函数示例展示基础应用,助力开发者快速构建数据处理工作流。
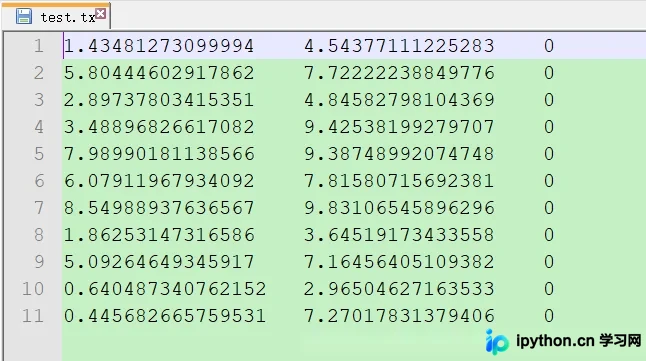
本文介绍在Python中加载数据文件的两种实用方法,分别使用内置open()函数和pandas库的read_csv()功能。通过实例演示如何读取特征和标签数据,比较结果一致性,适用于机器学习等数据密集型任务的预处理环节。
针对分类模型排序质量的评估需求,本文详细解析ROC曲线与AUC指标的计算原理,提供基于Python与sklearn库的完整实现方案。通过导入鸢尾花数据集、执行标签二值化与One-vs-Rest策略训练线性SVM模型,代码可直接输出ROC曲线图及对应的AUC评分,帮助快速验证模型在不同阈值下的泛化性能。
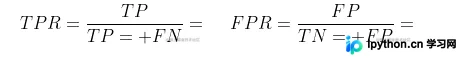
本文详解Python中Logistic回归算法的实现。通过Sigmoid函数处理分类问题,分别演示了批量梯度上升算法与随机梯度下降算法的代码实现。重点解析了权重更新逻辑、学习率调整策略及决策边界的可视化方法,帮助读者理解算法原理与代码细节。
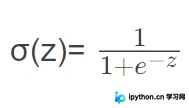
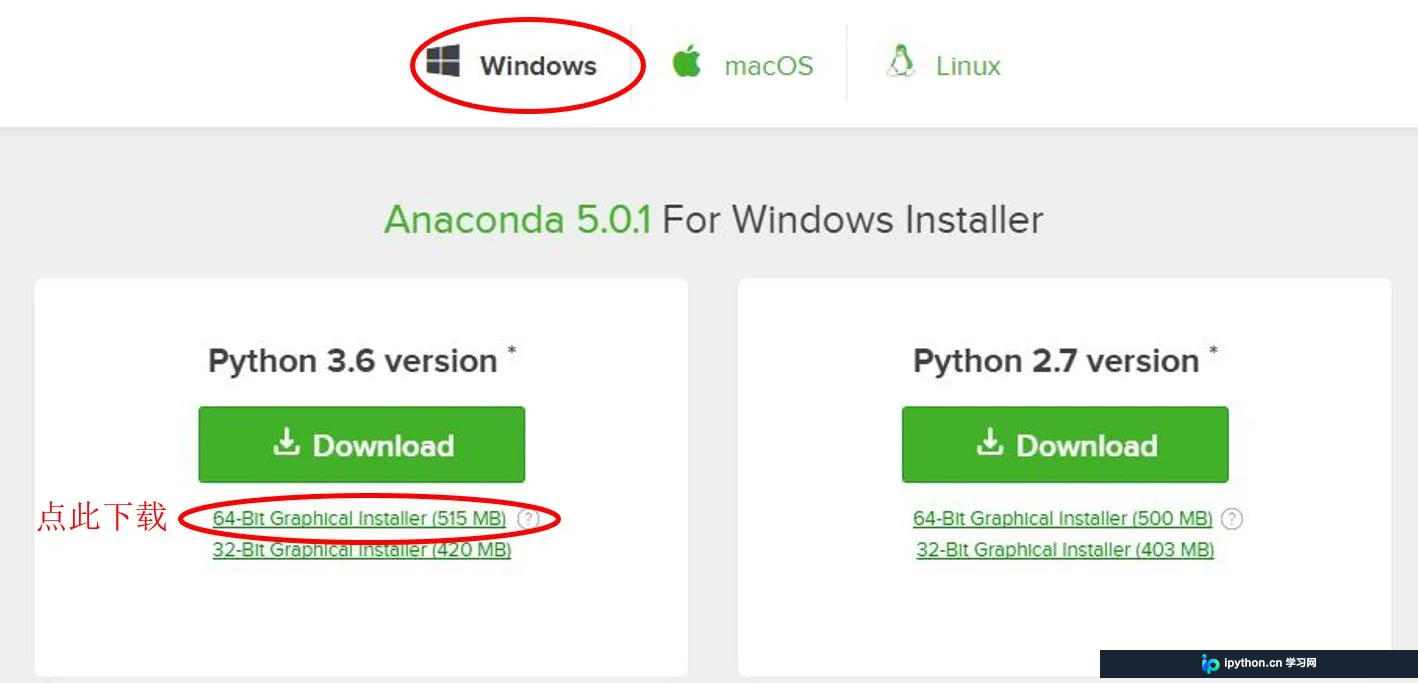
本文详细讲解在Windows系统中安装和配置Anaconda与PyCharm的步骤。从下载、安装到环境管理,再到IDE的配置与项目创建,提供完整的操作指南,帮助用户快速搭建Python开发环境。
本文深入解析Python成为人工智能与数据科学首选语言的原因。从开发效率、开源生态到CPython的胶水特性,详细阐述Python如何通过C/C++底层优化实现高性能计算,以及NumPy等核心库在简化开发中的关键作用。
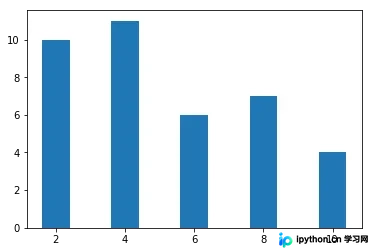
本文介绍了数据科学领域最核心的三个Python库:NumPy、Pandas和Matplotlib。NumPy提供高效的多维数组计算能力;Pandas通过DataFrame处理结构化数据;Matplotlib则负责生成各类可视化图表。文章包含具体的代码示例,展示了如何创建数据框并绘制条形图,帮助开发者快速上手Python数据分析。
本文介绍如何使用 TensorFlow 实现一个简单的逻辑回归模型。通过定义占位符、变量、损失函数及优化器,演示了从数据生成到模型训练的全过程。代码包含权重初始化、Sigmoid 激活函数应用及 Adam 优化器配置,并附带训练误差曲线可视化,帮助理解逻辑回归在分类任务中的基本实现原理。