

神经网络基础与Python实现:从结构到反向传播算法详解

本文详细解析多层前向神经网络的结构设计、交叉验证方法及反向传播(BP)算法原理。通过Python代码示例,展示如何使用NumPy实现包含tanh和sigmoid激活函数的神经网络,涵盖权重初始化、前向传播、误差反向传递及权重更新全过程,帮助读者掌握神经网络核心机制。
一、多层前向神经网络
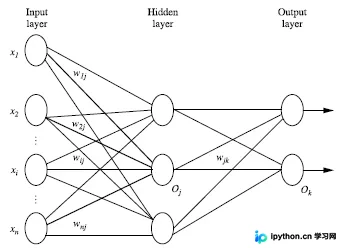
多层前向神经网络架构主要包含输入层、隐藏层和输出层,每一层由多个神经元单元构成。
训练集中的实例特征向量作为输入层的数据传入,通过连接节点的权重传递至下一层,前一层的输出即作为下一层的输入。隐藏层的数量可以任意设定,但输入层和输出层通常各只有一层。
若除去输入层外,隐藏层与输出层的总层数为n,则该网络被称为n层神经网络。例如,包含一个隐藏层和一个输出层的网络即为2层神经网络,具体结构可参考相关示意图。
在每一层中,数据经过加权求和,并通过非线性方程进行转换以生成输出。理论上,只要拥有足够多的隐藏层和足够大的训练数据集,神经网络可以模拟任意复杂的方程。
二、设计神经网络结构
在使用神经网络之前,必须明确确定网络的层数以及每一层中神经元单元的具体数量。
为了加速学习收敛过程,在将特征向量传入输入层之前,通常需要对数据进行标准化处理,将其缩放到0到1的区间内。
对于离散型变量,可以采用编码方式,使每个输入单元对应特征值的一个可能取值。
例如,若特征A有三个可能的取值(a0, a1, a2),则可以使用3个输入单元来表示该特征。
具体编码规则如下:若A取值为a0,则代表a0的单元输出1,其余单元输出0;若A取值为a1,则代表a1的单元输出1,其余为0;若A取值为a2,则代表a2的单元输出1,其余为0。
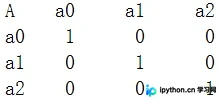
神经网络既可用于解决分类(classification)问题,也可用于回归(regression)问题。对于二分类问题,可使用一个输出单元,通过0和1分别表示两个类别;对于多分类问题,每个类别对应一个输出单元,因此输出层的单元数量通常等于类别的数量。
目前并没有明确的规则来确定最佳隐藏层数量,通常需要通过实验测试误差和准确率来不断调整和优化网络结构。
三、交叉验证方法
如何计算模型的准确率?最简单的方法是将数据集划分为训练集和测试集,利用训练集训练模型,然后将测试集输入模型得到预测结果,最后将预测结果与真实标签对比以计算准确率。
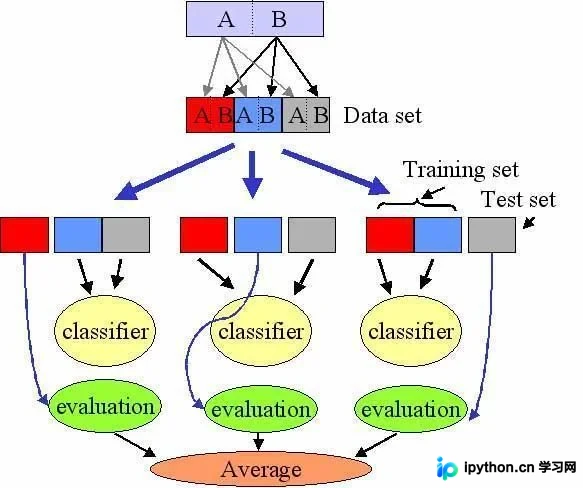
在机器学习领域,交叉验证是一种常用的评估方法。这种方法不将数据简单分为两份,而是可能将其分为10份。
具体操作如下:第1次迭代中,第1份作为测试集,剩余9份作为训练集;第2次迭代中,第2份作为测试集,剩余9份作为训练集;依此类推。
经过10次训练后,得到10组准确率,计算这10组数据的平均值作为最终的平均准确率。这里的10只是一个特例。在一般意义上,将数据分为k份,称为K-fold交叉验证(K-fold cross validation),即每次选择k份中的一份作为测试集,剩余k-1份作为训练集,重复k次,最终得到平均准确率,这是一种较为科学准确的评估方法。
四、BP算法(反向传播算法)
该算法通过迭代方式处理训练集中的实例。
首先计算经过神经网络预测后的值与真实值之间的误差。
然后从输出层向隐藏层、再向输入层的方向(反向)最小化误差,并据此更新每个连接节点的权重。
4.1、算法详细介绍
输入参数包括:数据集、学习率、以及一个多层神经网络的架构;输出结果为:一个训练好的神经网络模型。
首先初始化权重和偏置:通常随机初始化为-1到1之间的值(或其他范围),每个单元包含一个偏置项。对于每一个训练实例X,执行以下步骤:
1、由输入层向前传送数据:
结合神经网络的结构示意图进行分析:
从输入层到隐藏层的计算过程如下:
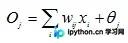
从隐藏层到输出层的计算过程如下:
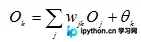
通过上述两个公式进行总结,可以得到通用的层间传递公式。
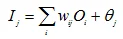
其中,Ij表示当前层的单元值,Oi表示上一层的单元值,wij表示连接两层单元之间的权重值,sitaj表示每一层的偏置值。我们需要对每一层的输出进行非线性转换,具体示意图如下。
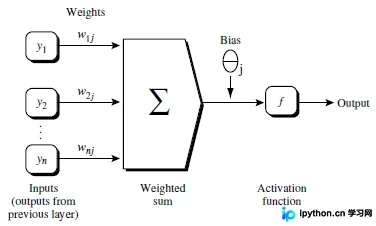
当前层输出为Ij,f为非线性转换函数,也称为激活函数,其定义如下。
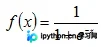
即每一层的输出计算为:

通过上述方式,可以利用输入值正向推导出每一层的输出值。
2、根据误差反向传送:对于输出层,误差计算为其中Tk是真实值,Ok是预测值。
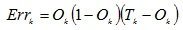
对于隐藏层,误差反向传播的计算公式为:
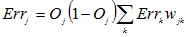
权重更新公式为:其中l为学习率。
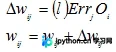
偏置更新公式为:

3、终止条件
满足以下任一条件时算法终止:偏置的更新量低于某个阈值;预测的错误率低于某个阈值;或者达到预设的最大循环次数。
4、非线性转化函数
前文提到的非线性转化函数f,一般情况下可以使用以下两种函数之一。
(1)tanh(x)函数:
tanh(x)的计算公式为sinh(x)/cosh(x),其中sinh(x)=(exp(x)-exp(-x))/2,cosh(x)=(exp(x)+exp(-x))/2。
(2)逻辑函数(Sigmoid),本文示例中使用的即为逻辑函数。
五、BP神经网络的Python实现
首先需要导入numpy模块以支持数值计算。
import numpy as np
定义非线性转化函数,由于后续计算需要用到函数的导数形式,因此将函数及其导数一起定义。
def tanh(x):
  return np.tanh(x)
def tanh_deriv(x):
  return 1.0 - np.tanh(x)*np.tanh(x)
def logistic(x):
  return 1/(1 + np.exp(-x))
def logistic_derivative(x):
  return logistic(x)*(1-logistic(x))
设计BP神经网络的结构(包括层数和每层单元个数),此处采用面向对象的设计思想,主要涉及选择哪种非线性函数以及初始化权重。layers是一个列表,包含每一层的单元数量。
class NeuralNetwork:
  def __init__(self, layers, activation='tanh'):
    """
    :param layers: A list containing the number of units in each layer.
    Should be at least two values
    :param activation: The activation function to be used. Can be
    "logistic" or "tanh"
    """
    if activation == 'logistic':
      self.activation = logistic
      self.activation_deriv = logistic_derivative
    elif activation == 'tanh':
      self.activation = tanh
      self.activation_deriv = tanh_deriv

    self.weights = []
    for i in range(1, len(layers) - 1):
      self.weights.append((2*np.random.random((layers[i - 1] + 1, layers[i] + 1))-1)*0.25)
      self.weights.append((2*np.random.random((layers[i] + 1, layers[i + 1]))-1)*0.25)
实现算法的核心逻辑。
  def fit(self, X, y, learning_rate=0.2, epochs=10000):
    X = np.atleast_2d(X)
    temp = np.ones([X.shape[0], X.shape[1]+1])
    temp[:, 0:-1] = X
    X = temp
    y = np.array(y)

    for k in range(epochs):
      i = np.random.randint(X.shape[0])
      a = [X[i]]

      for l in range(len(self.weights)):
        a.append(self.activation(np.dot(a[l], self.weights[l])))
      error = y[i] - a[-1]
      deltas = [error * self.activation_deriv(a[-1])]

      for l in range(len(a) - 2, 0, -1):
        deltas.append(deltas[-1].dot(self.weights[l].T)*self.activation_deriv(a[l]))
      deltas.reverse()

      for i in range(len(self.weights)):
        layer = np.atleast_2d(a[i])
        delta = np.atleast_2d(deltas[i])
        self.weights[i] += learning_rate * layer.T.dot(delta)
实现预测功能。
  def predict(self, x):
    x = np.array(x)
    temp = np.ones(x.shape[0]+1)
    temp[0:-1] = x
    a = temp
    for l in range(0, len(self.weights)):
      a = self.activation(np.dot(a, self.weights[l]))
    return a
我们给出一组数据进行预测,上述程序文件保存名称为BP。
from BP import NeuralNetwork
import numpy as np

nn = NeuralNetwork([2,2,1], 'tanh')
x = np.array([[0,0], [0,1], [1,0], [1,1]])
y = np.array([1,0,0,1])
nn.fit(x,y,0.1,10000)
for i in [[0,0], [0,1], [1,0], [1,1]]:
  print(i, nn.predict(i))
运行结果如下:
([0, 0], array([ 0.99738862]))
([0, 1], array([ 0.00091329]))
([1, 0], array([ 0.00086846]))
([1, 1], array([ 0.99751259]))
总结
以上就是本文关于神经网络理论基础及Python实现详解的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站:
浅谈机器学习需要的了解的十大算法
python实现协同过滤推荐算法完整代码示例
python实现机械分词之逆向最大匹配算法代码示例
如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









