

Python实现Logistic回归:从梯度上升到随机梯度下降

Logistic回归是一种经典的分类算法,以其计算成本低、易于实现著称,但也存在容易欠拟合和分类精度有限的缺点。本文通过Python代码详细解析其核心原理,包括Sigmoid函数的应用、批量梯度上升算法以及随机梯度下降算法的实现与优化。
Logistic回归基础与Sigmoid函数
Logistic回归适用于数值型和标称型数据。其核心在于使用Sigmoid函数将线性回归的输出映射到(0, 1)区间,从而表示样本属于某一类的概率。Sigmoid函数的数学表达式为:
from math import *
def sigmoid(inX):
  return 1.0/(1+exp(-inX))
该函数将输入值映射为概率值,当输入趋近正无穷时输出趋近1,趋近负无穷时输出趋近0。在分类任务中,通常以0.5为阈值进行判断。
数据加载与预处理
在Google Colab环境中,首先需要挂载云盘以访问本地数据文件。数据通常包含特征值和标签,加载时需将截距项(通常为1.0)加入特征矩阵。
from google.colab import drive
drive.mount("/content/drive")
数据加载函数负责读取文本文件,将特征转换为浮点数,并添加截距项1.0,同时将标签转换为整数列表:
def loadDataSet():
  dataMat = []
  labelMat = []
  fr = open('/content/drive/MyDrive/Colab Notebooks/MachineLearning/《机器学习实战》/Logistic回归/Logistic回归/testSet.txt')
  for line in fr.readlines():
    lineArr = line.strip().split()
    dataMat.append([1.0, float(lineArr[0]), float(lineArr[1])])
    labelMat.append(int(lineArr[2]))
  return dataMat, labelMat
批量梯度上升算法
批量梯度上升算法通过迭代更新权重,使预测结果与真实标签的误差最小化。其核心步骤包括:
- 将数据转换为矩阵,获取样本数m和特征数n。
- 初始化权重向量为全1矩阵。
- 设定学习率(如0.001)和最大迭代次数(如500)。
- 在每次迭代中,计算预测值h = sigmoid(dataMatrix * weights)。
- 计算误差并更新权重:weights = weights + alpha * dataMatrix.transpose() * error。
from numpy import *
def gradAscent(dataMatIn, classLabels):
  dataMatrix = mat(dataMatIn)
  labelMat = mat(classLabels).transpose()
  m, n = shape(dataMatrix)
  alpha = 0.001
  maxCycles = 500
  weights = ones((n, 1))
  for k in range(maxCycles):
    h = sigmoid(dataMatrix * weights)
    error = (labelMat - h)
    weights = weights + alpha * dataMatrix.transpose() * error
  return weights
该算法每次迭代使用所有样本,收敛稳定但计算量较大。训练完成后,可通过可视化函数绘制决策边界:
import matplotlib.pyplot as plt
def plotBestFit(weights):
  dataMat, labelMat = loadDataSet()
  dataArr = array(dataMat)
  n = shape(dataArr)[0]
  xcord1 = []
  ycord1 = []
  xcord2 = []
  ycord2 = []
  for i in range(n):
    if int(labelMat[i]) == 1:
      xcord1.append(dataArr[i,1])
      ycord1.append(dataArr[i,2])
    else:
      xcord2.append(dataArr[i,1])
      ycord2.append(dataArr[i,2])
  fig = plt.figure()
  ax = fig.add_subplot(111)
  ax.scatter(xcord1, xcord1, s=30, c='red', marker='s')
  ax.scatter(xcord2, xcord2, s=30, c='green')
  x = arange(-3, 3, 0.1)
  y = (-weights[0]-weights[1]*x) / weights[2]
  ax.plot(x, y)
  plt.xlabel('X1')
  plt.ylabel('X2')
  plt.show()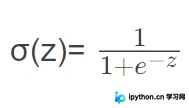
随机梯度下降算法优化
批量梯度上升算法在大数据集上计算缓慢。随机梯度下降(SGD)通过每次迭代仅使用一个样本更新权重,大幅提高了计算效率。基础版随机梯度下降算法如下:
def stocGradAscent0(dataMatrix, classLabels):
  m, n = shape(dataMatrix)
  alpha = 0.01
  weights = ones(n)
  for i in range(m):
    h = sigmoid(sum(dataMatrix[i] * weights))
    error = classLabels[i] - h
    weights = weights + alpha * error * dataMatrix[i]
  return weights
然而,基础版SGD存在收敛波动大、对噪声敏感的问题。改进版随机梯度下降算法引入了动态学习率和样本索引管理,以平衡收敛速度与稳定性:
- 设定迭代次数numIter(默认150)。
- 每次迭代中,初始化样本索引列表。
- 学习率alpha随迭代次数增加而减小:alpha = 4/(1+j+i)+0.01,避免除零错误。
- 随机选择未使用的样本索引randIndex。
- 更新权重后,从索引列表中移除已使用的样本。
def stocGradAscent1(dataMatrix, classLabels, numIter=150):
  m, n = shape(dataMatrix)
  weights = ones(n)
  for j in range(numIter):
    dataIndex = list(range(m))
    for i in range(m):
      alpha = 4/(1+j+i)+0.01
      randIndex = int(random.uniform(0, len(dataIndex)))
      h = sigmoid(sum(dataMatrix[randIndex] * weights))
      error = classLabels[randIndex] - h
      weights = weights + alpha * error * dataMatrix[randIndex]
      del(dataIndex[randIndex])
  return weights
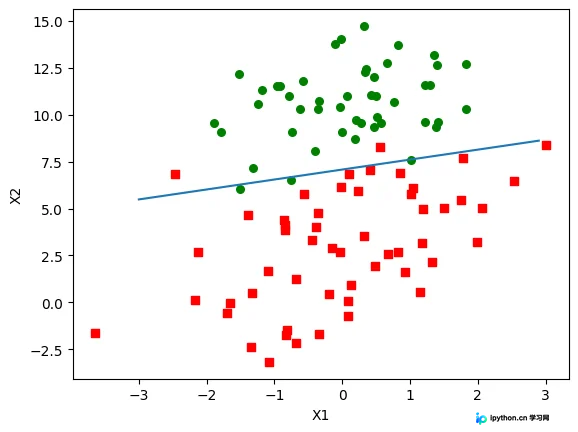
调用改进版算法并可视化结果:
dataArr, labelMat = loadDataSet()
weights = stocGradAscent1(array(dataArr), labelMat, 500)
plotBestFit(weights)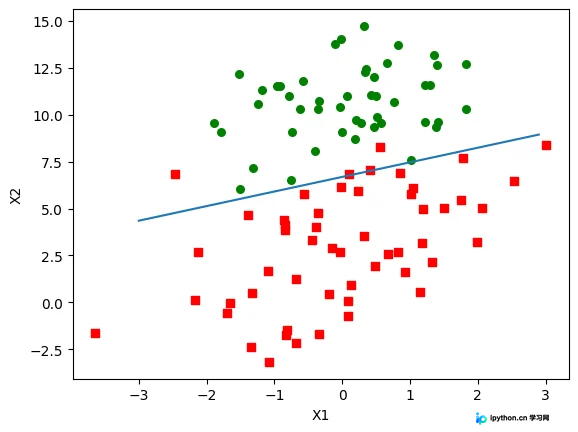
算法对比与总结
批量梯度上升算法计算代价高但收敛稳定;随机梯度下降算法计算效率高,但收敛速度较慢且对噪声敏感。通过动态调整学习率和随机采样,改进版SGD在保持高效的同时提升了收敛稳定性。
以上就是Python实现Logistic回归算法的详细内容,更多关于Python机器学习算法的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









