Python在数据分析与人工智能领域的具体应用场景解析
深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。
2026-09-18
9

深入解析Python在数据分析与人工智能领域的核心应用场景,涵盖数据清洗、指标建模、经典机器学习及大模型工程,提供完整可落地的代码示例与架构图解。
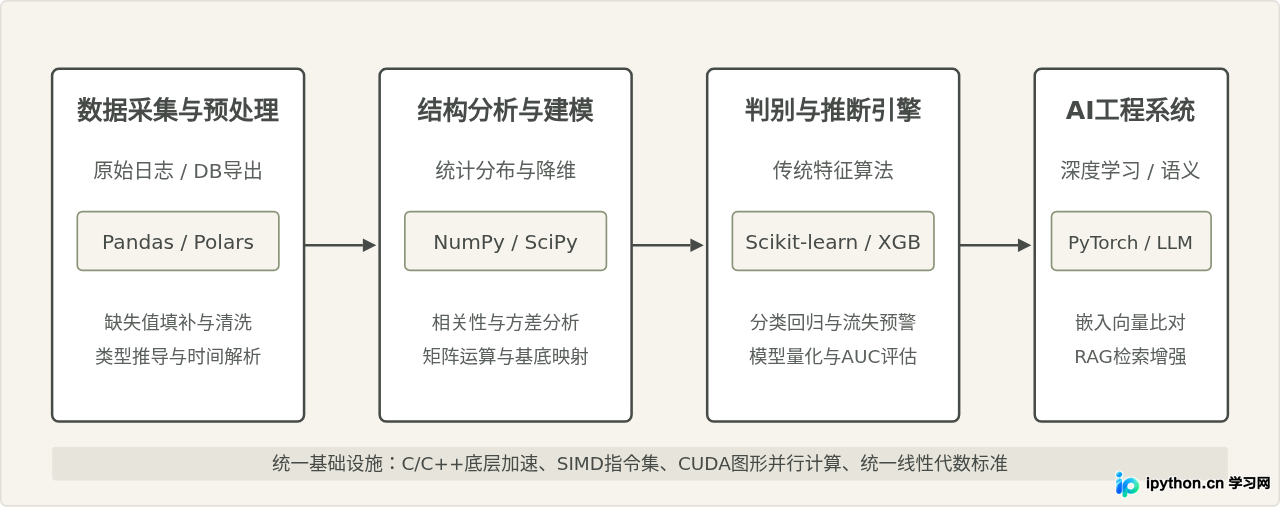
深入解析Python为何成为人工智能与数据分析领域的核心语言。从胶水语言架构、语法表达效率、生态库协同到典型应用流程与适用边界,提供详尽的技术对比与实践示例。
文章围绕“行业趋势—龙头筛选—数据验证—风险避坑”展开,帮助读者理解AI、云原生、零信任与安全平台整合如何改变网络安全行业,并建立从看赛道到看公司、再到看估值与风险的分析框架。当前行业投资逻辑正从单纯的合规防御转向AI驱动的安全需求与平台化整合,但高估值、竞争加剧及业绩兑现仍是核心风险。
围绕现行国家标准 GB/T 45654-2025,从标准理解、数据与模型安全、服务侧防护、评估验证到常见合规误区,帮助生成式人工智能服务提供者建立可落地的安全与合规闭环。该标准已于2025年11月1日起实施。 全国标准信息公共服务平台 +1
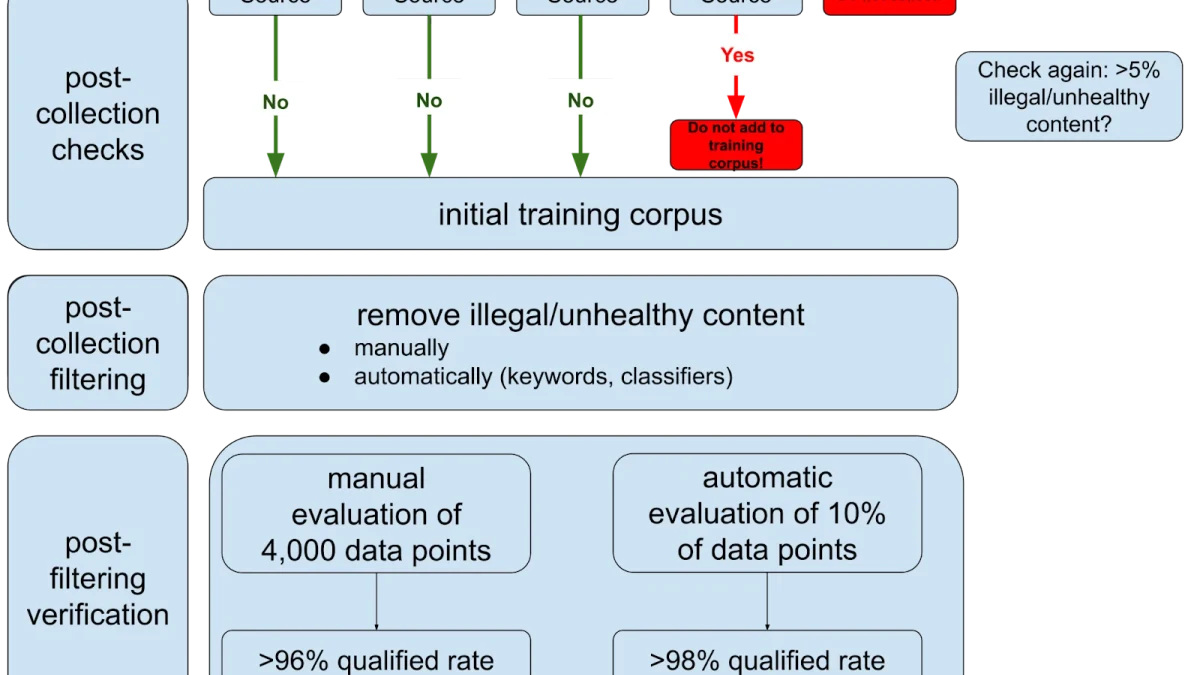
从环境搭建、核心语法到项目实践,再延伸到数据分析、Web开发或人工智能等方向,帮助零基础学习者筛选资料、建立循序渐进的学习路线,并通过实战验证学习效果。Python 官方也提供了 Beginner’s Guide、教程、标准库参考等分层学习资源,可作为资料筛选的基准。 Python.org +1
Python是否好学,不能只看语法难度,还要结合编程基础、练习方式以及未来应用方向综合判断。本文从入门门槛、有效练习路径、学习验证和应用选择几个方面,帮助零基础学习者判断Python是否适合自己,并避开只看教程、不做练习等常见误区。
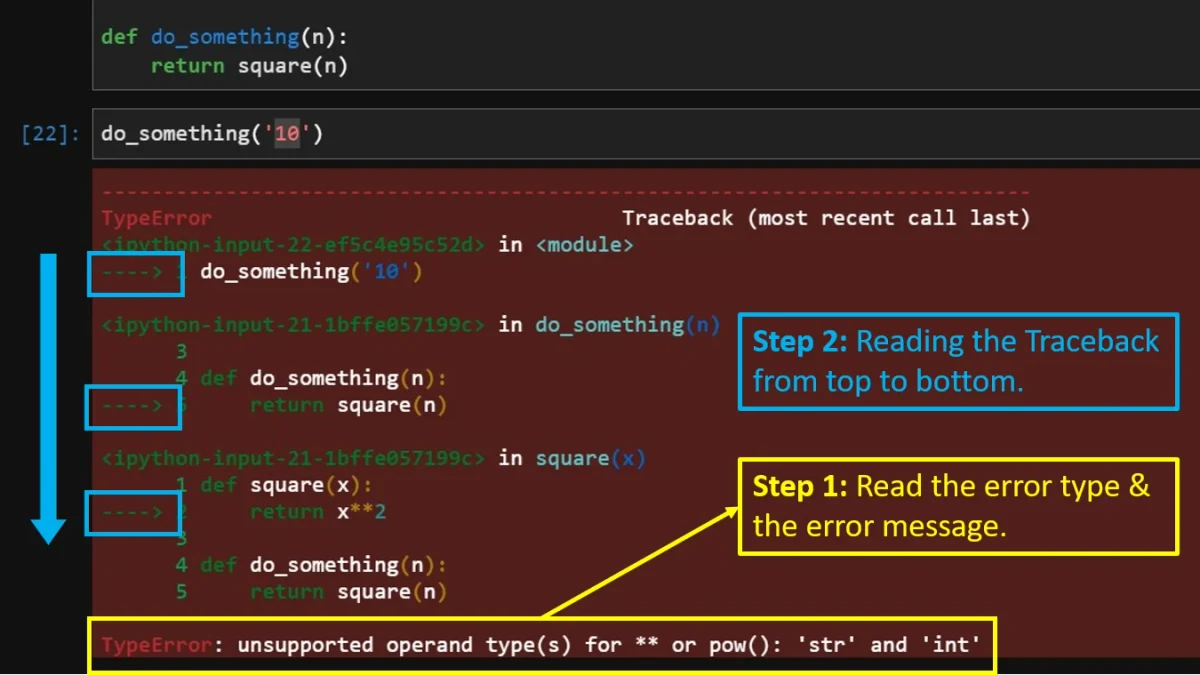
从Web开发、数据分析到自动化办公与人工智能,了解Python能解决哪些实际问题,并通过典型应用场景判断自己是否适合学习Python。
从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。
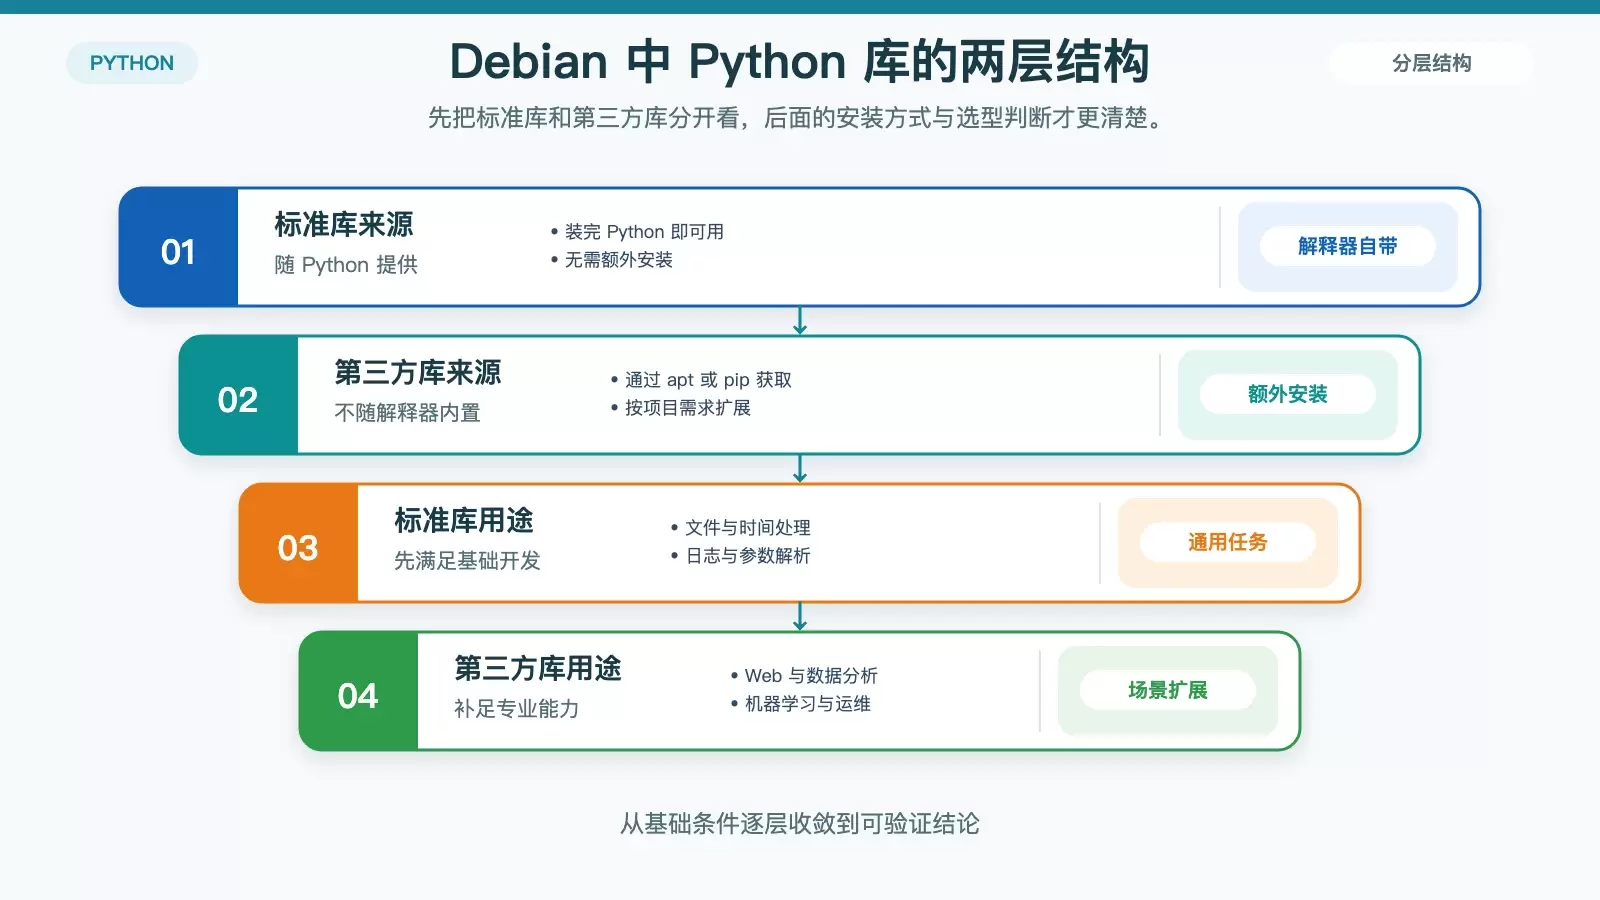
Debian 里的 Python 库大致分为两类:安装 Python 后即可使用的标准库,以及通过 apt 或 pip 额外安装的第三方库。理解两者的边界、适用场景和安装方式,能帮助你在开发、运维和数据处理时更稳妥地选库与管理环境。
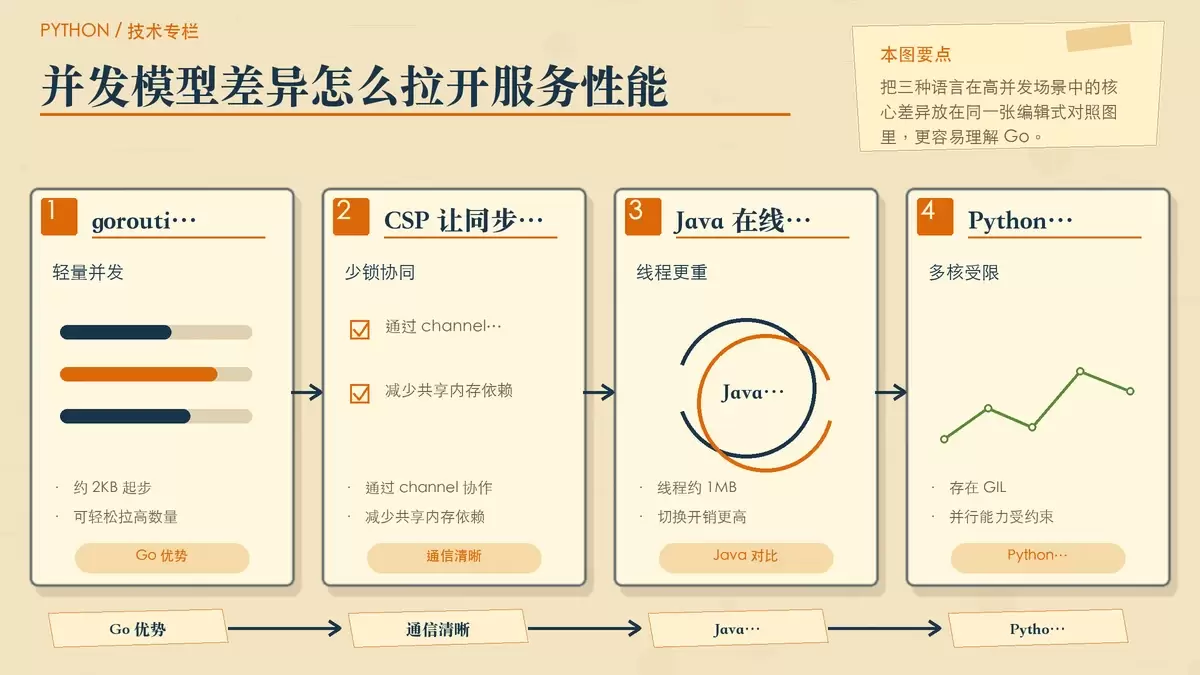
Go 在分布式系统里的优势,不只是“更快”这么简单。它真正拉开差距的地方在于并发模型、资源占用、启动速度以及云原生部署体验。和 Java、Python 对比后,可以更清楚判断:什么时候该优先选 Go,什么时候仍该保留其他语言。
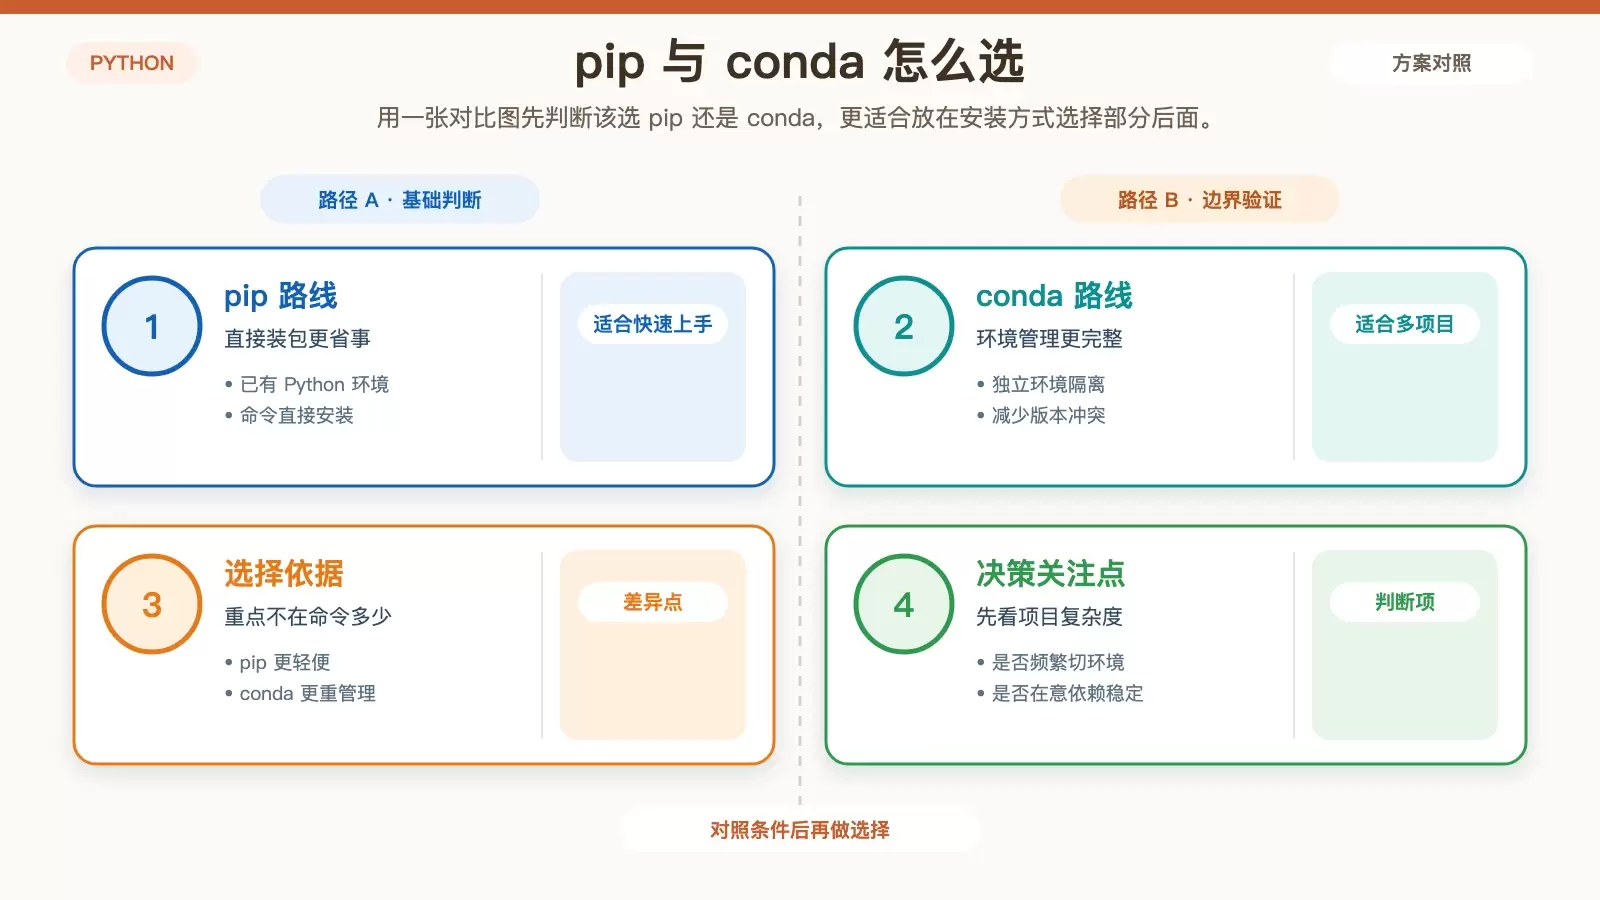
在 Debian 上安装 Python 机器学习库,核心通常就是选 `pip` 还是 `conda`。前者轻便直接,适合已有 Python 环境的用户;后者更强调环境隔离,适合需要控制依赖版本的项目。本文按两条安装路径整理常用命令,并补上 CUDA、权限和基础依赖等关键注意点。
这篇文章聚焦广告请求流程中的后半段:投放控制、搜集出价、视频转码、竞价求解和结果渲染。核心看点不是单点技术,而是 Scala 与 akka-stream、Akka Distributed Data、gRPC 等组件如何协同,把高并发广告系统拆成可控、可隔离、可优化的处理链路。