

Python中两种加载数据文件的方法详解

在机器学习项目中,数据是核心基础。Python作为主流编程语言,提供了多种加载数据文件的方式。本文将详细解析两种常用方法:使用内置open()函数和pandas库的read_csv(),并通过示例展示其应用,帮助您高效读取特征与标签数据。
使用open()函数加载数据
Python内置的open()函数可直接打开文本文件进行逐行读取,适合简单格式的数据集。该方法无需额外依赖库,但需手动处理数据分割和格式转换。
第1步:编写加载函数
目的:定义一个函数来读取文件并将内容转换为特征矩阵和标签矩阵。入口为文件名参数。重要参数包括文件路径和分隔符(如制表符)。可观察状态:函数返回两个numpy矩阵对象。
def load_file(file_name):
    '''
    利用open()函数加载文件
    :param file_name: 文件名
    :return: 特征矩阵、标签矩阵
    '''
    f = open(file_name)
    feature = []
    label = []
    for row in f.readlines():
        f_tmp = []
        l_tmp = []
        number = row.strip().split("\t")
        f_tmp.append(1)
        for i in range(len(number) - 1):
            f_tmp.append(float(number[i]))
        l_tmp.append(float(number[-1]))
        feature.append(f_tmp)
        label.append(l_tmp)
    f.close()
    return np.mat(feature), np.mat(label)
使用Pandas库加载数据
pandas库提供了更高效的dataframe处理接口,read_csv()方法能快速加载结构化数据,尤其适合大型文件或复杂格式。需安装pandas库(pip install pandas)。
第2步:配置read_csv参数
目的:使用read_csv()读取带分隔符的文件,并选择特定列。入口为文件路径和名称。重要参数包括delimiter="\t"、header=None和usecols指定列索引。可观察状态:返回numpy格式的数组,便于后续计算。
def load_file_pd(path, file_name):
    '''
    利用pandas库加载文件
    :param path: 文件路径
    :param file_name: 文件名称
    :return: 特征矩阵、标签矩阵
    '''
    feature = pd.read_csv(path + file_name, delimiter="\t", header=None, usecols=[0, 1])
    feature.columns = ["a", "b"]
    feature = feature.reindex(columns=list('cab'), fill_value=1)
    label = pd.read_csv(path + file_name, delimiter="\t", header=None, usecols=[2])
    return feature.values, label.values
测试与比较
以下是加载示例数据的代码和结果。数据集包含三列:前两列为特征,最后一列为标签,内容如下:
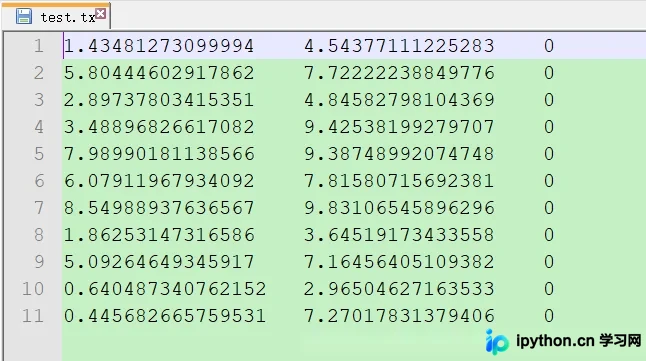
完整测试代码如下:
'''
两种方式加载文件
'''

import pandas as pd
import numpy as np

def load_file(file_name):
    # ... 同上函数代码 ...

def load_file_pd(path, file_name):
    # ... 同上函数代码 ...

if __name__ == "__main__":
    path = "C://Users//Machenike//Desktop//xzw//"
    feature, label = load_file(path + "test.txt")
    feature_pd, label_pd = load_file_pd(path, "test.txt")
    print(feature)
    print(feature_pd)
    print(label)
    print(label_pd)
运行后输出显示,两种方法得到的特征和标签矩阵值一致,验证了它们在相同数据格式下的等效性。这可用于后续算法如Logistic Regression的训练阶段。
注意事项与总结
在实际应用中,数据格式可能因来源而异(如逗号分隔或空格分隔),需灵活调整分隔符和列选择参数。此外,对于大文件,pandas的内存管理更高效;而对于轻量级任务,open()函数更简单直接。备份原始数据后再进行批量处理是良好习惯,避免误操作导致损失。
以上就是Python加载数据文件方法详解的详细内容,更多关于Python数据处理和机器学习资料的信息请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









