XML转HTML实战:通过XSLT实现数据与显示分离
XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
2026-10-16
5

XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。
本文总结了在Python中清洗小说数据时去除HTML标签的三种常用方法。通过对比正则表达式、BeautifulSoup解析器以及lxml库的实际代码示例,展示了如何从混杂HTML的字符串中提取纯文本。此外,还介绍了利用正则表达式移除HTML标签属性的技巧,帮助开发者快速实现数据清洗。
本文介绍Python中从HTML提取纯文本的三种常用方法:使用正则表达式移除标签、调用NLTK库的clean_html函数以及自定义HTMLParser解析器。文章对比了各方案的代码实现、依赖要求及适用场景,帮助开发者根据项目需求选择最高效的文本提取方案。
本文详解如何使用Python的smtplib和email模块通过QQ邮箱发送电子邮件。重点讲解开启SMTP服务、获取第三方授权码的安全配置步骤,并分别演示纯文本与HTML格式邮件的代码实现,涵盖端口配置及常见参数说明。
本文解决Python中使用xlrd读取HTML格式Excel文件时出现的Unsupported format报错,并针对pd.read_html读取数据不完整的问题,推荐将解析器flavor设置为'bs4'以获取完整数据。
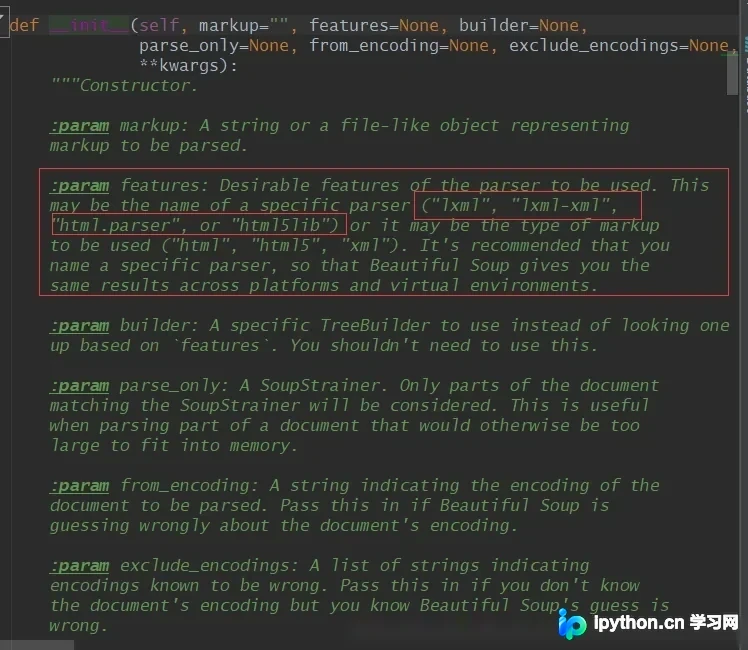
本文详细介绍Python中Beautiful Soup库的使用方法。涵盖安装、四大核心对象(Tag、NavigableString、BeautifulSoup、Comment)的解析,文档树遍历与搜索技巧(find_all、find、select),以及综合实例与lxml对比。
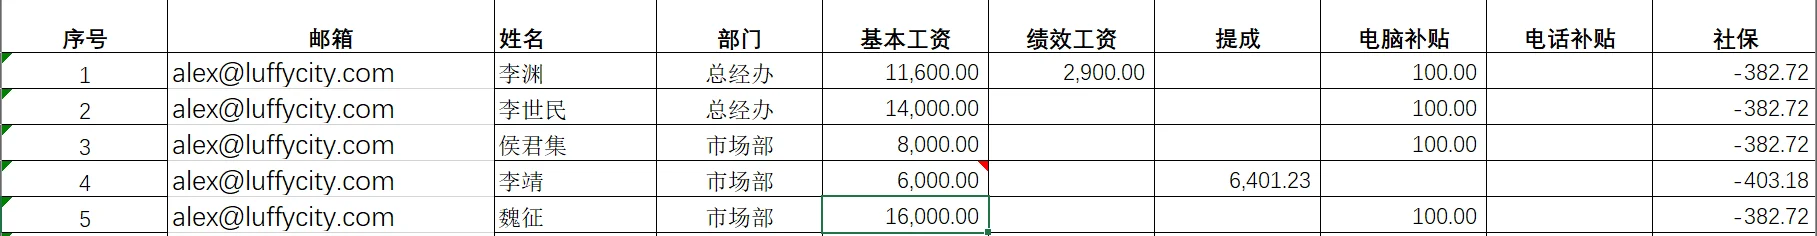
本文详细介绍如何使用Python批量向员工发送工资条邮件。通过读取Excel文件获取员工数据,利用smtplib库连接邮箱服务器,并构造HTML格式的工资条正文。重点解析了QQ邮箱等服务商使用授权码登录的配置细节,以及遍历Excel数据生成动态HTML表格的方法,帮助开发者实现高效的自动化办公流程。
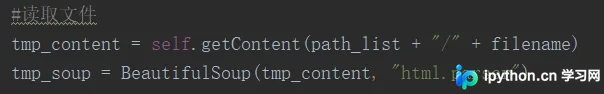
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
本文介绍如何利用Python Pandas库中的to_html()函数,将Excel表格数据直接转换为HTML格式。通过读取Excel文件并调用相关方法,可生成包含标准HTML标签的网页表格,支持自定义标题、索引及对齐方式等参数,适用于无需复杂前端知识即可快速生成数据展示页面的场景。
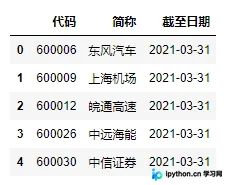
本文介绍在Django中如何通过视图传递字符串至模板,并解决HTML标签被自动转义的问题。通过示例演示视图函数编写与模板创建,重点讲解使用safe过滤器处理单个变量,以及利用autoescape标签批量控制模板内容的转义行为,确保字符串按原样显示。
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
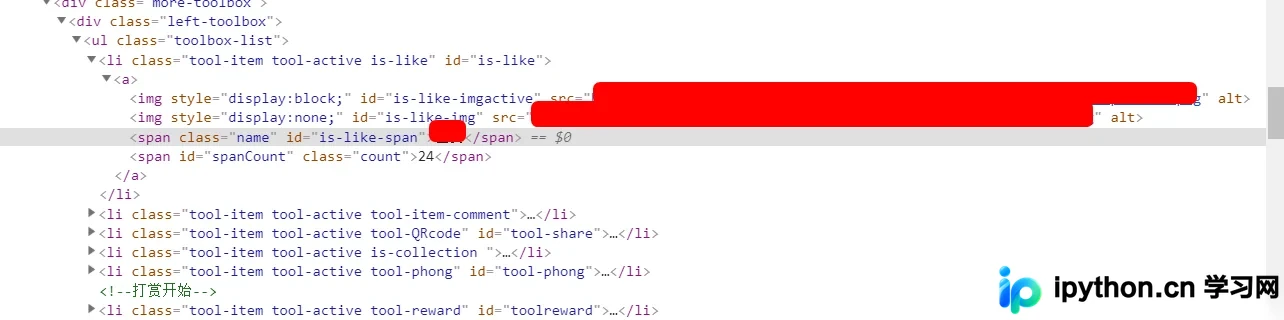
本文详细介绍Python中BeautifulSoup库的核心查找方法find和find_all。通过构建实例、解析HTML结构,演示如何精准定位标签、提取文本与属性。重点讲解处理class关键字冲突的技巧,以及find_all在批量提取数据时的灵活应用,帮助开发者高效完成网页数据抓取任务。