

Python BeautifulSoup基础:利用标签与Class定位元素

发布时间:2026-10-14| 6人浏览过
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
具体实现步骤如下:
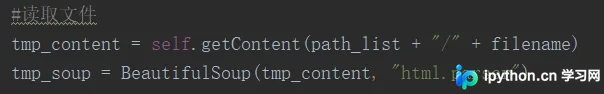
初始化BeautifulSoup与HTML解析
首先,将目标HTML文件保存至本地,随后调用BeautifulSoup库读取该文件,并指定解析器为html.parser。
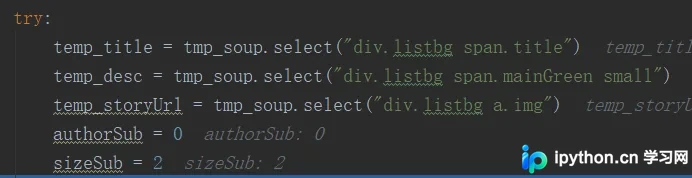
在调用tmp_soup.select()方法时,传入的选择器参数格式如下:
使用CSS选择器定位元素
该选择器的含义是查找div标签中class属性包含listbg的元素,并进一步定位其内部span标签中带有title属性的节点。
执行上述操作后,返回的数据类型结构如下:
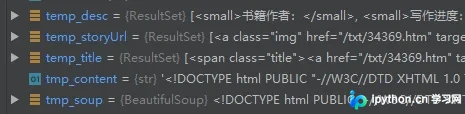
最终获取的对象均为ResultSet类型。
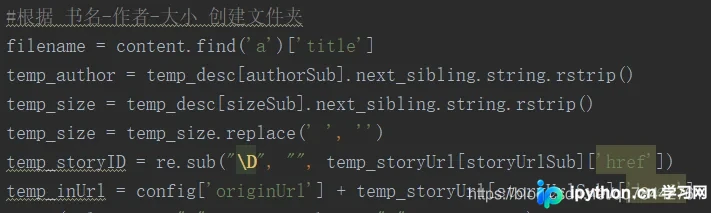
可以通过以下代码逻辑进行具体数据的提取:
提取标签属性值
使用find('目标标签')['属性名']的方式,可以获取标签中指定属性的值。
若需处理li标签下的内容,可采用如下方式进行数据获取:
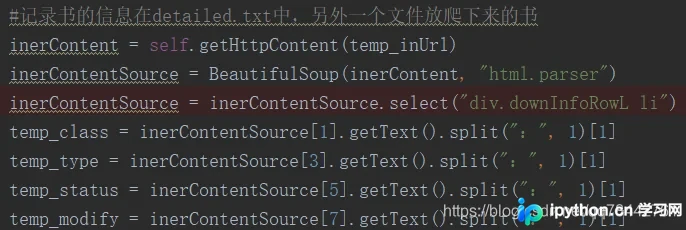
至此,关于Python BeautifulSoup基础用法(通过标签及class定位元素)的介绍已完成。如需了解更多相关Python BeautifulSoup用法,建议查阅本站过往文章或继续浏览后续内容,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









