

使用Pandas将Excel数据导出为HTML格式
本文介绍如何利用Python Pandas库中的to_html()函数,将Excel表格数据直接转换为HTML格式。通过读取Excel文件并调用相关方法,可生成包含标准HTML标签的网页表格,支持自定义标题、索引及对齐方式等参数,适用于无需复杂前端知识即可快速生成数据展示页面的场景。
2026-10-14
6

本文介绍如何利用Python Pandas库中的to_html()函数,将Excel表格数据直接转换为HTML格式。通过读取Excel文件并调用相关方法,可生成包含标准HTML标签的网页表格,支持自定义标题、索引及对齐方式等参数,适用于无需复杂前端知识即可快速生成数据展示页面的场景。
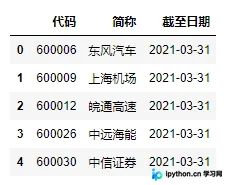
本文介绍如何使用Python将CSV文件转换为HTML文件。首先解析CSV文件格式,然后读取CSV数据,最后生成对应的HTML表格。
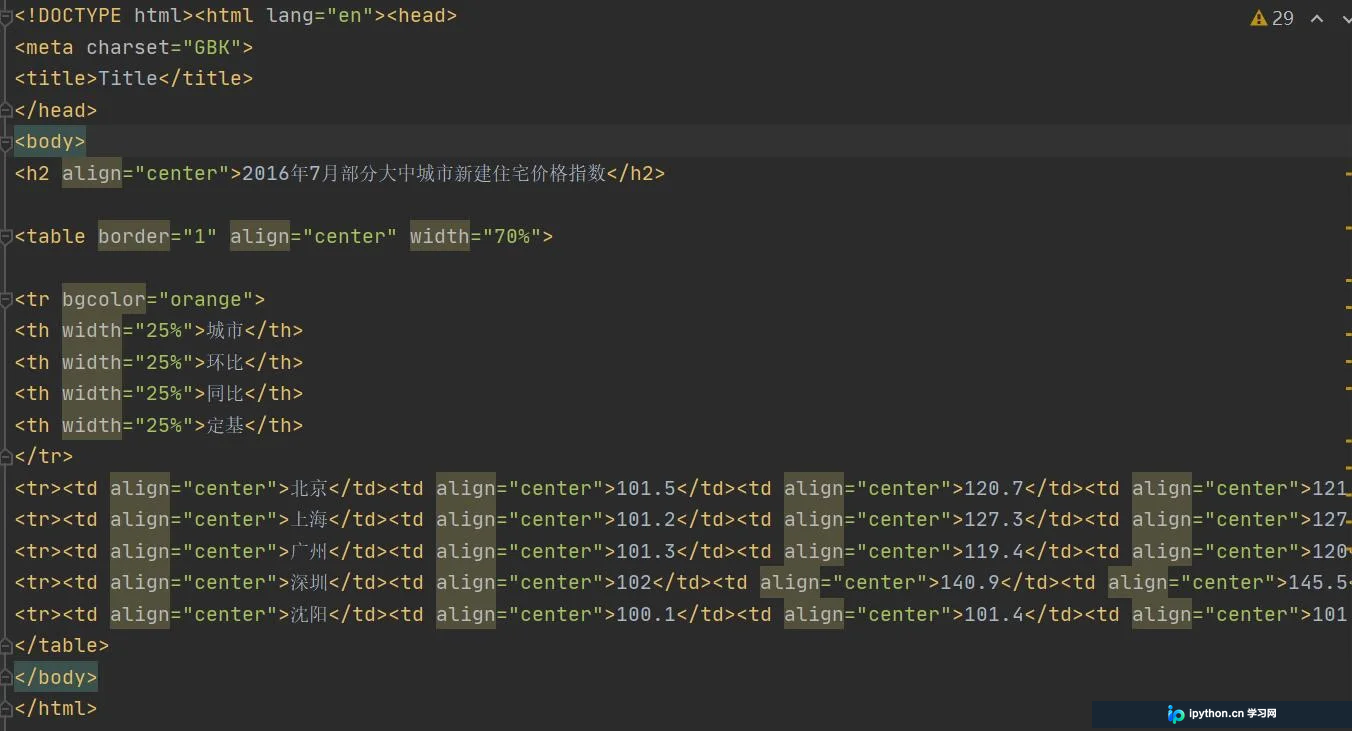
本文介绍在Django中如何通过视图传递字符串至模板,并解决HTML标签被自动转义的问题。通过示例演示视图函数编写与模板创建,重点讲解使用safe过滤器处理单个变量,以及利用autoescape标签批量控制模板内容的转义行为,确保字符串按原样显示。
本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
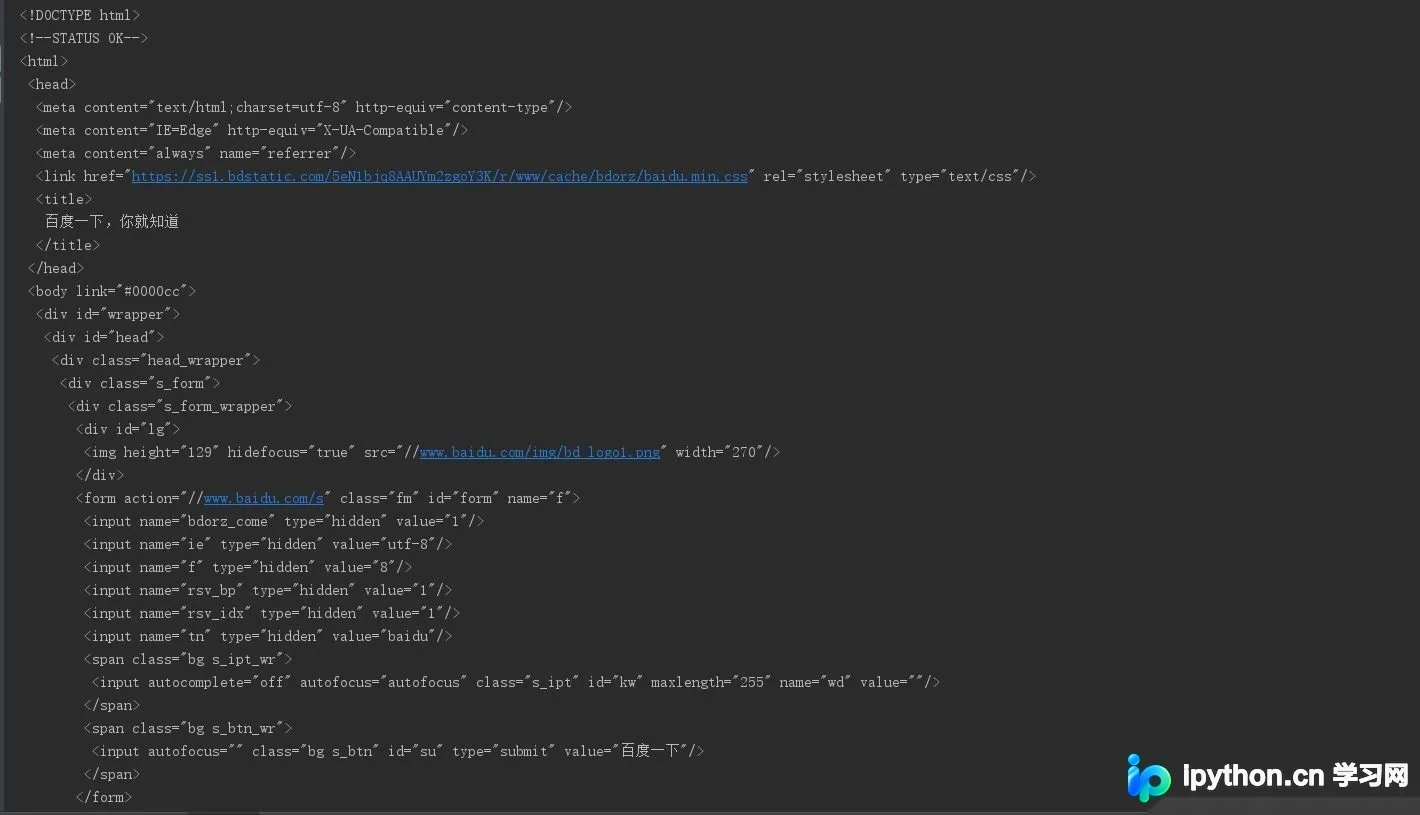
本文详细介绍Python中PyQuery库的安装与基础用法。通过pip3安装后,利用PyQuery类实现HTML字符串、文件或网络响应的初始化。重点演示如何使用CSS选择器精准定位并提取DOM元素内容,帮助开发者快速掌握这一灵活的数据解析工具。
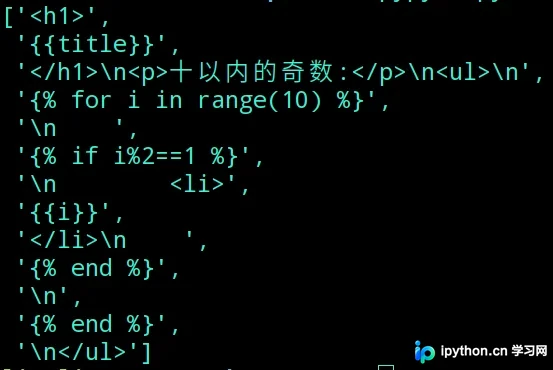
本文详解如何使用Python从零实现一个支持变量替换、IF判断和FOR循环的简易模板引擎。通过正则表达式提取HTML与渲染语句,利用CodeBuilder类动态生成Python代码,并结合exec执行逻辑。文章深入解析了字符串拼接优化、缩进管理及变量提取机制,提供完整代码实现思路与关键类定义,帮助开发者理解模板引擎底层原理。
本文介绍Python中高性能的lxml库,它基于C语言实现,支持HTML和XML数据的解析与提取。文章详细讲解了通过pip、PyCharm及官网三种方式安装lxml的方法,并演示了如何利用该库自动修复不规范HTML代码,以及通过字符串解析和文件读取两种方式提取数据的基本操作。
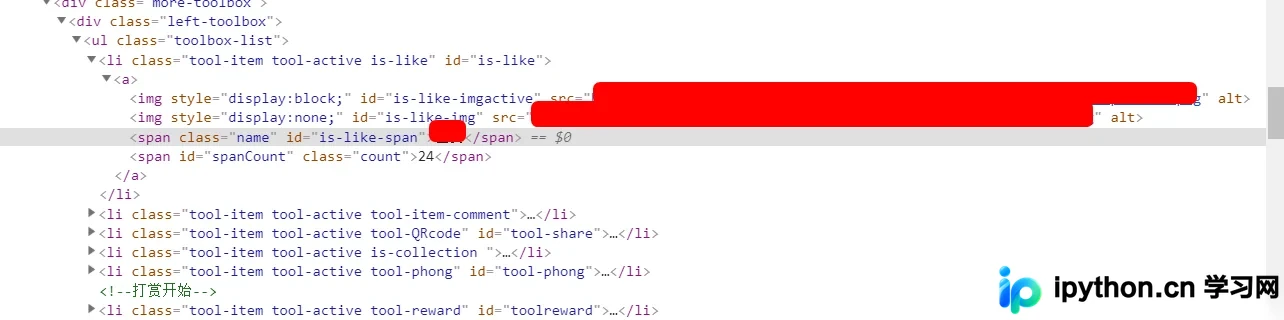
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
本文介绍 Django Form 的四大核心功能,包括自动生成 HTML 标签、验证用户数据、保留提交内容及初始化页面。通过 views.py 和 login.html 的代码示例,演示如何定义 LoginForm 类并进行 POST 数据验证,帮助开发者快速掌握表单处理流程。
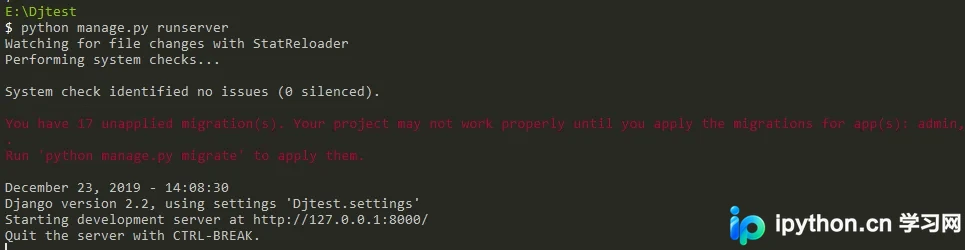
本文详细介绍在Django项目中返回HTML文件的完整流程。从创建templates文件夹、编写HTML模板,到在Views中使用render函数渲染页面,再到Urls配置路由,最后通过浏览器验证结果及处理常见404报错,帮助开发者快速掌握Django前端展示的核心配置方法。
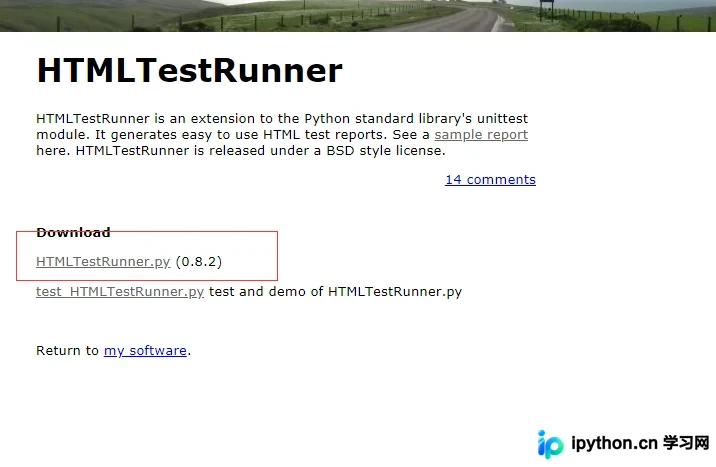
本文详细介绍HTMLTestRunner的官方下载地址及保存至site-packages目录的方法。针对Python 3.7环境,重点解析需修改的代码行,包括StringIO导入、字典键值判断及print语句语法调整。最后通过pip命令完成安装验证,确保自动化测试报告功能正常运行。
本文介绍Python中处理HTML和XML字符串的常用方法。通过html.escape()函数转义特殊字符,利用encode()方法处理非ASCII编码实体,以及使用HTMLParser和xml.sax.saxutils进行实体解码。建议优先使用解析器自动处理,确保文本安全与格式正确。