

使用Pandas将Excel数据导出为HTML格式

本文介绍如何利用Python Pandas库中的to_html()函数,将Excel表格数据直接转换为HTML格式。通过读取Excel文件并调用相关方法,可生成包含标准HTML标签的网页表格,支持自定义标题、索引及对齐方式等参数,适用于无需复杂前端知识即可快速生成数据展示页面的场景。
前言
在Python数据处理中,提到Pandas导出数据,开发者通常会联想到to系列的方法。
其中,pd.to_csv()和pd.to_excel()是日常使用频率较高的函数。然而,Pandas同样支持将数据导出为HTML网页格式,实现这一功能所使用的函数是pd.to_html()。
读取Excel
要将Excel文件转换为HTML格式,第一步是读取Excel中的表格数据。
import pandas as pd
data = pd.read_excel('测试.xlsx')
查看数据
data.head()
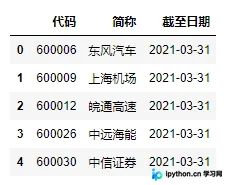
接下来,我们将学习如何将DataFrame对象转换为HTML表格。
生成Html
to_html()函数能够直接将DataFrame转换为HTML表格,仅需一行代码即可完成:
html_table = data.to_html('测试.html')
执行上述代码后,当前工作目录下会生成一个名为测试.html的文件。使用网页浏览器打开该文件,显示效果如下:
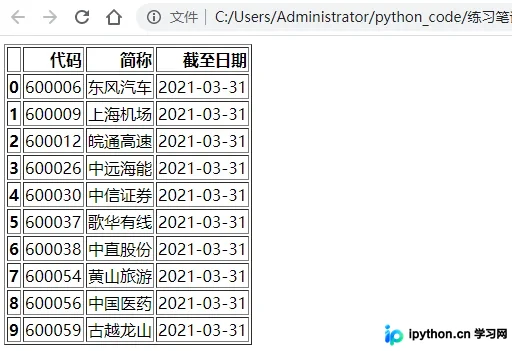
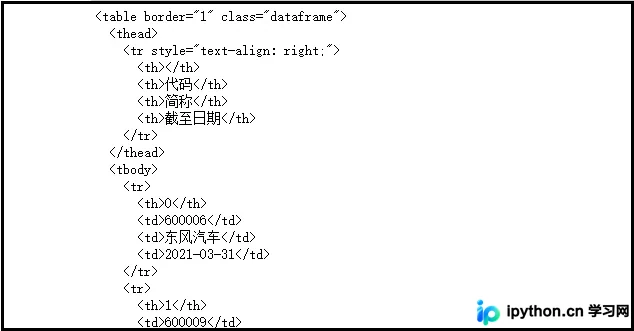
print(data.to_html())
通过print语句打印输出,可以观察到DataFrame的内部结构被自动转换为嵌入在表格中的<TH>、<TR>和<TD>标签,同时保留了所有的内部层级结构。
调整格式
我们可以通过自定义修改参数,来调整生成HTML文件的格式样式。
html_table = data.to_html('测试.html',header = True,index = False,justify='center')
再次打开新生成的测试.html文件,可以发现页面的格式已经发生了相应的变化。
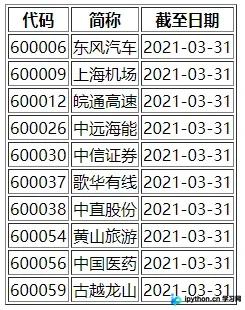
若需对格式进行更深入的调整(例如增加标题、修改颜色等),则需要具备一定的HTML知识,可以直接对生成的测试.html文件中的文本内容进行手动调整。
对于需要进行页面展示的场景,可以结合Flask库来使用此功能。
小结
Pandas提供了read_html()和to_html()两个函数用于处理html格式的文件。这两个函数非常实用:to_html()可以轻松将DataFrame等复杂数据结构转换为HTML表格;而read_html()则无需复杂的爬虫程序,仅用几行代码即可抓取Table表格型数据,堪称数据处理的神器。
本文篇幅较短,主要讲解了Pandas中的to_html()函数。使用该函数的最大优势在于:即使不了解HTML知识,也能生成一个标准的表格型HTML文件。
总结
至此,关于如何利用Pandas将Excel转换为HTML格式的介绍已结束。如需了解更多相关pandas将Excel转html格式的内容,请搜索本站以前的文章或继续浏览下面的相关文章。希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









