

Django后台返回HTML代码并防止转义的方法
本文介绍如何在Django中从后台直接返回HTML代码并保留CSS样式,解决默认安全机制导致的HTML被转义问题。通过mark_safe()函数或模板中的safe过滤器,可确保前端正确渲染HTML标签,避免额外的前端判断逻辑。
2026-10-13
6

本文介绍如何在Django中从后台直接返回HTML代码并保留CSS样式,解决默认安全机制导致的HTML被转义问题。通过mark_safe()函数或模板中的safe过滤器,可确保前端正确渲染HTML标签,避免额外的前端判断逻辑。
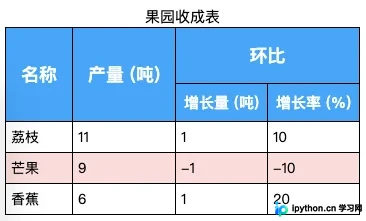
本文介绍如何利用Python的html-table库生成复杂的HTML表格。通过实例演示从安装配置到创建表格、处理合并单元格及自定义CSS样式的完整流程,重点讲解rowspan和colspan的使用,以及如何精细化控制表格边框、字体及背景颜色,适用于邮件报表等需要动态生成HTML的场景。
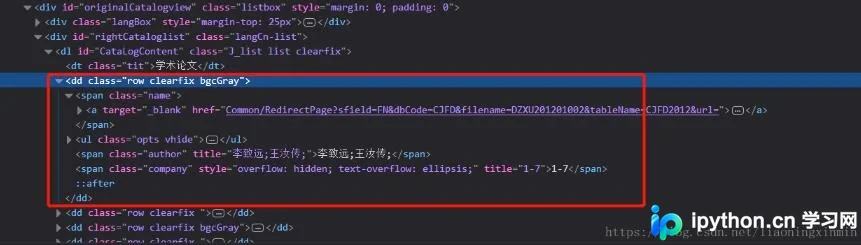
本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
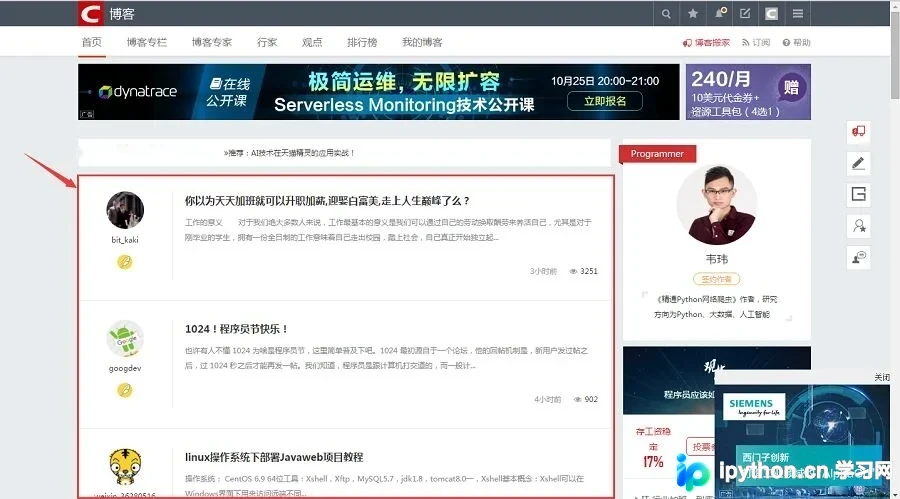
本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。
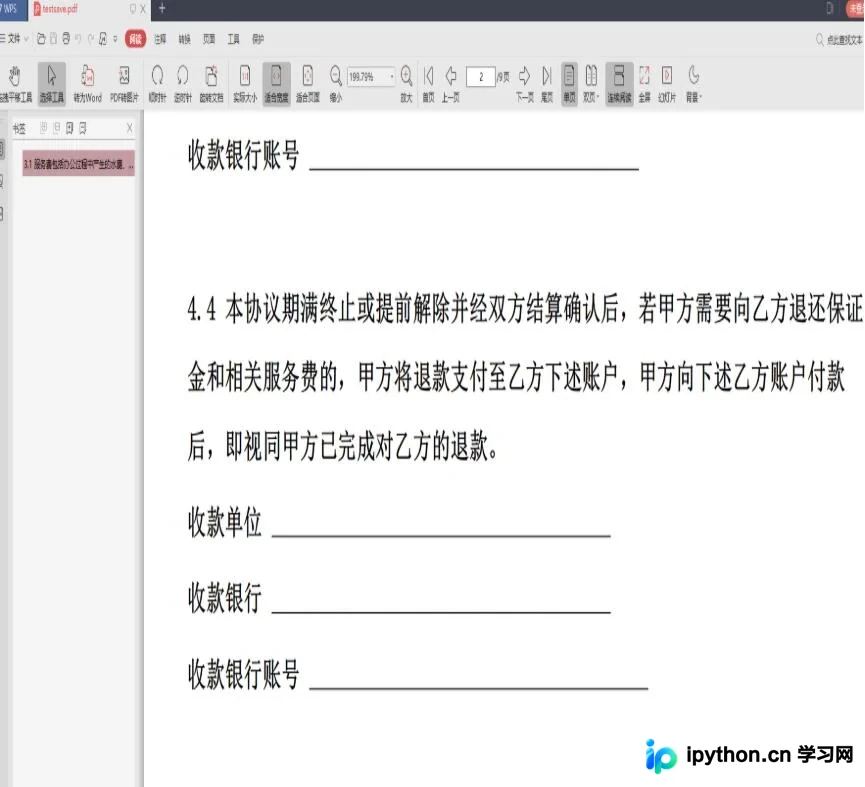
本文介绍如何使用Python库pdfkit将HTML或文本内容转换为PDF文件。重点讲解wkhtmltopdf可执行文件的安装路径配置、编码选项设置以解决乱码问题,以及from_file和from_string接口的具体用法。包含完整代码示例,涵盖数据库查询、文件读写及PDF生成的全流程,帮助开发者快速实现文档导出功能。
本文介绍如何使用Python发送HTML格式的邮件。核心在于将MIMEText的subtype参数设置为html而非plain。通过示例代码展示如何配置163邮箱SMTP服务器、处理用户输入及发送带HTML内容的邮件,包含完整的连接、登录与发送逻辑。
本文详细介绍如何利用Python的smtplib库发送不同格式的邮件。内容涵盖发送纯文本邮件、包含HTML内容的邮件、带有附件的邮件以及正文嵌入图片的邮件。通过具体代码示例,解析MIMEText、MIMEMultipart及MIMEImage等模块的使用,帮助开发者掌握邮件发送的核心技术与参数配置。
本文详细介绍Python中lxml模块的安装方法及核心用法。通过etree.HTML将字符串转换为Element对象,利用XPath进行数据提取。文章演示了如何处理不规范HTML、解决属性缺失导致的对应错误,并展示通过节点分组实现更精准的数据抓取技巧,适合Python爬虫开发者参考。
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
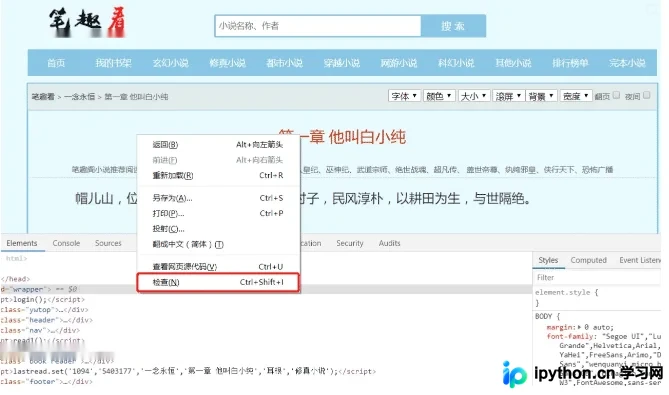
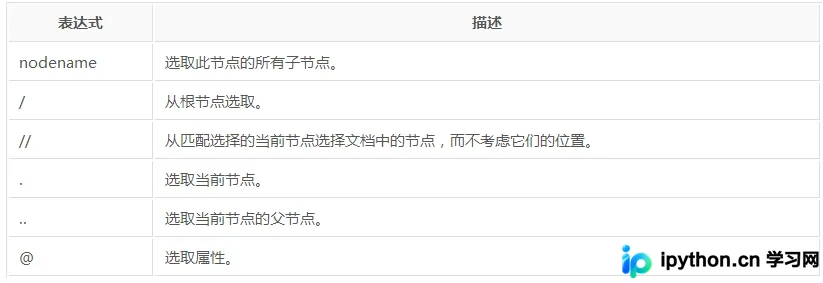
本文详细介绍Python中lxml库解析HTML文件的方法。涵盖DOM节点创建与属性获取、XPath绝对与相对路径筛选、文本提取及Scrapy爬虫实战示例。重点强调UTF-8解码必要性及常见解析错误处理,帮助开发者高效处理网页数据。
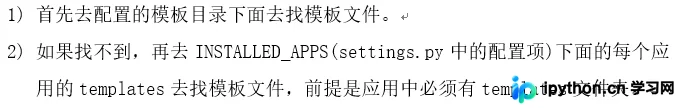
本文详细介绍Python Django框架中的模板渲染功能,涵盖settings.py中模板路径配置、views.py中视图函数的编写(包括传统loader方式与简化的render方式),以及HTML模板文件的创建与变量、代码段和循环语句的使用。
本文介绍Django框架中模板继承的核心机制,通过定义base.html基础模板,利用{% extends %}和{% block %}标签实现代码复用。文章详细讲解了如何在子模板中重载标题、JS、CSS及内容区块,并强调静态文件引用的特殊性,旨在帮助开发者减少前端代码冗余,提升维护效率。