

Python lxml etree 实战:HTML解析与文本提取技巧

本文介绍Python中lxml库的etree模块在HTML解析中的应用。重点讲解etree.HTML()将字符串转为_Element对象,以及利用xpath()提取文本。针对嵌套标签导致的文本分割问题,对比了//h1/text()与//h1//text()的区别,并演示了etree.tostring()结合method='text'参数高效获取完整文本的方法。
lxml etree 基础与 HTML 解析
在Python开发中,处理HTML文档时,我通常依赖lxml库的etree模块进行DOM树解析。这种方式能高效地从HTML源码中提取目标数据。
本文将重点介绍两个常用方法:etree.HTML()和etree.tostring()。
1. etree.HTML()
etree.HTML()函数用于解析字符串格式的HTML文档,将其转换为_Element对象。作为_Element对象,它可以方便地调用getparent()、remove()和xpath()等方法进行操作。
若需通过XPath提取HTML源码中的内容,首先需将HTML字符串转换为_Element对象,随后使用xpath()方法进行解析。例如,对于以下HTML源码:"<html><body><h1>This is a test</h1></body></html>",若要提取h1标签内的文本,可参考以下实现:
# encoding=utf8

from lxml import etree

html = '<html><body><h1>This is a test</h1></body></html>'
# 将html转换成_Element对象
_element = etree.HTML(html)
# 通过xpath表达式获取h1标签中的文本
text = _element.xpath('//h1/text()')
print 'result is: ', text
运行结果:
result is: ['This is a test']
从结果可以看出,xpath()方法返回的是一个列表。因此,在实际获取数据时,通常只需取列表中的第一个元素即可。
处理嵌套标签的文本提取
2. etree.tostring()
etree.tostring()方法用于将_Element对象转换回字符串。当简单的XPath表达式无法获取所需内容时,该方法尤为有用。例如,对上述HTML稍作修改:"<html><body><h1>This <a>is a </a>test</h1></body></html>"。此时,若需获取h1标签内的完整文本,尝试使用“//h1/text()”表达式(可将上述HTML保存后用Firefox浏览器打开,并在FirePath中输入该XPath表达式进行验证):
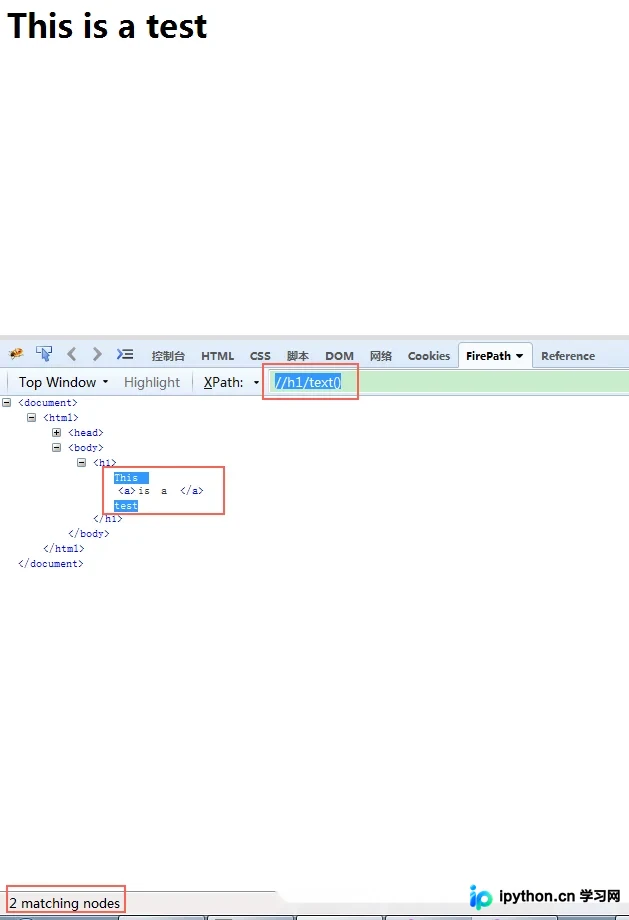
从截图左下角的提示可知,使用XPath表达式“//h1/text()”仅能获取h1标签直接子节点中的文本,即“This”和“test”。通过代码验证如下:
# encoding=utf8

from lxml import etree

html = '<html><body><h1>This <a>is a </a>test</h1></body></html>'
_element = etree.HTML(html)
text = _element.xpath('//h1/text()')
print 'result is: ', text
运行结果:
result is: ['This ', 'test']
确实,使用xpath()方法仅能获取h1标签中的部分文本。接下来尝试使用“//h1//text()”表达式:
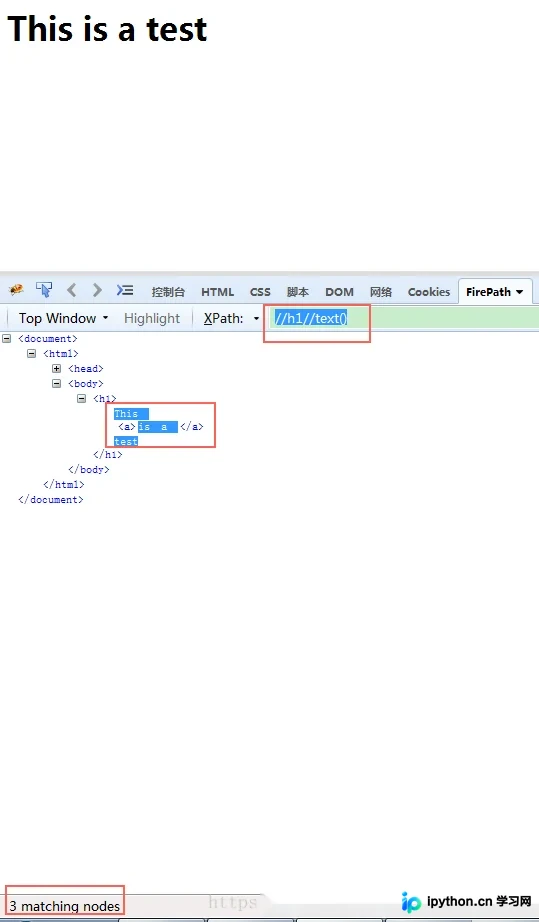
通过代码验证:
# encoding=utf8

from lxml import etree

html = '<html><body><h1>This <a>is a </a>test</h1></body></html>'
_element = etree.HTML(html)
text = _element.xpath('//h1//text()')
print 'result is: ', text
运行结果:
result is: ['This ', 'is a ', 'test']
虽然“//h1//text()”表达式能获取所需内容,但返回的是列表,需将所有元素拼接起来,操作略显繁琐。此时,可考虑使用etree.tostring()方法。该方法支持多个参数,包括element_or_tree、encoding和method等。当method参数设为'text'时,表示返回_Element对象中的所有文本,因此可以这样操作:
# encoding=utf8

from lxml import etree

html = '<html><body><h1>This <a>is a </a>test</h1></body></html>'
_element = etree.HTML(html)
# 先找到h1对象,然后通过etree.tostring方法找到h1对象中的所有文本
_h = _element.xpath('//h1')
# 注意,xpath方法返回的是一个列表,我们需要的是列表中的第一个元素:代表h1标签的_Element对象
result = etree.tostring(_h[0], method='text')
print 'result is: ', result
运行结果:
result is: This is a test
由此可见,使用etree.tostring()方法能更简便地解决问题。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









