

Python深度学习RNN与LSTM模型结构详解
本文详细解析Python中RNN与LSTM模型的核心结构。介绍RNN隐藏层状态传递机制,区分Elman与Jordan网络,并深入讲解LSTM的门控机制(输入门、遗忘门、输出门)及数据流向。通过Python代码示例展示LSTM单元如何控制信息存储与输出,对比其与DNN的参数差异,帮助开发者理解长短期记忆网络的内部流程。
2026-10-14
6

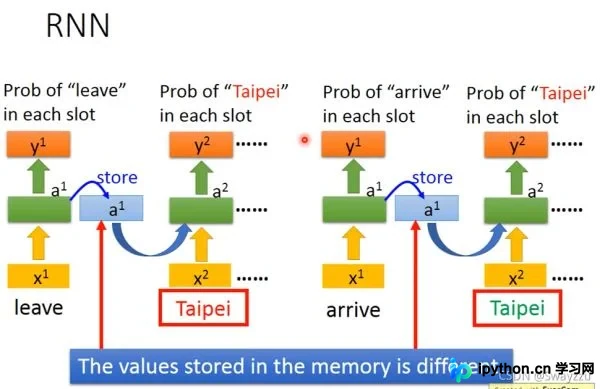
本文详细解析Python中RNN与LSTM模型的核心结构。介绍RNN隐藏层状态传递机制,区分Elman与Jordan网络,并深入讲解LSTM的门控机制(输入门、遗忘门、输出门)及数据流向。通过Python代码示例展示LSTM单元如何控制信息存储与输出,对比其与DNN的参数差异,帮助开发者理解长短期记忆网络的内部流程。
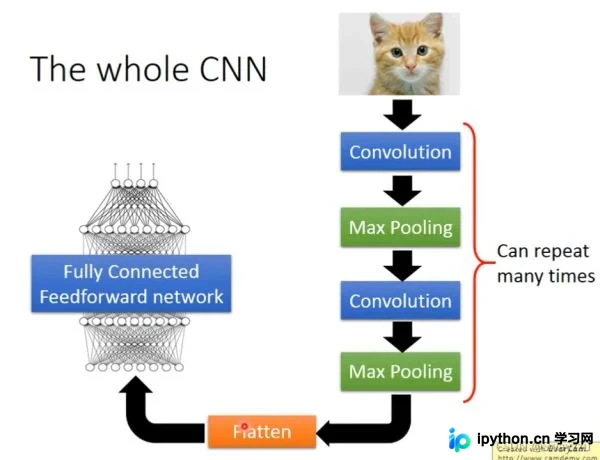
本文深入解析Python中卷积神经网络(CNN)的核心架构。详细阐述卷积层如何通过卷积核提取特征图,ReLU激活函数处理负值,以及池化层在降低数据量同时保留关键特征的作用。最后介绍全连接层如何整合高层特征进行分类,并简述反向传播更新参数的过程,帮助开发者理解CNN从输入到输出的完整逻辑。
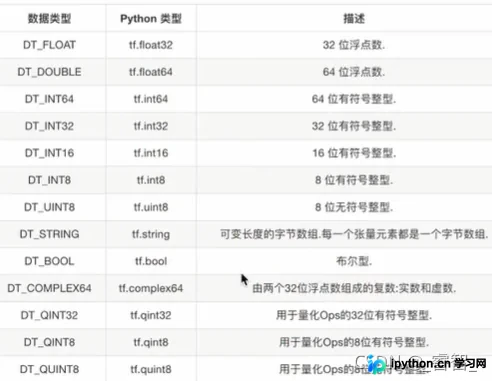
本文详解TensorFlow中张量与变量的核心概念。涵盖标量、向量、矩阵定义,介绍常数、随机张量创建方法,演示类型转换与形状重塑操作。同时阐述变量的定义、初始化及会话执行流程,帮助开发者掌握基础数据结构与操作。
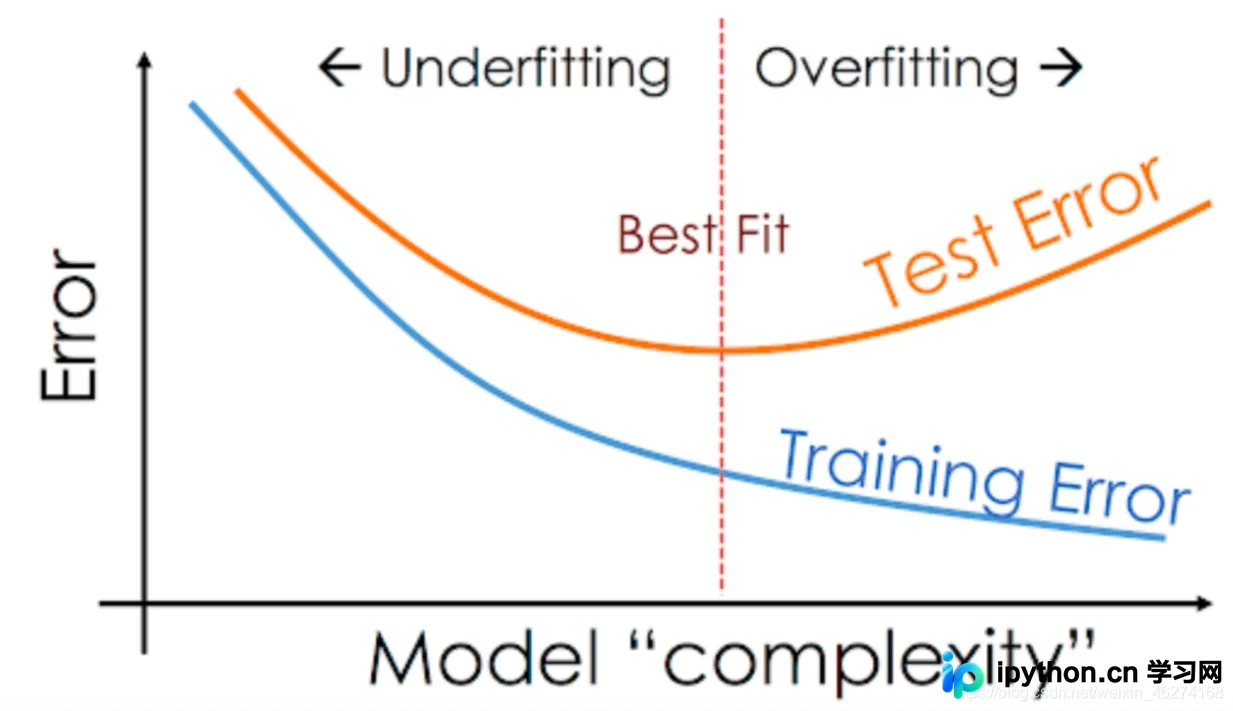
本文详解TensorFlow2中应对模型过拟合的五大策略。通过引入L2正则化约束参数、利用动量加速收敛、动态调整学习率、设置Early Stopping以及应用Dropout随机失活,有效提升测试集准确率。结合具体代码示例,帮助开发者构建更稳健的深度学习模型。
本文总结Python深度学习中的高级架构模式,重点解析残差连接如何解决梯度消失问题,以及深度可分离卷积(SeparableConv2D)在提升训练速度与精度方面的优势。通过Keras代码示例,展示标准化、残差块及轻量级卷积层的实际应用,帮助开发者构建更高效的大规模模型。
本文详解如何利用OpenCV的DNN模块加载并运行YOLOv3模型进行目标检测。文章梳理了从R-CNN到YOLO系列算法的演进,重点解析YOLOv3的多尺度预测架构。通过Python代码示例,演示了图像预处理、Blob转换、前向传播及非极大值抑制(NMS)的完整流程,旨在提供一份清晰、可复现的目标检测实现指南。
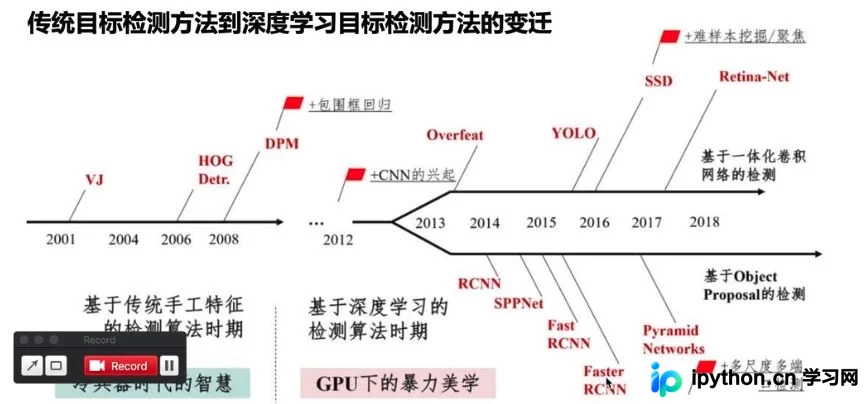
本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。
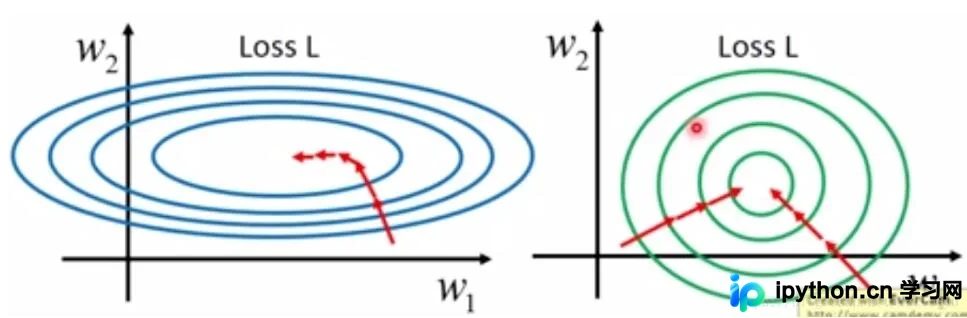
本文深入解析神经网络中的反向传播算法,阐述其通过计算成本函数对权重和偏置的偏导数来优化模型的核心原理。结合Python代码示例,详细演示Sigmoid与ReLU激活函数的导数计算,并提供完整的BP算法实现案例,帮助开发者掌握深度学习的基础训练机制。
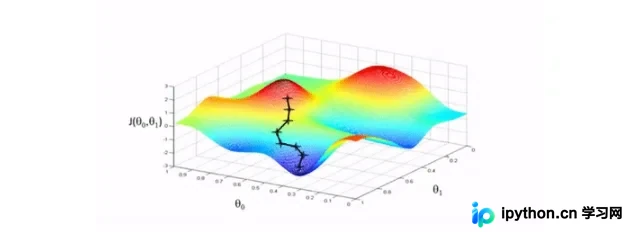
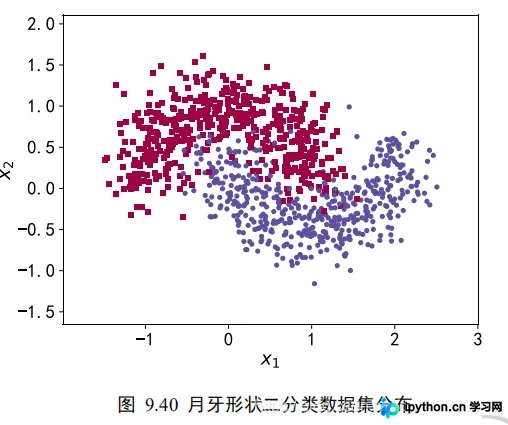
本文通过TensorFlow实战演示如何识别并解决过拟合问题。实验对比了不同网络层数、Dropout层数量及L2正则化系数对模型决策边界的影响。通过月牙数据集可视化,直观展示增加网络容量易导致过拟合,而合理引入Dropout和L2正则化能有效平滑决策边界,提升模型泛化能力。
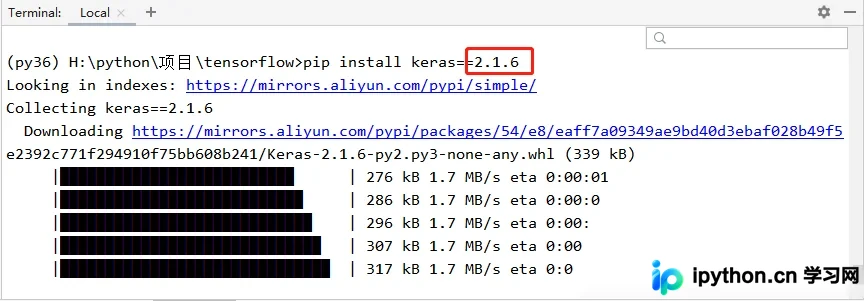
本文详细介绍在PyCharm环境中安装Keras及配置后端的方法。重点解决Python 2.7-3.6版本兼容性、指定镜像源安装、Git源码安装方式,以及tensorflow和theano后端的keras.json配置。针对版本冲突问题,提供了tensorflow 1.8.0和numpy 1.16.0的成功安装方案,帮助开发者快速完成环境搭建。
本文系统梳理Python深度学习中的四种核心激活函数:Sigmoid、Tanh、ReLU和SoftMax。通过数学公式、Python代码实现及函数图像,详细解析各函数的值域、梯度特性及适用场景,重点对比Sigmoid与Tanh的梯度消失问题,以及ReLU在收敛速度上的优势,并探讨SoftMax在多分类概率转化中的应用与数值稳定性处理。
本文介绍了8种最常用的Python工具,涵盖开发、自动化测试、数据科学与机器学习领域。包括内置的IDLE、机器学习的Scikit-learn、深度学习的Theano、自动化的Selenium与Test Complete,以及数据处理的Beautiful Soup、Pandas和线性规划工具PuLP。这些工具能显著提升开发效率与数据处理能力。