

Python深度学习RNN与LSTM模型结构详解

本文详细解析Python中RNN与LSTM模型的核心结构。介绍RNN隐藏层状态传递机制,区分Elman与Jordan网络,并深入讲解LSTM的门控机制(输入门、遗忘门、输出门)及数据流向。通过Python代码示例展示LSTM单元如何控制信息存储与输出,对比其与DNN的参数差异,帮助开发者理解长短期记忆网络的内部流程。
1.RNN基础模型
RNN的核心特性在于,DNN隐藏层的输出状态会被保存,并作为输入传递给下一个时间步的神经元。
如示意图所示,当输入词汇“台北”时,前一个时间步的上下文可能是“离开”或“到达”。若将上一时刻“离开”对应的隐藏层状态传入当前层,模型便能有效区分“离开台北”与“到达台北”这两种语义差异。
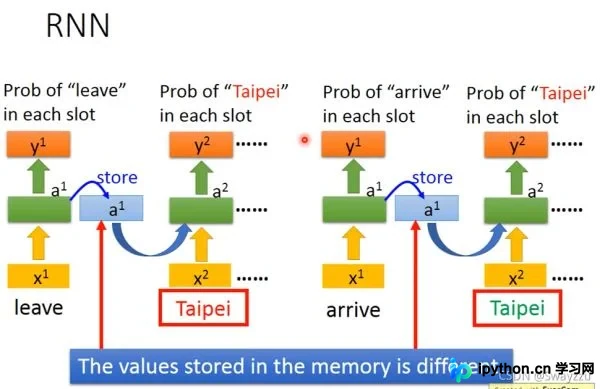
若隐藏层存储的状态被传递至下一时刻使用,该结构称为Elman Network。
若最终输出状态被传递至下一时刻使用,该结构称为Jordan Network。
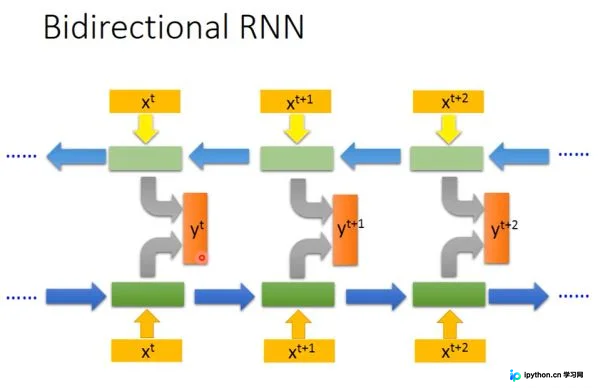
双向RNN机制:模型同时接收正向输入产生的存储状态和反向输入产生的存储状态,并将二者共同输入给后续层。
2.LSTM
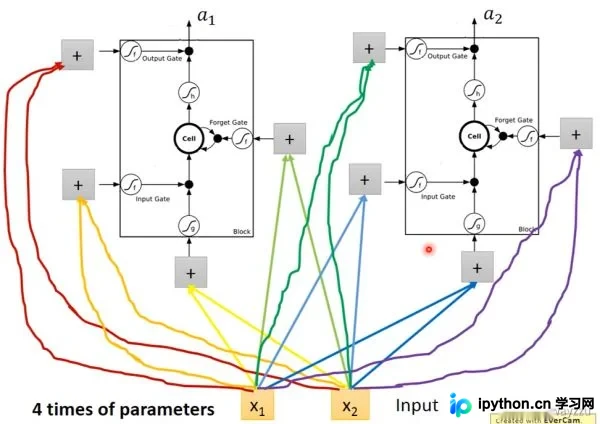
Long Short-term Memory(长短期记忆网络),在实际应用RNN时,通常指代的就是LSTM。每个LSTM单元除了接收输入数据外,还包含三个“门”结构,分别用于控制信息的输入、输出和存储。如图所示,每个LSTM单元包含4个输入接口和1个输出接口。
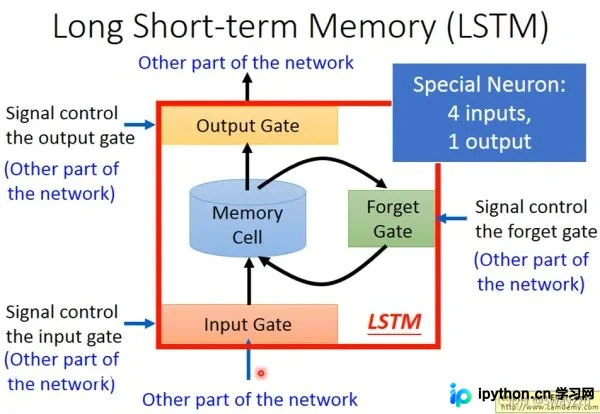
这些控制门均由向量表示,输入数据需经过sigmoid函数转换。计算后输出的值介于0到1之间,从而实现对输入、输出及存储行为的精细控制。门的参数由RNN模型在训练过程中自动学习得到。
3.流程结构
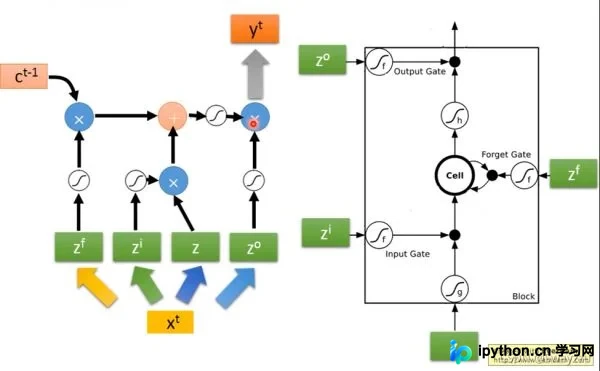
如流程图所示,假设输入为z,经过激活函数转换得到g(z)。输入门接收数据z(i),经sigmoid函数转换后,与g(z)相乘,得到g(z) * f(z(i))。
同理,当控制存储的门输出结果为1时,历史数据将与1相乘,并与上述计算结果相加,从而实现对历史存储数据的利用。若结果为0,则忽略历史数据,实现存储内容的更新或重置。
最终输出为h(c)。若输出门接收z0后的计算结果为0,则不产生输出;若结果为1,则允许数据输出。
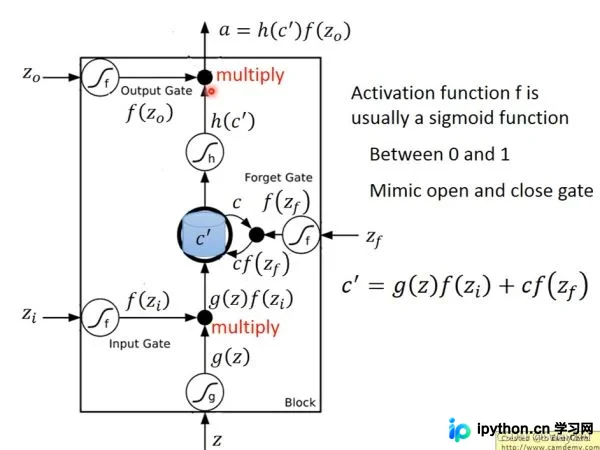
LSTM与DNN的主要区别在于将普通神经元替换为LSTM单元,输入数据乘以权重后控制各个门的状态。因此,LSTM的参数数量约为普通DNN的4倍。
整个流程可简化表示如下。
实际应用中,LSTM并非单一单元,而是多个单元组合。每个单元的输出及存储内容会作为输入传递给下一个单元。具体结构如下图所示。
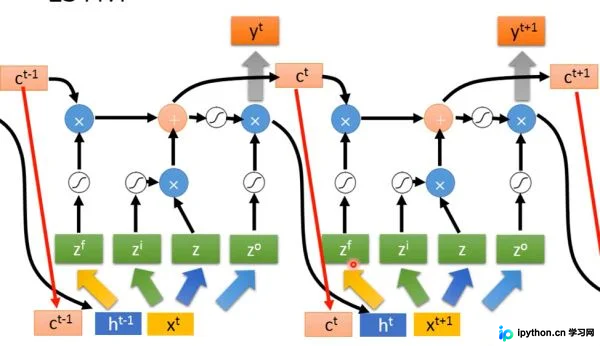
以上即为LSTM的整体结构说明。
Python人工智能深度学习RNN模型流程结构的详细内容今天就为大家讲解到这里了,更多关于RNN模型流程结构的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









