TensorFlow中通过assign更新变量值的正确方式
本文介绍在TensorFlow中如何正确更改变量的值。核心方法是使用tf.assign()创建更新操作,并必须在Session中通过run()执行该操作才能在图中生效。直接对Python变量赋值无效,且若传入非Tensor类型会导致AttributeError。
2026-10-13
7

本文介绍在TensorFlow中如何正确更改变量的值。核心方法是使用tf.assign()创建更新操作,并必须在Session中通过run()执行该操作才能在图中生效。直接对Python变量赋值无效,且若传入非Tensor类型会导致AttributeError。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文详细解析如何使用TensorFlow复现经典的AlexNet模型。重点还原了论文中双GPU并行的原始网络结构,而非常见的单GPU合并版本。文章涵盖模型定义、参数加载及测试流程,通过具体代码示例展示如何对渣土车等常见物体进行图像分类识别,适合希望深入理解AlexNet架构及熟悉TensorFlow操作的开发者参考。
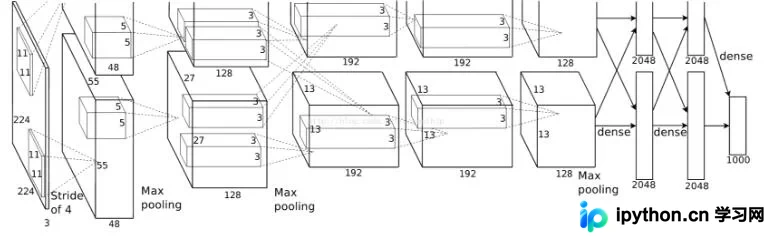
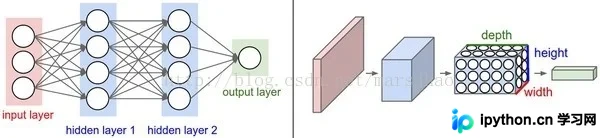
本文系统解析卷积神经网络(CNN)的核心机制,涵盖局部连接、权值共享及池化降采样等关键概念。详细阐述CNN标准结构组件,包括卷积层、ReLU激活与全连接层的组合策略,并深入探讨通过小滤波器组合、零填充及合理步长设置来大幅减少参数量、防止过拟合并提升模型泛化能力的具体实践方法。
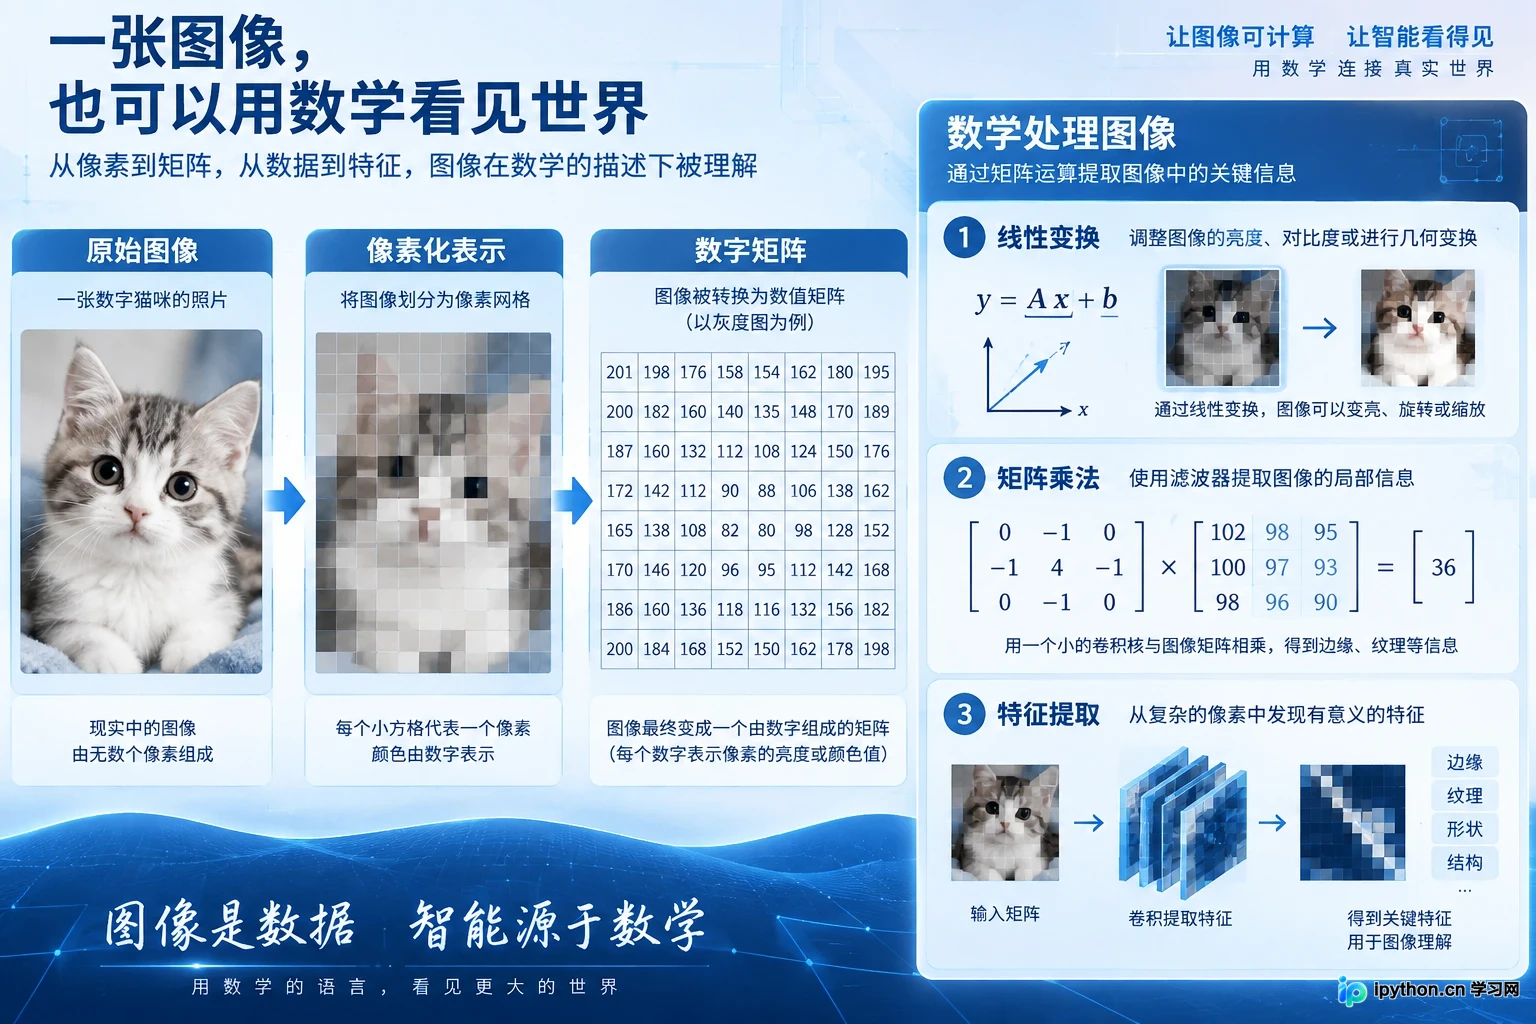
本文深入解析人工智能专业的核心课程体系,重点剖析线性代数、概率论等数学基础的实际应用价值,并客观评估编程与算法的学习难度。通过拆解从理论推导到工程落地的完整路径,帮助读者厘清AI专业的真实门槛,判断自身是否适合投身这一领域。
本文深入解析Python numpy库中np.random.seed()函数的核心机制与使用场景。通过对比实验,验证随机数种子对后续随机数生成的持续性影响,并探讨不同参数值如何确定随机序列的起始位置。文章指出种子参数仅作用于其定义后的下一次随机数生成,帮助开发者在机器学习和深度学习实验中实现结果的可复现性。
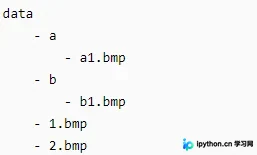
本文详解Python中遍历读取目录的两种常用方法:os.listdir与os.walk。os.listdir仅获取当前层级文件列表,而os.walk可递归遍历所有子目录。文章通过具体代码示例对比两者返回值差异,并提供了支持多后缀过滤、递归/非递归选项的完整封装函数,帮助开发者高效处理机器学习或深度学习中的文件读取需求。
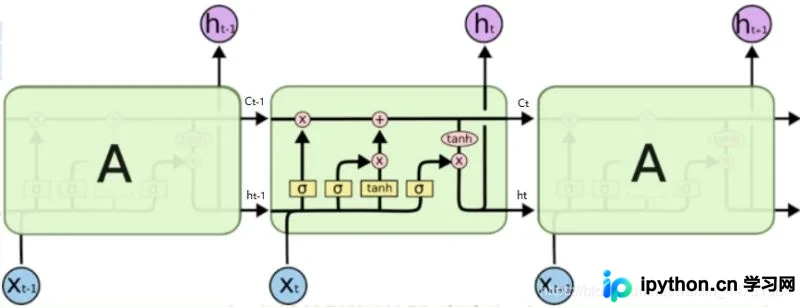
本文深入解析LSTM网络结构,详细讲解遗忘门、输入门和输出门的工作原理。重点阐述如何在Keras中通过units和input_shape参数配置LSTM,并逐步推导各门控机制的参数量计算公式。结合MNIST数据集示例代码,展示LSTM在序列数据处理中的实际应用与效果。
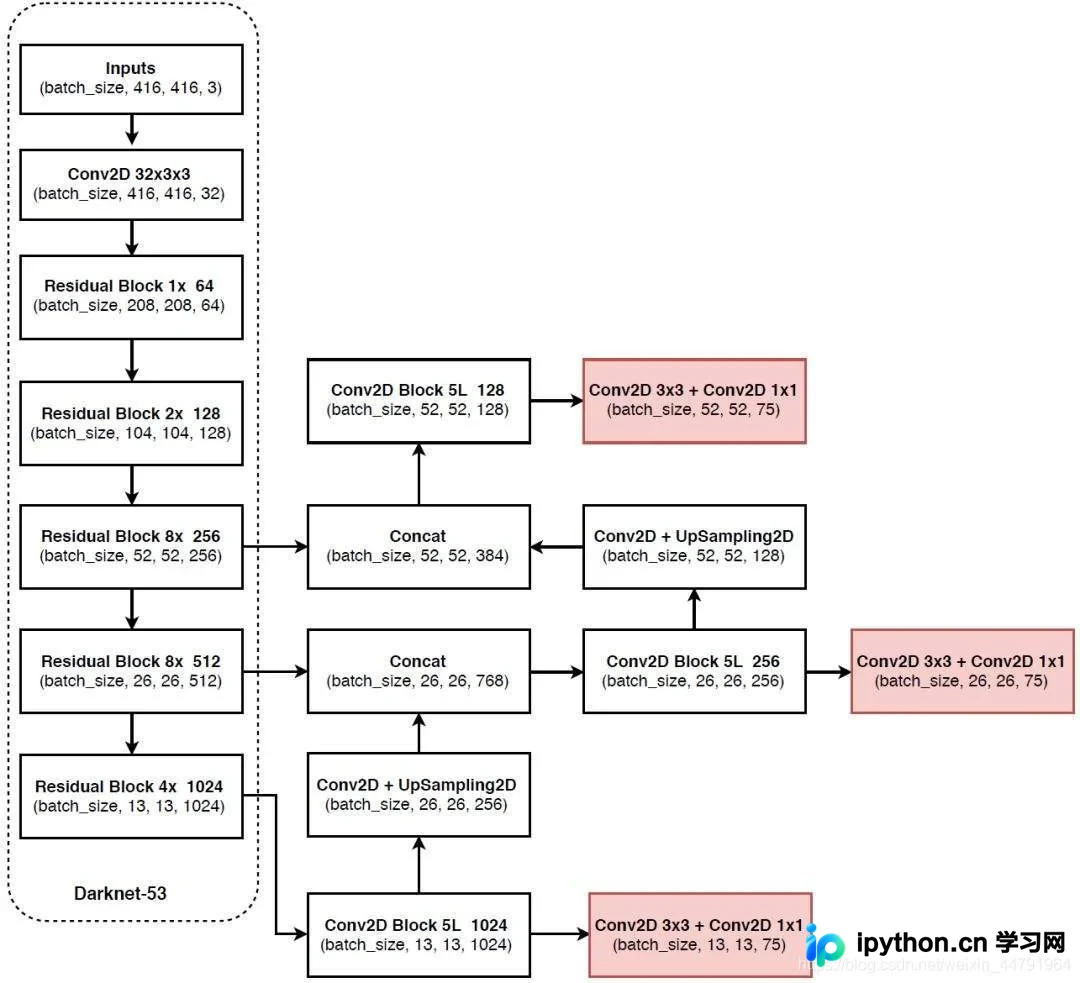
本文详细解析YOLO3目标检测模型的预测流程,涵盖Darknet53特征提取、多尺度特征层解码及非极大抑制筛选。通过Python代码复现,展示如何从网络输出还原边界框坐标与类别概率,并实现可视化结果。
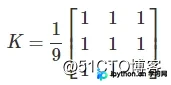
本文详细介绍 Python OpenCV 中的三种图像模糊(滤波)技术:均值滤波、高斯滤波及高斯双边滤波。通过解析 cv2.blur、cv2.GaussianBlur 和 cv2.bilateralFilter 函数的参数与原理,对比它们在去除椒盐噪声、高斯噪声及保边去噪方面的特性与适用场景,帮助开发者根据实际需求选择合适的滤波算法。
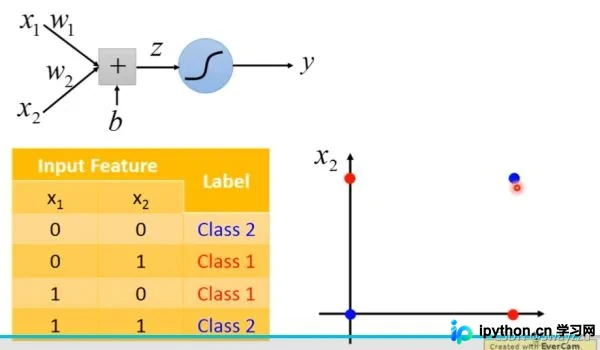
本文介绍Python深度学习入门知识,首先分析逻辑回归在非线性分类中的局限性,引出特征转换与多层逻辑回归的概念。随后阐述神经网络的基本结构、全连接机制及矩阵运算方式,并详解交叉熵损失函数的计算原理,帮助初学者理解深度学习核心逻辑。
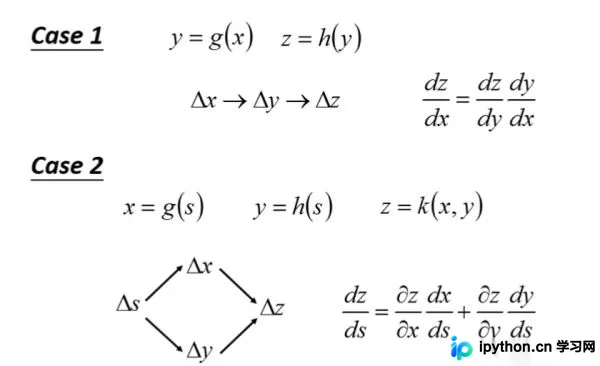
本文深入解析Python深度学习中的BackPropagation(反向传播)算法,重点阐述如何利用链式法则计算损失函数对参数的梯度。通过前向传播获取中间变量,再经反向传播逐层推导偏导数,最终结合梯度下降法优化模型参数,实现神经网络的有效训练。