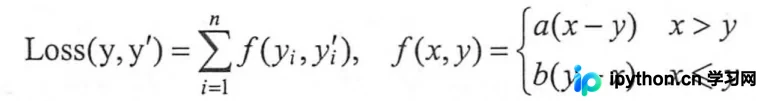学习Python需要什么样的电脑配置?
学习Python对电脑配置要求因方向而异。基础语法和Web开发普通办公电脑即可;大数据开发需大内存(至少8G)以支持虚拟机集群;AI与深度学习需高性能GPU(如1080Ti或更高)及强劲CPU。建议根据学习阶段选择合适硬件,并预留升级空间。
2026-10-15
6

学习Python对电脑配置要求因方向而异。基础语法和Web开发普通办公电脑即可;大数据开发需大内存(至少8G)以支持虚拟机集群;AI与深度学习需高性能GPU(如1080Ti或更高)及强劲CPU。建议根据学习阶段选择合适硬件,并预留升级空间。
本文详解在深度学习训练中如何使用Keras进行数据切分,包括通过validation_split自动切分验证集和结合Sklearn手动指定验证集两种方法。同时深入解析K折交叉验证原理,展示利用StratifiedKFold进行分层抽样的完整代码示例,并厘清训练集、验证集与测试集的核心区别,帮助开发者更准确地评估模型泛化能力。
本文介绍在TensorFlow中扩展矩阵维度的两种方法:传统的tf.expand_dims()函数以及利用索引操作符[]配合tf.newaxis的新技巧。通过具体代码示例,展示如何灵活地在指定维度插入新轴,适用于文本挖掘、卷积神经网络等场景中的张量形状调整。
本文深入解析TensorFlow两大核心组件:计算图(tf.Graph)与会话(tf.Session)。详细阐述如何通过tf.Graph构建神经网络的数据流与依赖关系,以及利用tf.Session执行具体计算、管理变量初始化的完整流程。结合代码示例说明节点生成、变量初始化及sess.run()参数用法,帮助开发者理解TensorFlow静态计算图的设计哲学与运行机制。
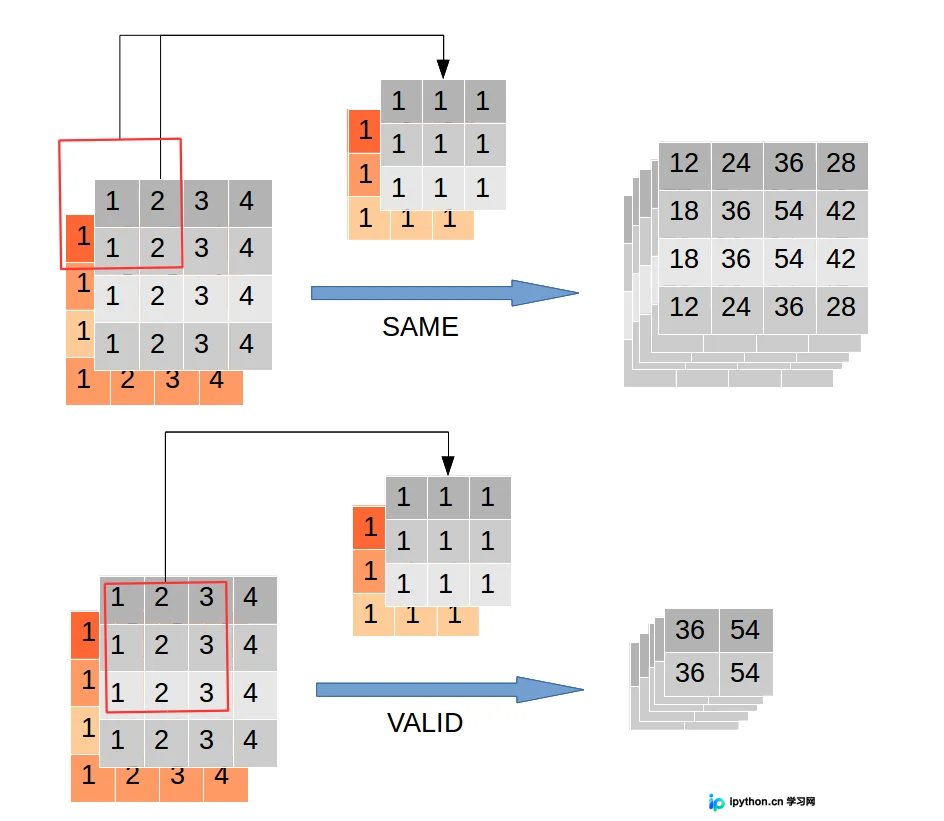
本文深入解析TensorFlow中tf.nn.atrous_conv2d函数的实现原理,重点讲解rate参数如何控制采样间隔以扩大感受野。通过对比rate=1与普通卷积,以及rate=2在SAME和VALID模式下的输出差异,直观展示空洞卷积机制。文章包含完整代码示例与结果分析,帮助开发者掌握该技术在语义分割中的应用。
本文深入解析 TensorFlow 中 tf.nn.softmax_cross_entropy_with_logits 函数的内部机制。该函数将 softmax 归一化与交叉熵计算合并,直接接收 logits 和真实标签。文章详细说明了参数含义、数学公式推导,并通过 Python 代码对比手动计算与函数调用的结果,帮助开发者理解其返回值特性及 reduce_sum/mean 的必要性。
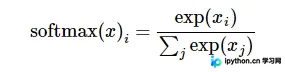
本文介绍如何使用Python的xml.dom.minidom模块读取XML格式的深度学习标注数据,并提取图片文件名及目标对象的边界框坐标,最终写入TXT文件。通过具体代码示例,展示了从解析XML树结构到格式化输出坐标信息的完整流程,适用于统一不同格式标注数据的场景。
本文介绍在 TensorFlow 中通过固定随机数种子来确保神经网络训练结果可复现的方法。针对参数初始化和数据读取中的随机操作,使用 tf.set_random_seed 函数设置统一种子,从而在输入数据相同的情况下获得一致的训练输出。
本文详细解析TensorFlow中卷积操作的梯度反向传播机制,涵盖Valid和Same两种填充模式。通过具体示例展示如何对未知输入张量和未知卷积核分别求导,并介绍tf.nn.conv2d_backprop_input与tf.nn.conv2d_backprop_filter函数的使用方法及代码实现,帮助开发者深入理解卷积层训练过程中的梯度计算逻辑。
本文详细介绍如何在 TensorFlow 中自定义神经网络层。通过继承 tf.keras.Layer 类实现 __init__、build 和 call 方法,可灵活创建特定业务逻辑的层。同时,利用 tf.keras.Model 组合现有层构建复杂网络结构,如 ResNet 残差块,帮助开发者掌握模型架构设计的核心技巧。
本文详解TensorFlow中实现变量累加的两种方法。由于Python变量引用机制,tf.add仅返回新张量而不修改原变量,适用于无状态计算;而tf.assign_add能原地更新Variable状态,是实现迭代计数器、学习率调度等需要累积状态场景的正确选择。
本文介绍如何在TensorFlow中通过自定义损失函数来优化商品销量预测模型。传统均方误差可能忽略成本与利润差异,本文通过设定不同预测偏差的惩罚系数,使模型更贴合实际商业利益。结合具体代码示例,展示如何利用tf.greater和tf.where构建非对称损失函数,并验证其对预测结果的影响。