

TensorFlow2模型防过拟合:正则化、动量与Dropout实战指南

本文详解TensorFlow2中应对模型过拟合的五大策略。通过引入L2正则化约束参数、利用动量加速收敛、动态调整学习率、设置Early Stopping以及应用Dropout随机失活,有效提升测试集准确率。结合具体代码示例,帮助开发者构建更稳健的深度学习模型。
过拟合
当训练集准确率极高,而测试集表现糟糕时,即表明模型出现了过拟合(Overfitting)现象。具体表现可参考下图:
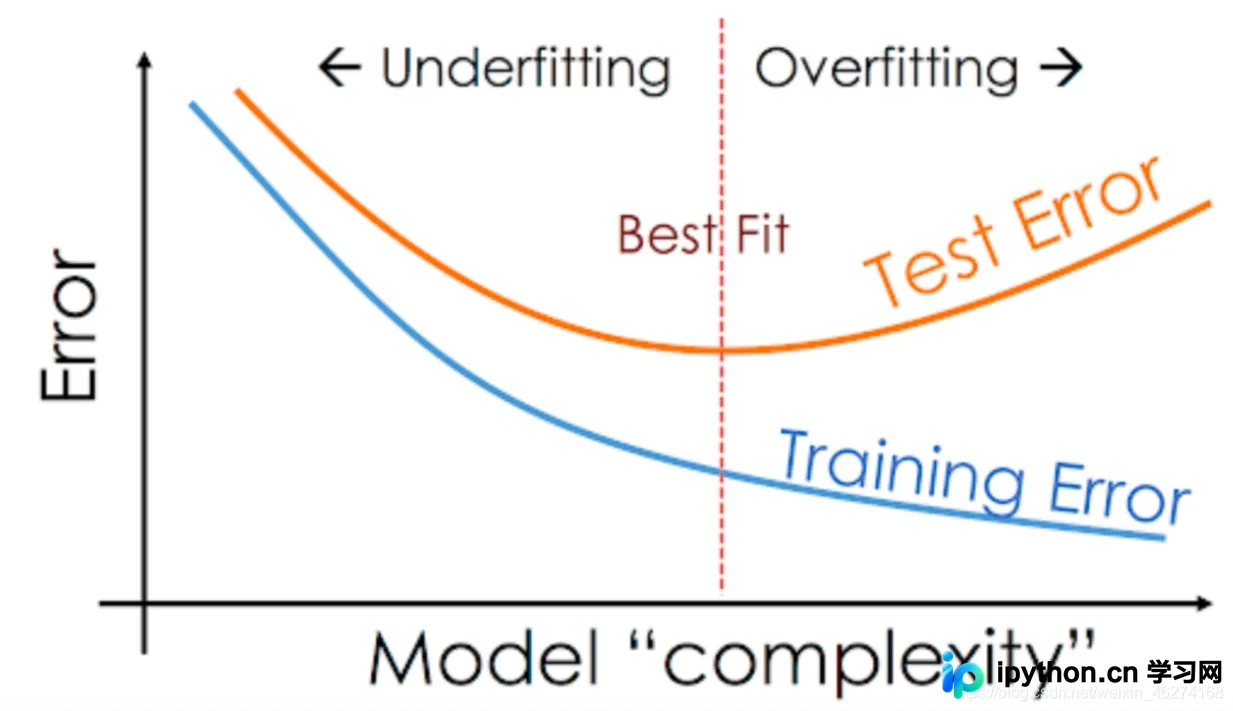
导致过拟合的主要原因之一是模型结构过于复杂。下文将介绍5种有效缓解过拟合、提升模型泛化能力的方法。
正则化(Regularization)
正则化技术通过限制待优化参数的范围,有效防止模型在训练数据上过度拟合。
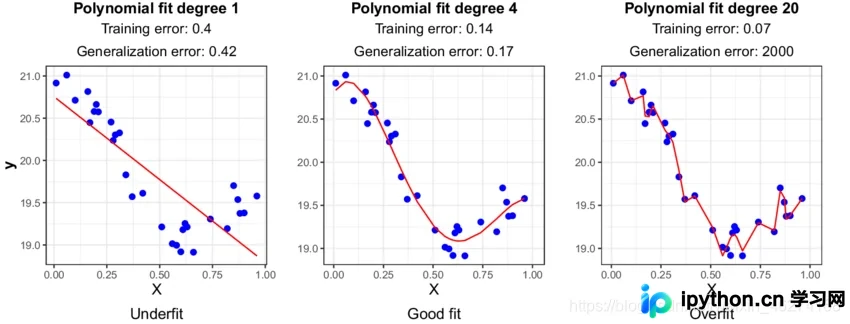
损失函数公式
未引入正则化时的原始损失函数为:
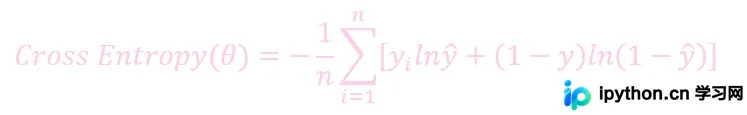
引入正则化项后的损失函数变为:
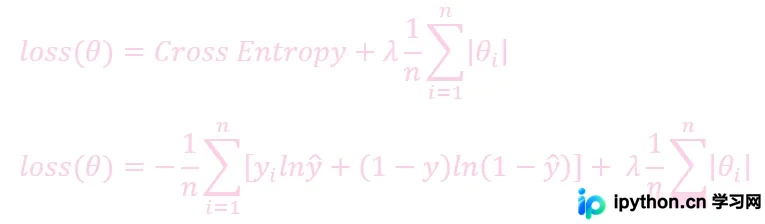
参数λ的作用类似于学习率(learning rate)。λ值越大,正则化的约束力度越强,导致权重值趋向于更小,从而简化模型。
代码示例
以下网络结构添加了L2正则化:
network = tf.keras.Sequential([
    tf.keras.layers.Dense(256, kernel_regularizer=tf.keras.regularizers.l2(0.001), activation=tf.nn.relu),
    tf.keras.layers.Dense(128, kernel_regularizer=tf.keras.regularizers.l2(0.001), activation=tf.nn.relu),
    tf.keras.layers.Dense(64, kernel_regularizer=tf.keras.regularizers.l2(0.001), activation=tf.nn.relu),
    tf.keras.layers.Dense(32, kernel_regularizer=tf.keras.regularizers.l2(0.001), activation=tf.nn.relu),
    tf.keras.layers.Dense(10)
])
动量(Momentum)
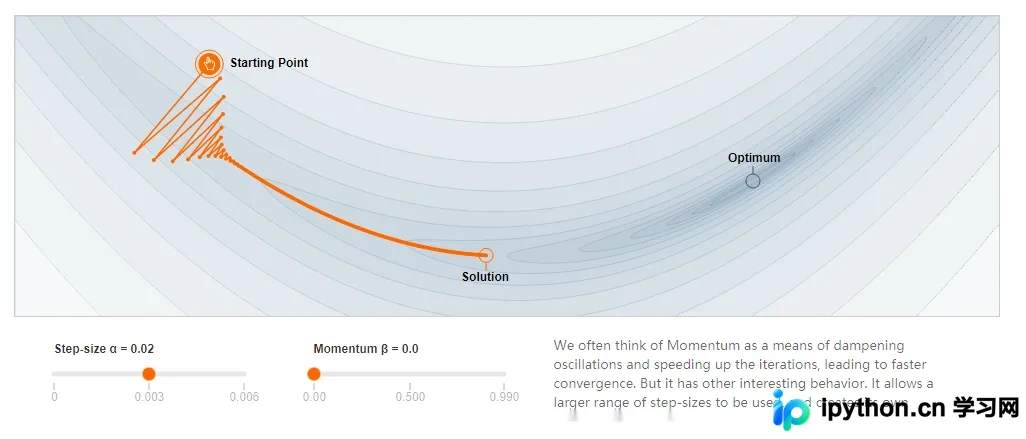
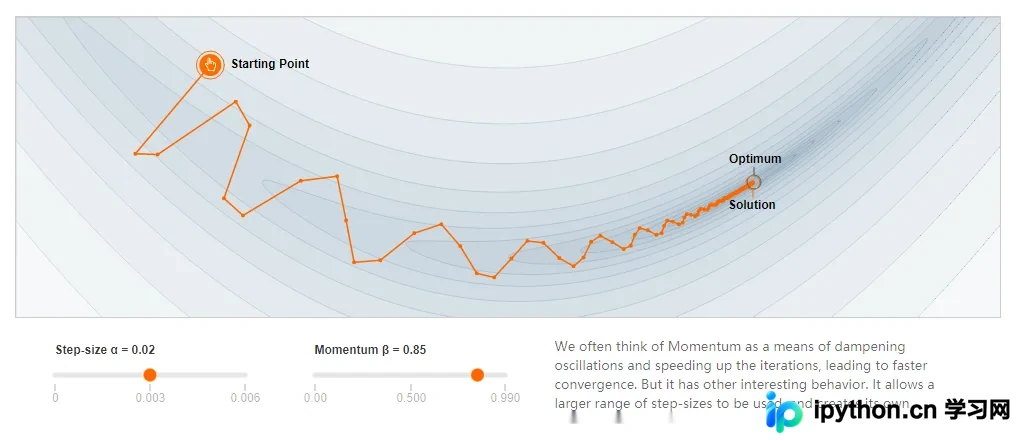
动量模拟了物理运动中的惯性效应。在梯度下降过程中,通过优化器引入动量,可以减少参数更新的震荡,从而更快、更稳定地收敛到最优解。
未使用动量的更新轨迹:
使用动量后的更新轨迹:
数学公式
未加动量的权重更新公式:
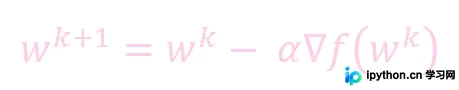
- w:权重(weight)
- k:迭代次数
- α:学习率(learning rate)
- ∇f():梯度(微分)
加入动量后的权重更新公式:
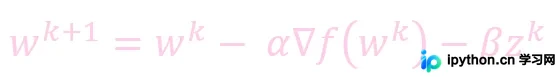
- β:动量系数(momentum weight)
- z:历史梯度累积值
代码示例
配置了动量的优化器示例:
optimizer = tf.keras.optimizers.SGD(learning_rate=0.02, momentum=0.9)
optimizer = tf.keras.optimizers.RMSprop(learning_rate=0.02, momentum=0.9)
注意:Adam优化器默认已包含动量机制,因此使用Adam时无需手动添加动量参数。
学习率衰减(Learning Rate Decay)
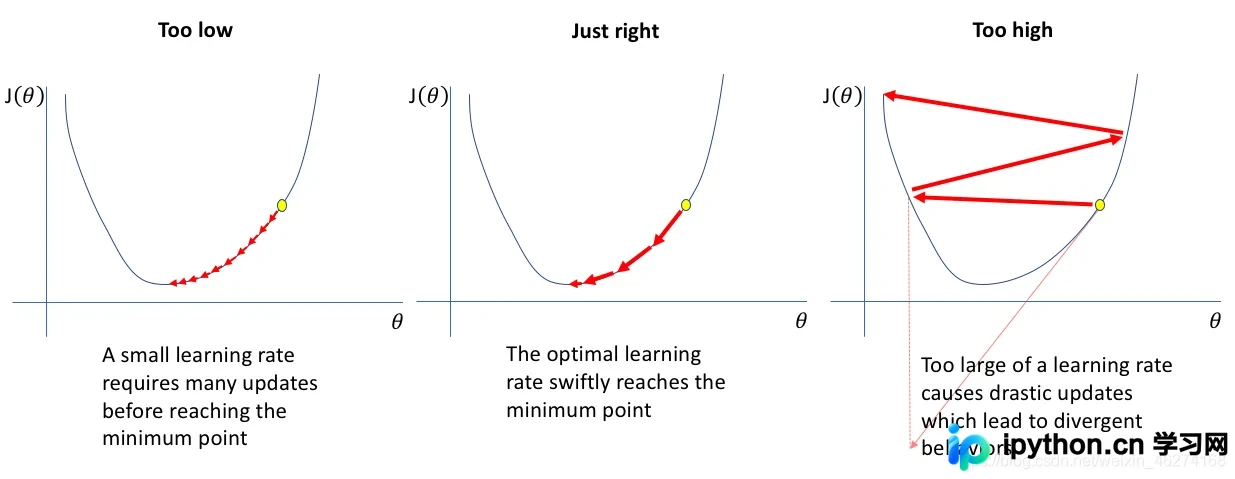
简而言之,较大的学习率能加快训练速度,但可能难以收敛到最优解;较小的学习率虽然训练较慢,但找到全局最优解的概率更高。
实施策略
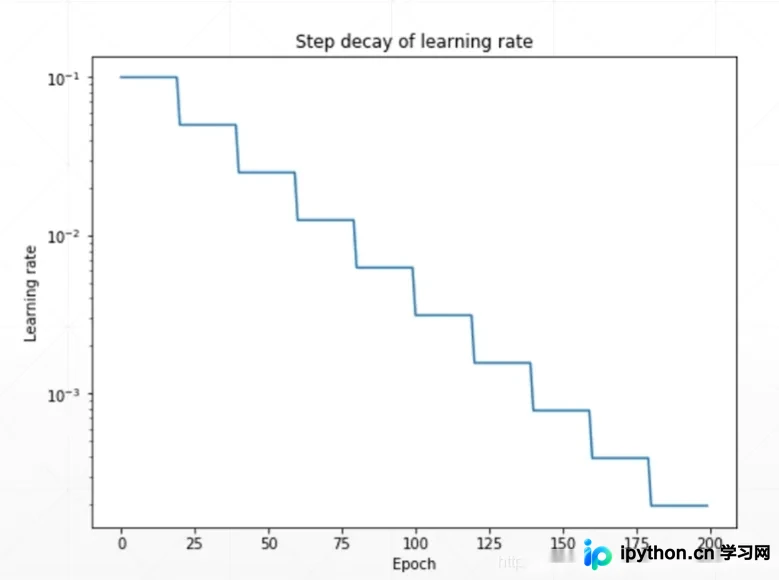
建议在训练初期使用较大的学习率以加速网络收敛,而在训练后期减小学习率,以便更精细地调整参数,获得更好的收敛效果。具体过程如下图所示:
代码示例
learning_rate = 0.2  # 学习率
optimizer = tf.keras.optimizers.SGD(learning_rate=learning_rate, momentum=0.9)  # 优化器

# 迭代
for epoch in range(iteration_num):
    optimizer.learninig_rate = learning_rate * (100 - epoch) / 100  # 学习率递减
早停法(Early Stopping)
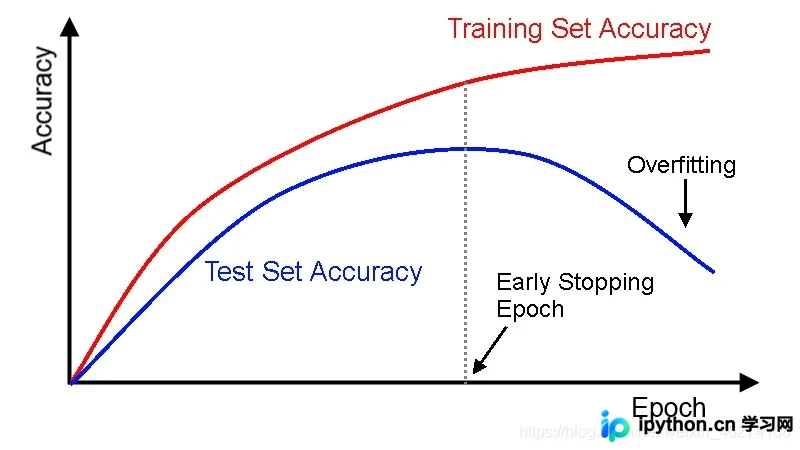
前文提到,当训练集准确率持续上升,而测试集准确率开始下降时,即发生了过拟合。
早停法(Early Stopping)通过在监控到测试集准确率下降时立即停止训练,有效避免了因继续训练而导致的过拟合问题。
Dropout(随机失活)
少学一点,学得更好(Learning less to learn better)
Dropout技术在每个训练批次中随机忽略部分特征,从而显著降低过拟合风险。
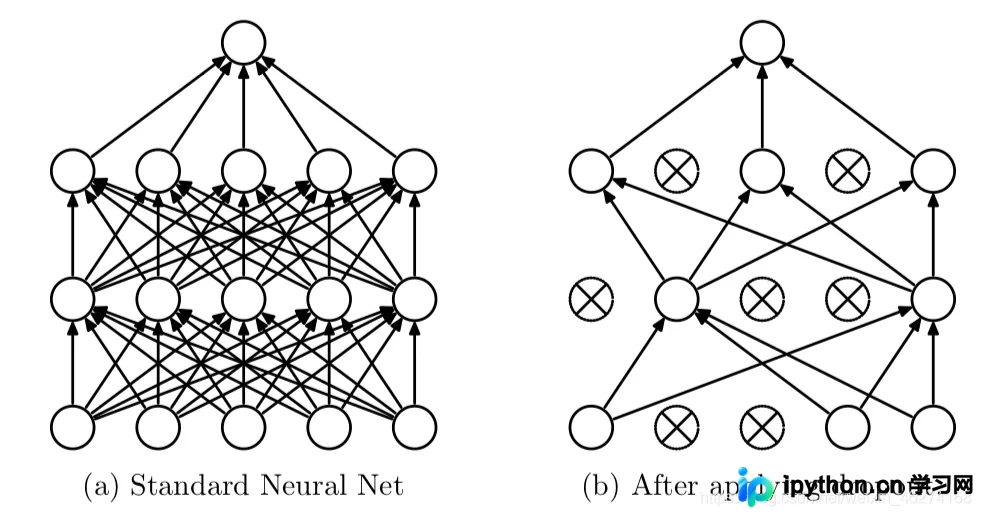
Dropout通过强制神经元与其他随机选出的神经元协同工作,消除了神经元节点间不必要的联合适应性,从而增强了模型的泛化能力。
代码示例:
network = tf.keras.Sequential([
    tf.keras.layers.Dense(256, activation=tf.nn.relu),
    tf.keras.layers.Dropout(0.5),  # 忽略一半
    tf.keras.layers.Dense(128, activation=tf.nn.relu),
    tf.keras.layers.Dropout(0.5),  # 忽略一半
    tf.keras.layers.Dense(64, activation=tf.nn.relu),
    tf.keras.layers.Dropout(0.5),  # 忽略一半
    tf.keras.layers.Dense(32, activation=tf.nn.relu),
    tf.keras.layers.Dense(10)
])
本文介绍了TensorFlow2中大幅提高模型准确率的几种关键方法。如需了解更多TensorFlow2相关内容,请查阅本站往期文章或继续关注后续更新。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









