拒绝双写失控:用 Lindorm 数据订阅梳理一致性方案
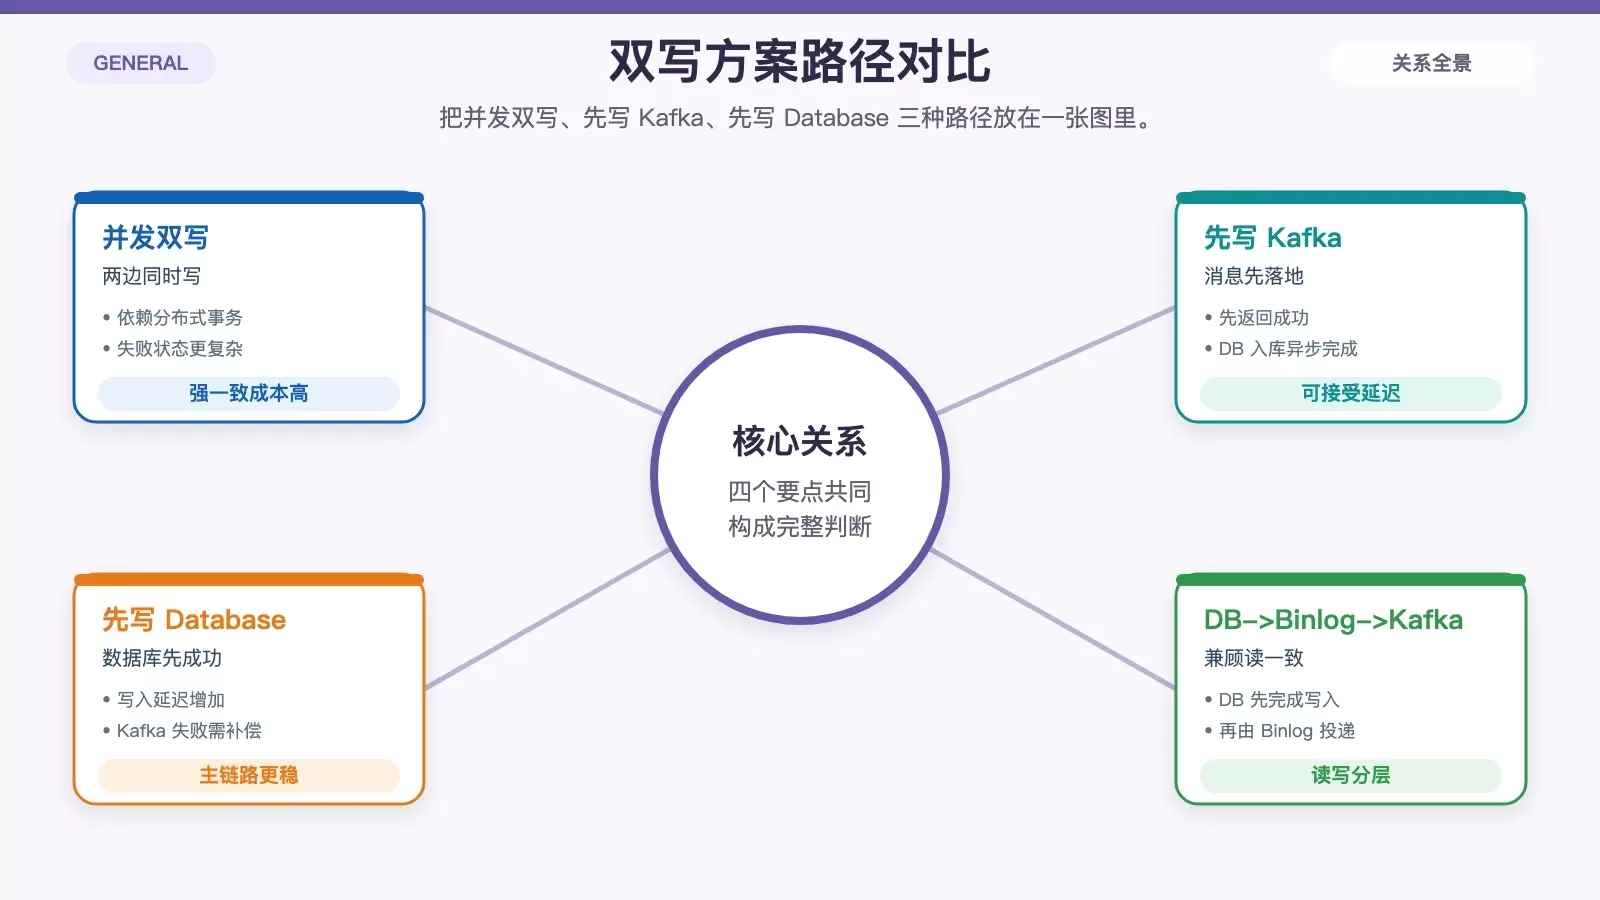
双写问题的核心难点不在“写两次”,而在两个独立系统之间如何拿到可接受的一致性。本文把并发双写、先写消息、先写数据库三种方案拆开说明,再结合 Lindorm 数据订阅,解释为什么在既要数据库强一致读、又要下游异步分发时,DB->Binlog->Kafka 是更实用的选择。
2026-08-24
71

双写问题的核心难点不在“写两次”,而在两个独立系统之间如何拿到可接受的一致性。本文把并发双写、先写消息、先写数据库三种方案拆开说明,再结合 Lindorm 数据订阅,解释为什么在既要数据库强一致读、又要下游异步分发时,DB->Binlog->Kafka 是更实用的选择。
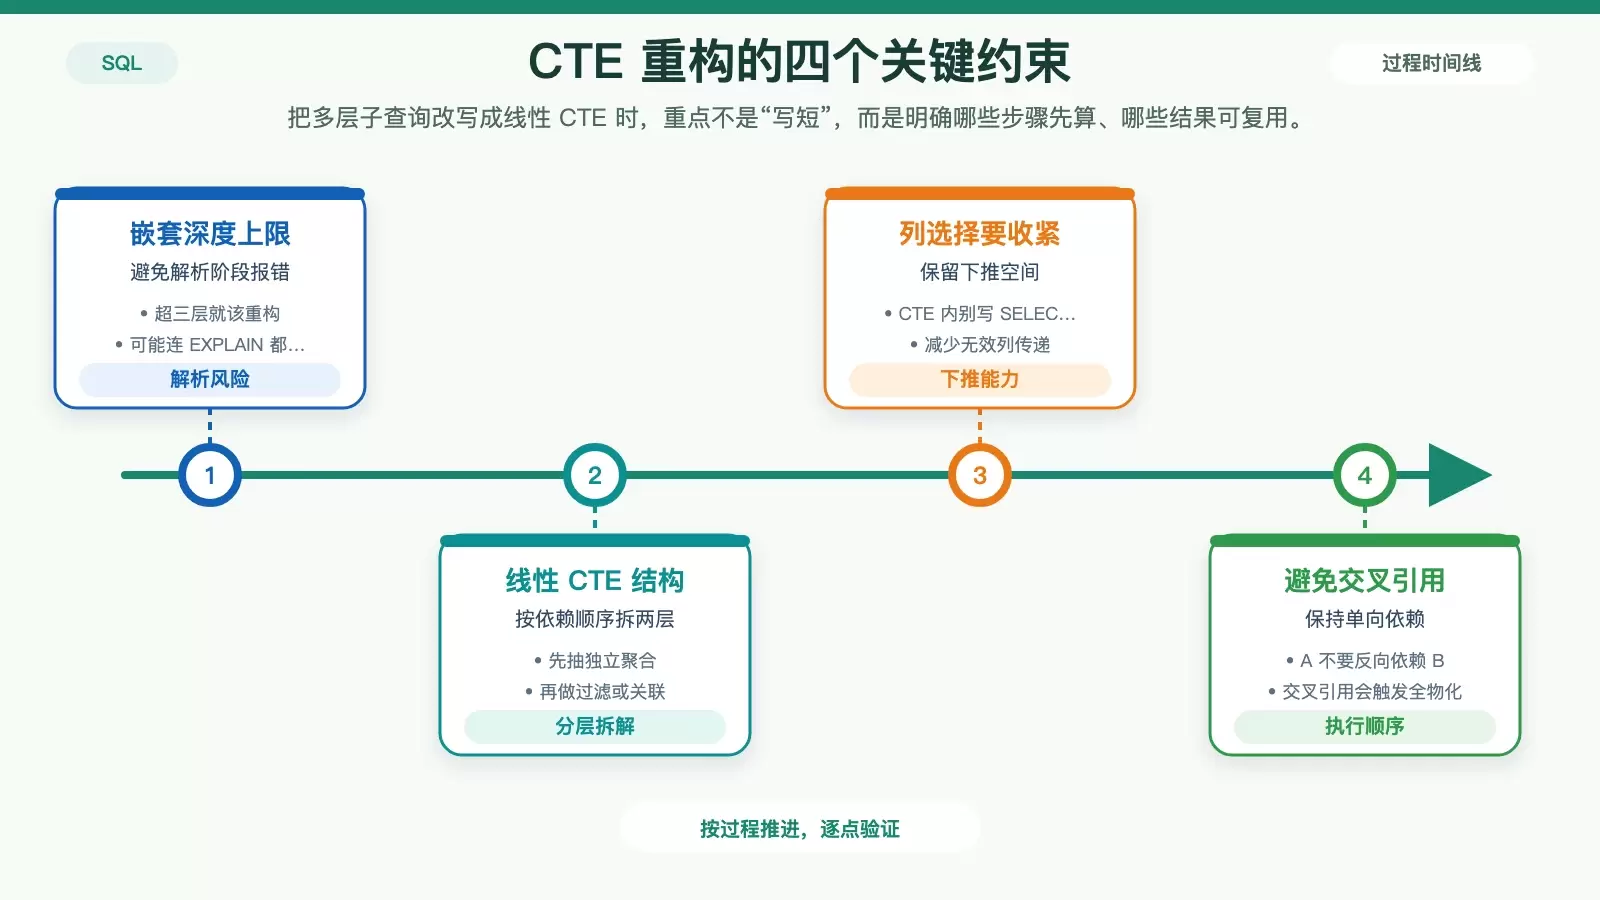
SQL 嵌套超过三层,问题往往不只是“难读”,还可能在解析、优化和执行阶段直接踩到数据库限制。本文按 CTE、临时表、JOIN 替换和视图拆链四个场景,整理一套可落地的重构判断方法,帮助你在改写 SQL 时同时兼顾正确性、可维护性和性能。
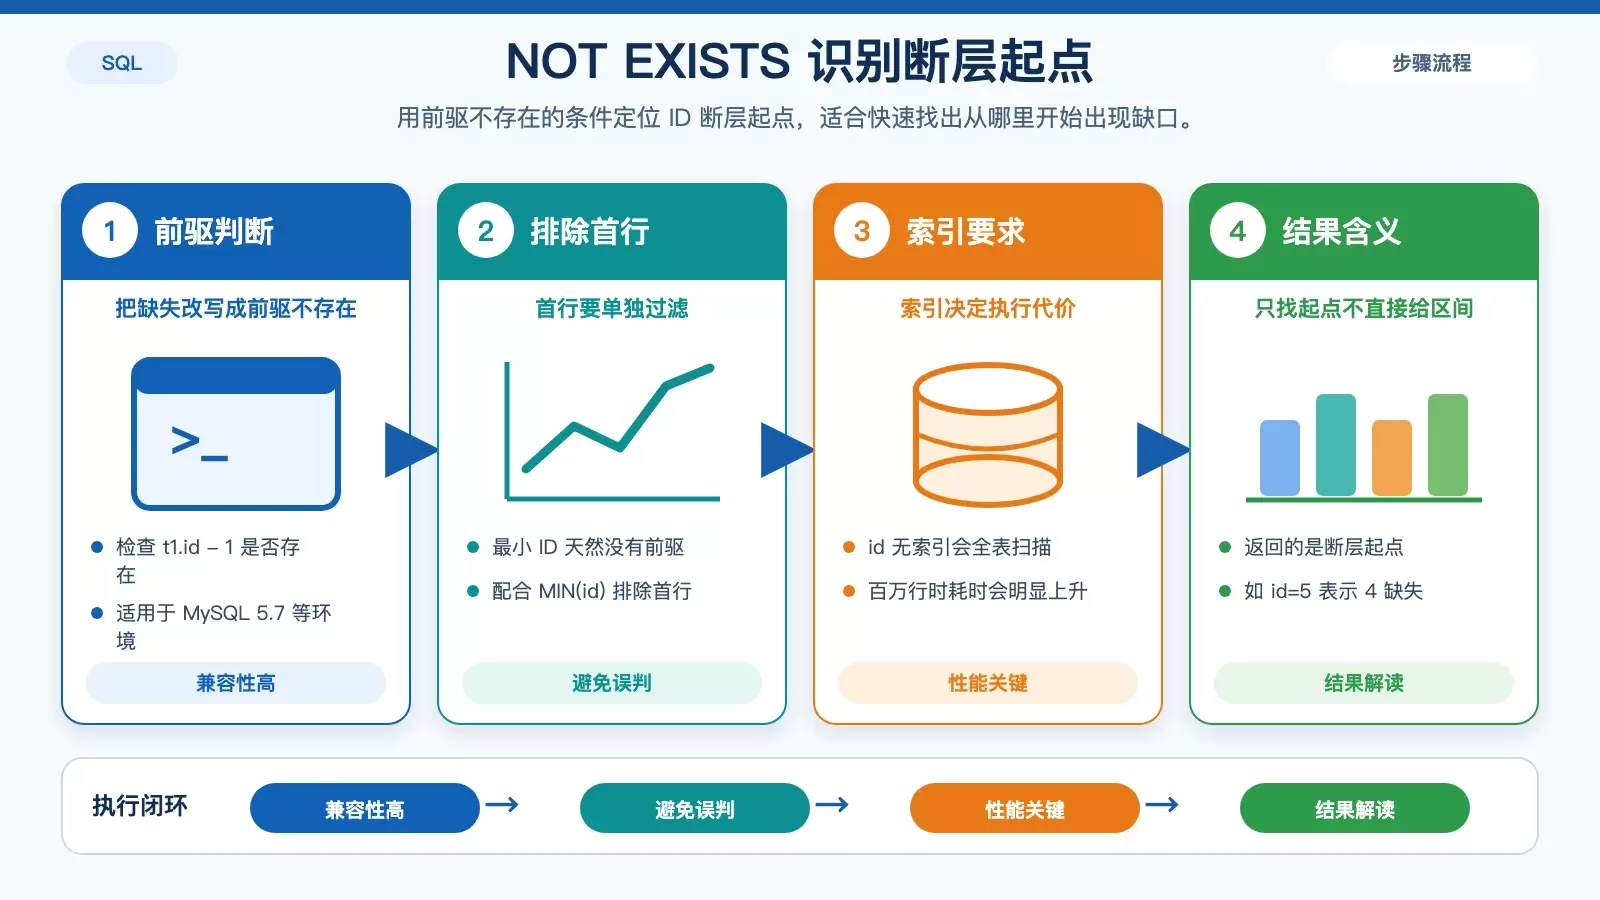
子查询并不会自动识别“数据断档”,真正决定结果的是你如何把“前驱缺失”“区间补全”这类对比关系写清楚。本文围绕 `NOT EXISTS`、`EXCEPT`/序列生成,以及模拟 `LAG()` 的常见陷阱,梳理不同数据库里的可用写法、适用前提与性能边界。
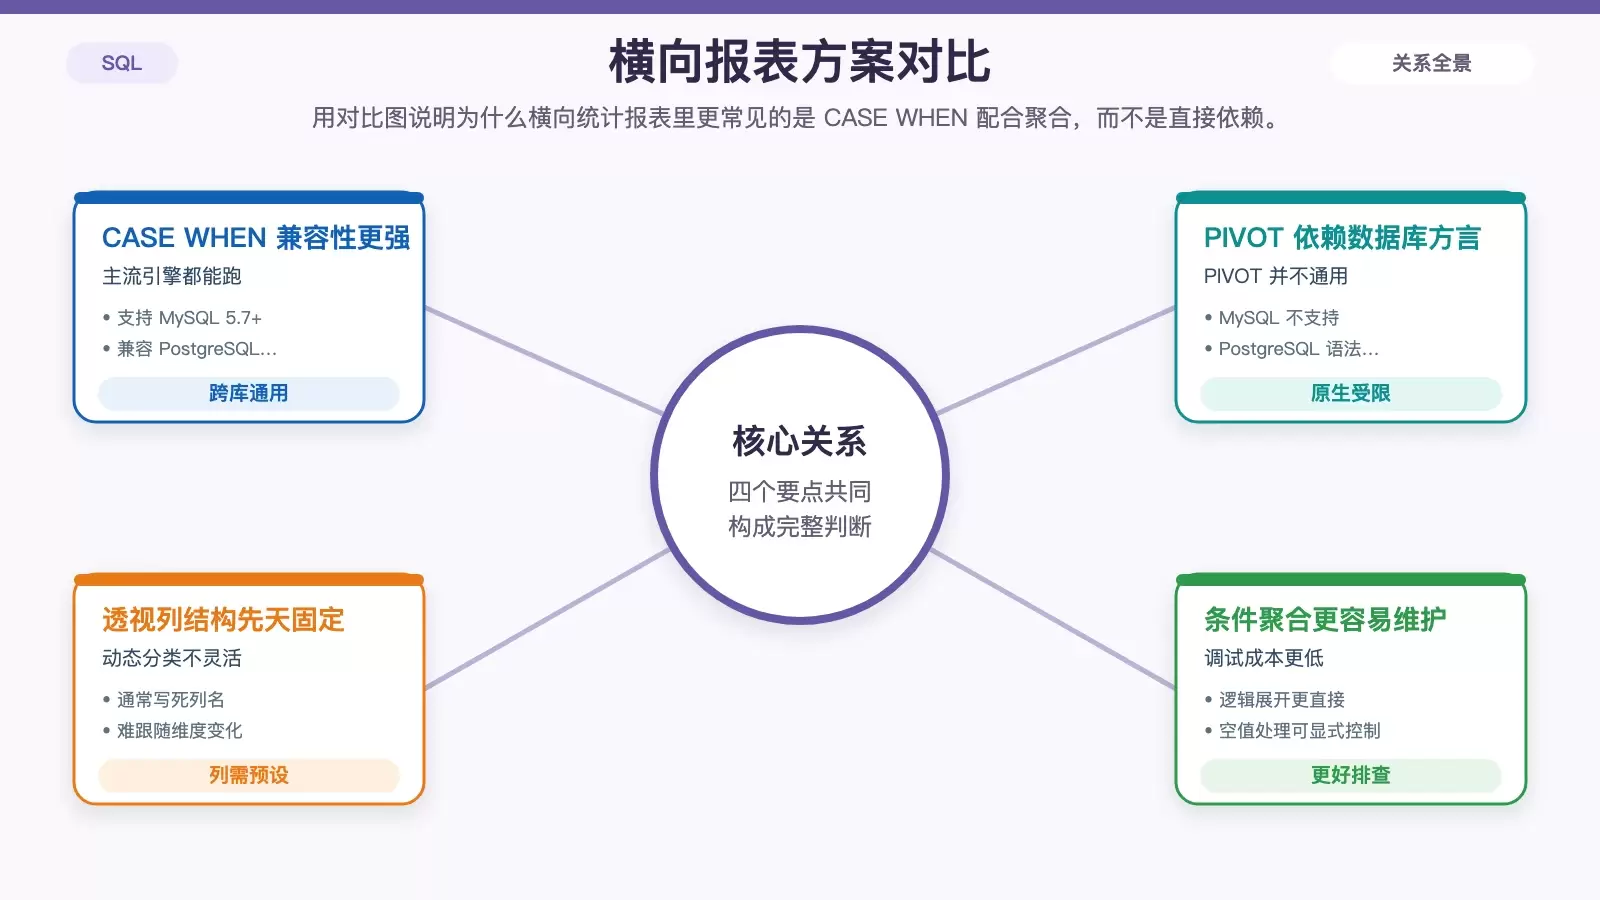
在 SQL 里做横向统计报表时,`SUM(CASE WHEN ...)` 往往比 `PIVOT` 更实用,因为它跨数据库可用、逻辑直观,也更方便处理空值与动态分类。本文结合常见踩坑,说明何时该用 `SUM`、何时该用 `MAX` 或 `COUNT`,以及分类不固定时该怎样设计。
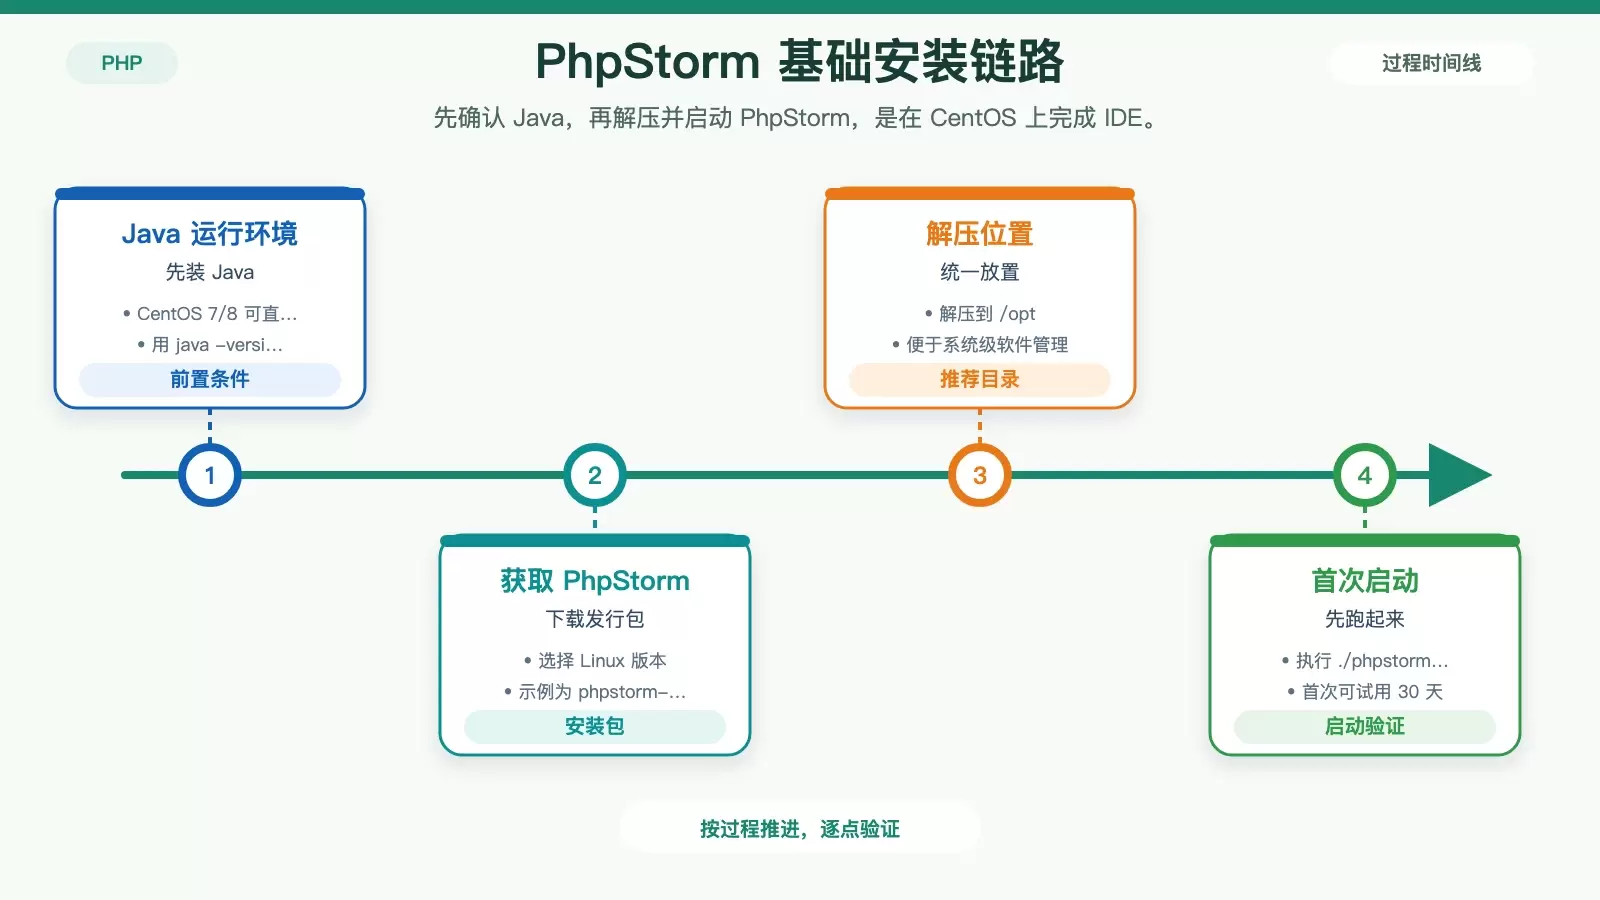
这篇文章把 CentOS 上使用 PhpStorm 的关键步骤重新梳理成一条可执行路径:先准备 Java 运行环境,再完成软件安装、PHP 解释器接入,以及调试、Git、数据库等常见能力配置。适合刚进入 Linux 开发环境、希望少走弯路的 PHP 开发者。
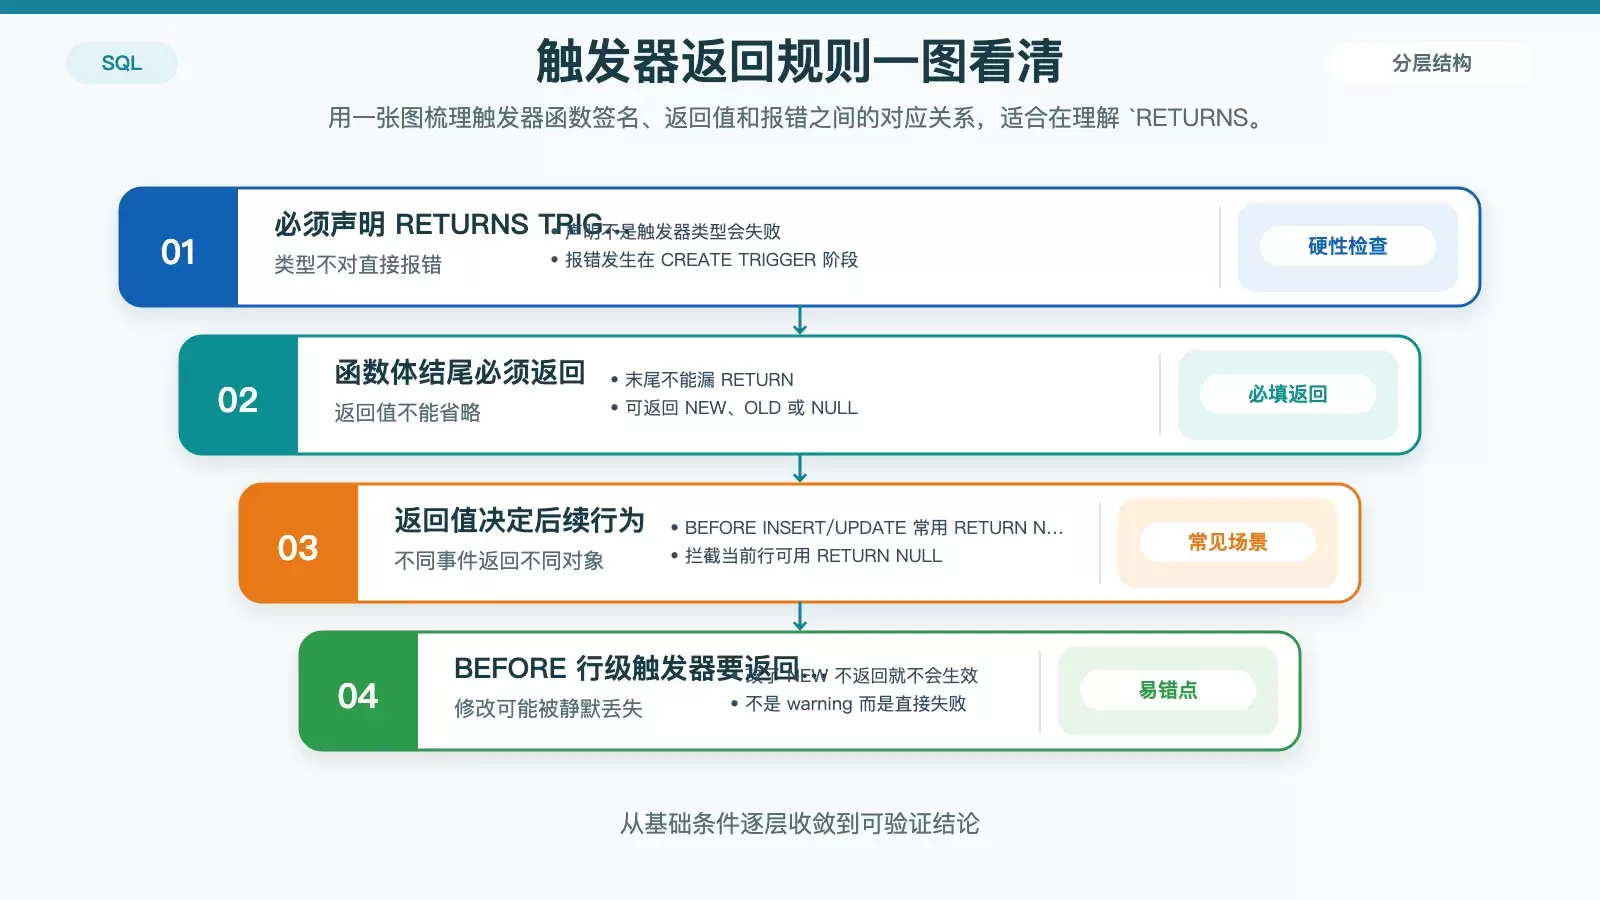
在 PostgreSQL 14 里,SQL 触发器函数有几条不能踩的硬规则:返回类型必须是 `TRIGGER`,结尾必须返回 `NEW`、`OLD` 或 `NULL`;动态 SQL 里表名、列名要用 `format('%I', ...)`;`NEW` 和 `OLD` 只能按 `TG_OP` 对应场景访问。再加上行级触发器在批量更新时的性能成本,这些细节决定了触发器是稳定运行还是一上生产就报错。
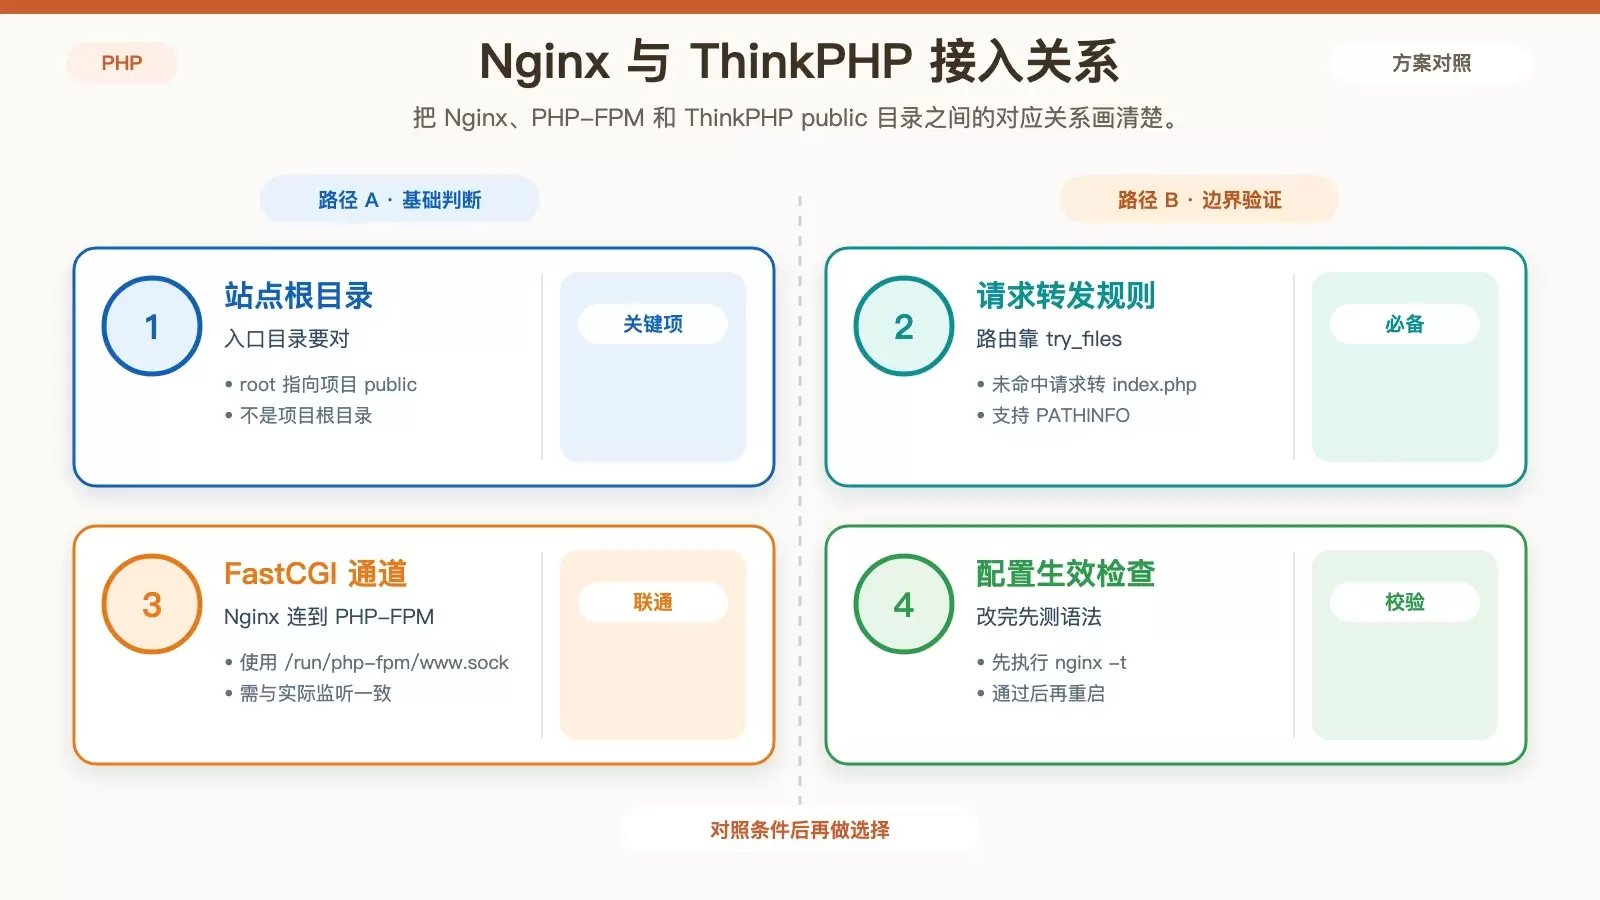
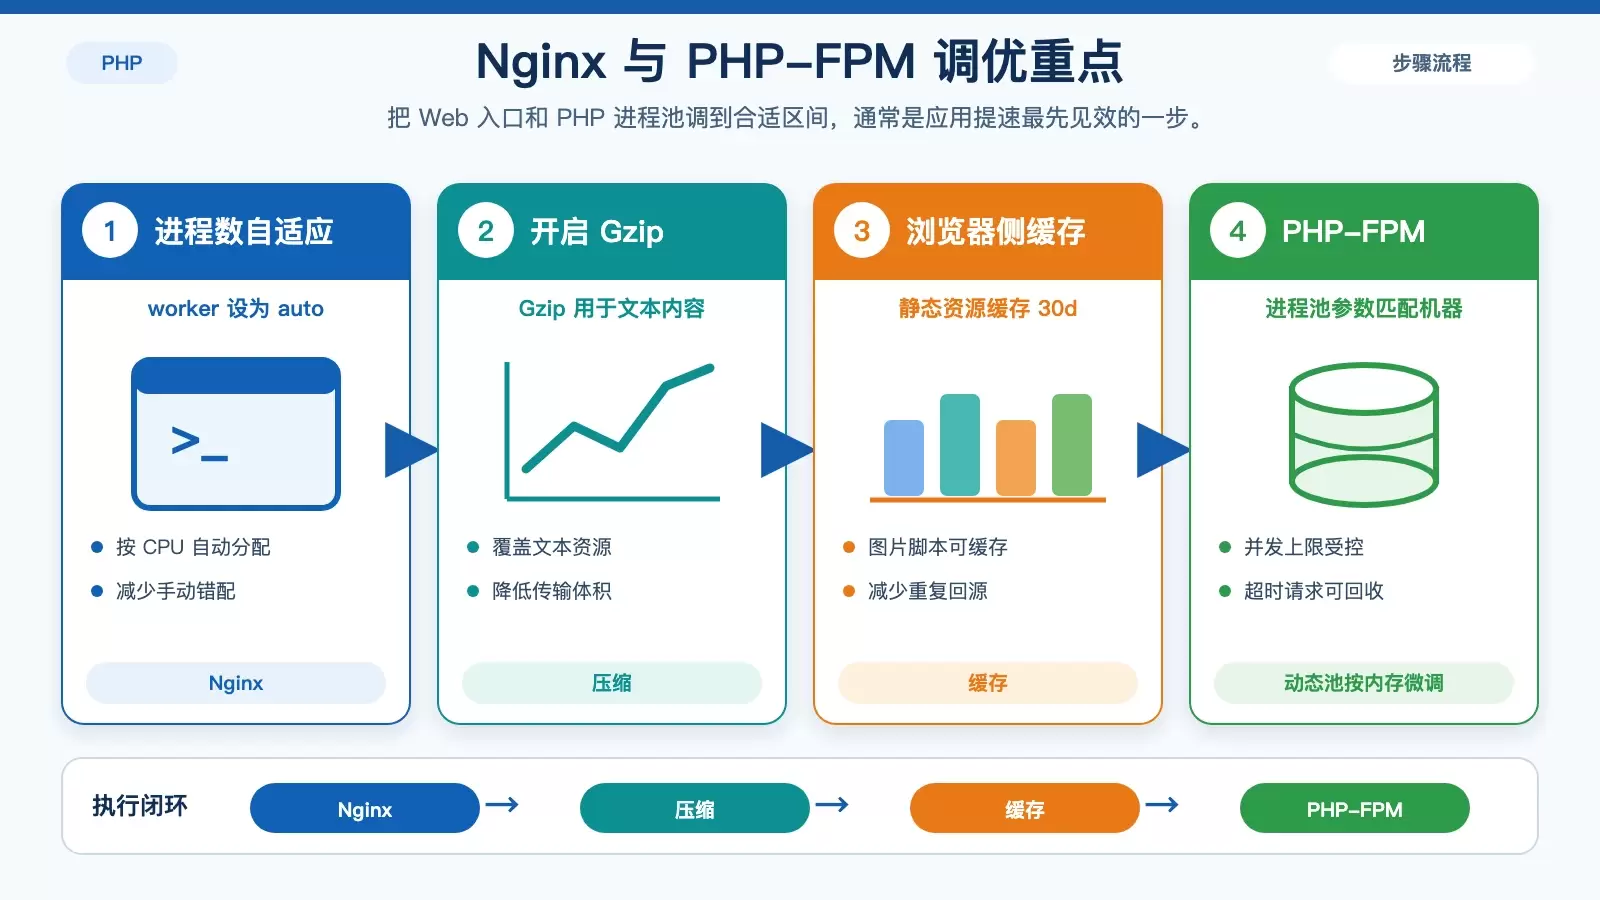
在 CentOS 上优化 ThinkPHP 响应时间,关键不在单点调参,而在于把 Web 服务器、PHP-FPM、代码访问路径、数据库和缓存放到同一条链路里看。本文按可落地的排查顺序整理常见优化手段,并说明哪些参数需要结合并发、内存和日志数据来判断。
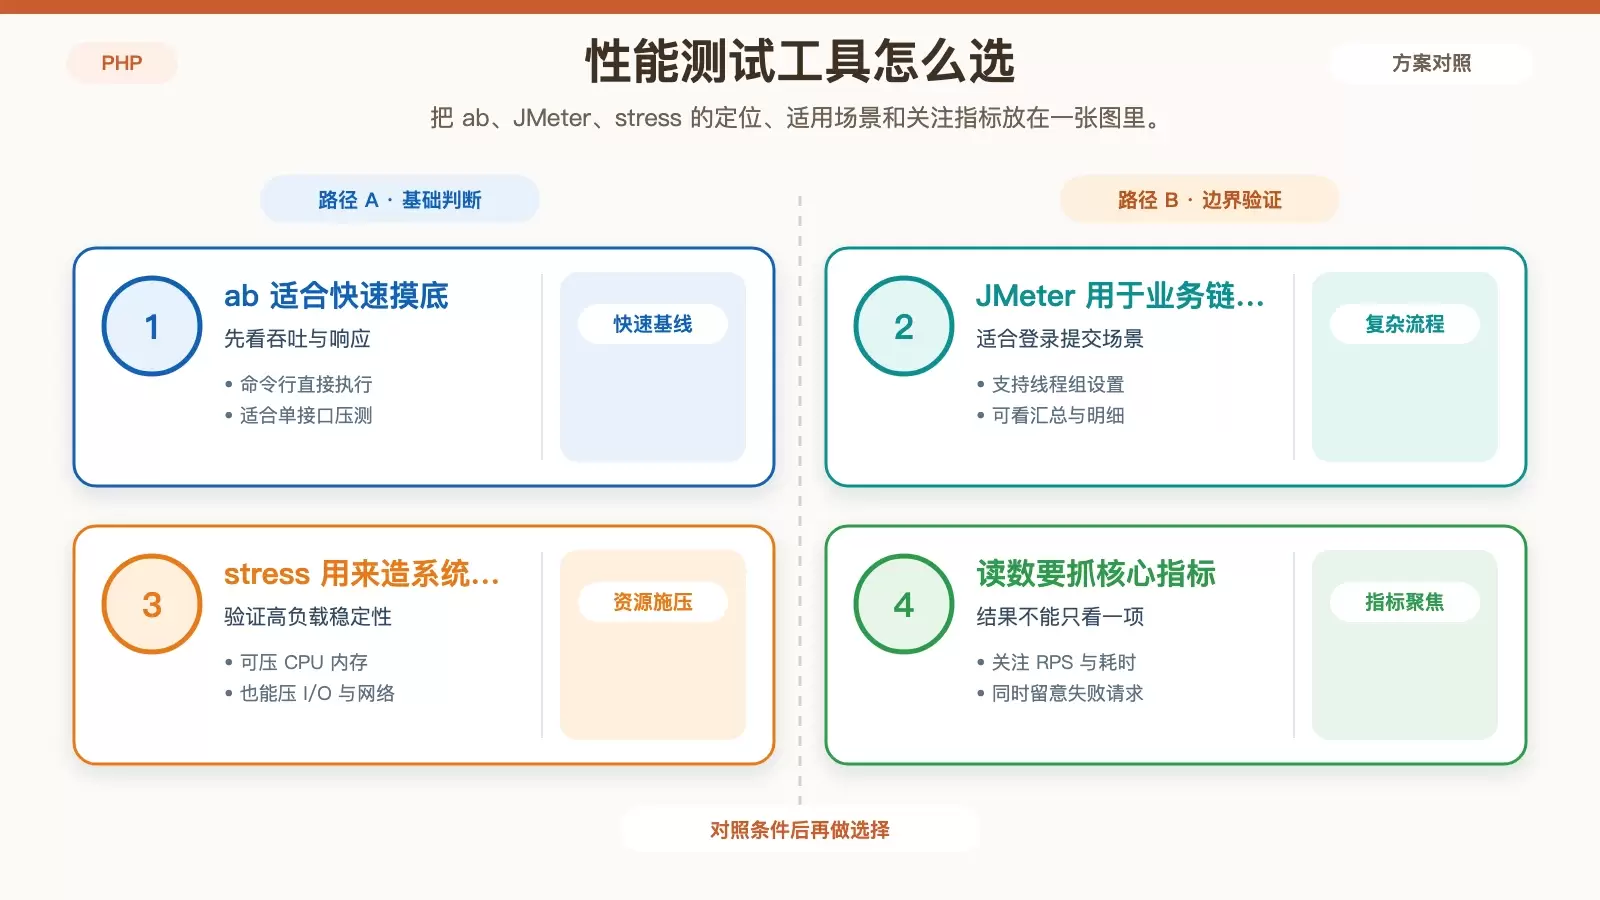
在 CentOS 上给 ThinkPHP 项目做性能测试,重点不只是“跑一遍压测”,而是保证环境一致、场景真实、指标可解释。本文按准备、工具使用、监控分析到优化落地的顺序,整理出一套可直接执行的方法,帮助你判断瓶颈究竟出在接口、系统资源还是数据库。
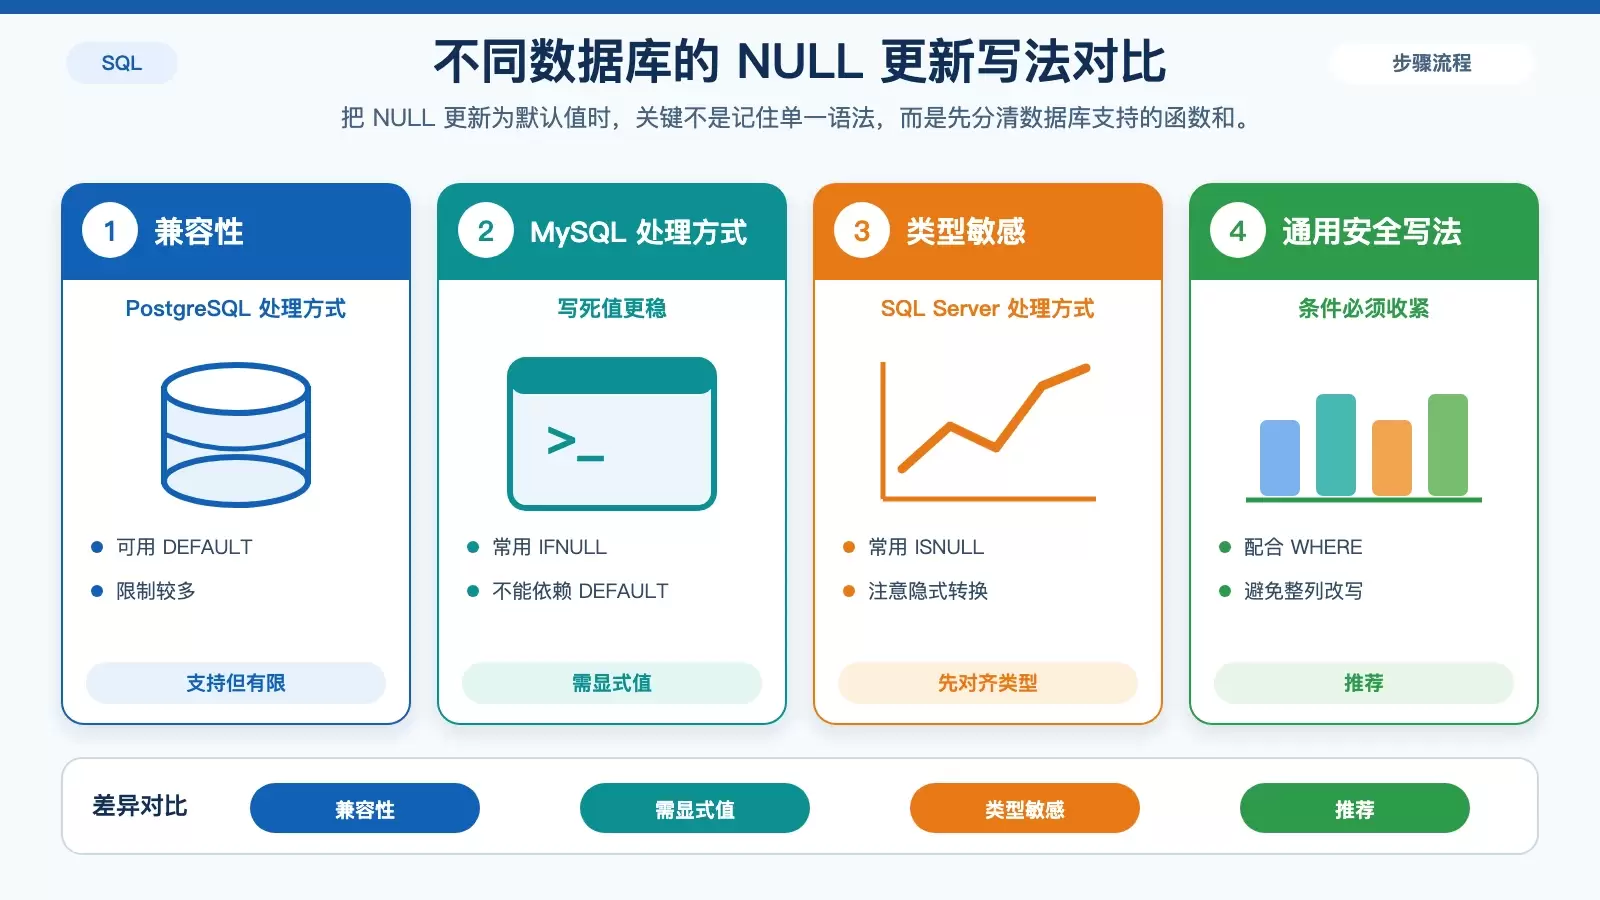
把 SQL 里的 NULL 批量补成“默认值”,难点不在语法本身,而在不同数据库对 DEFAULT、COALESCE、IFNULL、ISNULL 的支持并不一致。本文按更新写法、默认值来源、批量更新防误伤和 JSON/数组字段四个方面,梳理更稳妥的处理方式。
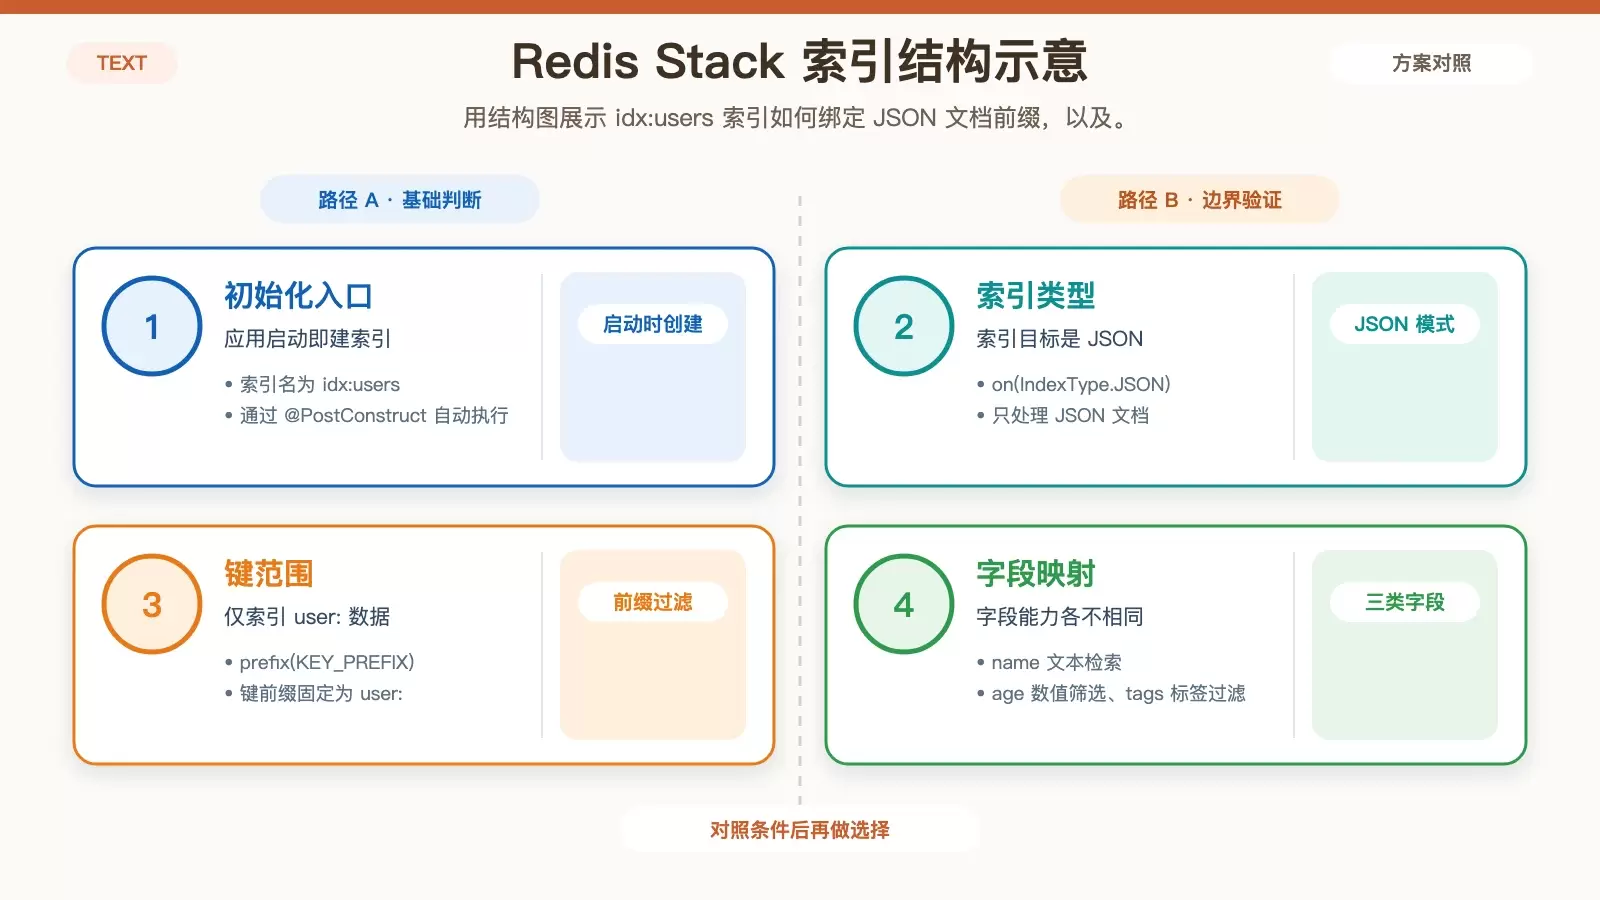
这篇示例把 Spring Boot 接入 Redis Stack 的流程拆成依赖、配置、索引初始化、JSON 读写和搜索验证五个环节。重点不在“能不能跑通”,而在 Redisson 如何把 RedisJSON 与搜索 API 串起来,以及查询语法、索引字段和接口测试之间的对应关系。
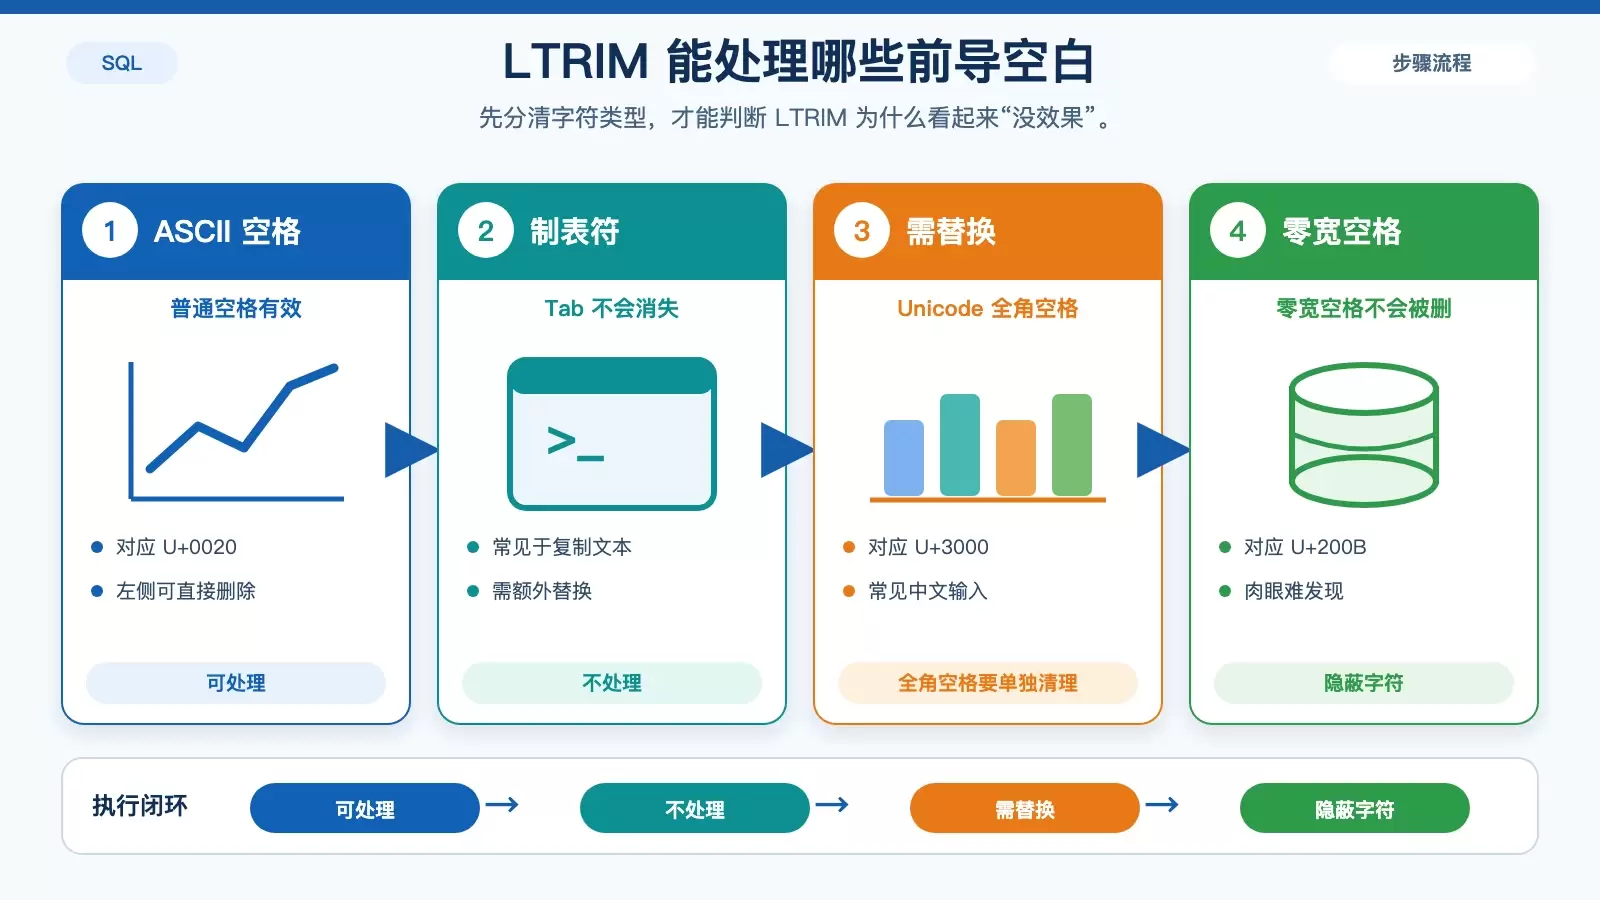
LTRIM 常被拿来清理字符串左侧空格,但它的适用范围其实很窄:只处理 ASCII 空格,跨数据库支持也不一致。本文按“能不能用、为什么没效果、会不会拖慢查询、迁移时怎么替代”四个问题梳理 SQL Server、MySQL 和 PostgreSQL 中的正确写法与避坑点。
这篇文章按 CentOS 上部署 ThinkPHP 的实际顺序,整理了从系统更新、PHP 8.x 与 Nginx 安装,到 Composer、数据库、项目权限和常见报错排查的完整流程。命令与配置均保留原始关键细节,适合直接照着搭环境,也方便对照检查问题出在哪一层。