


ThinkPHP 在 CentOS 上跑得慢,通常不是某一个配置出错,而是请求链路上多个环节一起拖了后腿。更稳妥的做法,是先从服务器与运行环境入手,再收敛到代码、数据库和缓存策略,最后用监控和日志验证优化是否真的生效。按照这个顺序处理,既能尽快看到响应时间下降,也能避免只靠“加配置”却找不到真实瓶颈。
先看服务器底座:硬件是否已经成为瓶颈
如果机器本身资源紧张,后面的应用层优化效果往往会被抵消。对 ThinkPHP 这类典型的 PHP Web 应用来说,内存、磁盘和 CPU 是最先该确认的三项。
增加内存
内存不足时,系统会更频繁地发生磁盘交换,PHP-FPM 进程和数据库都可能被拖慢。尤其是并发请求上来以后,足够的内存可以减少等待和抖动,让整体响应更稳定。
使用 SSD
如果仍在使用机械硬盘,随机读写性能很容易成为短板。切到 SSD 后,PHP 会话文件、缓存文件以及数据库 I/O 一般都会更快,页面首屏和接口响应都更容易改善。
升级 CPU
ThinkPHP 在模板渲染、业务判断、数据组装这类环节都要消耗 CPU。更强的 CPU 能提升单请求处理速度,在复杂逻辑或高并发场景下效果更明显。
把 Nginx 和 PHP-FPM 调到合适区间
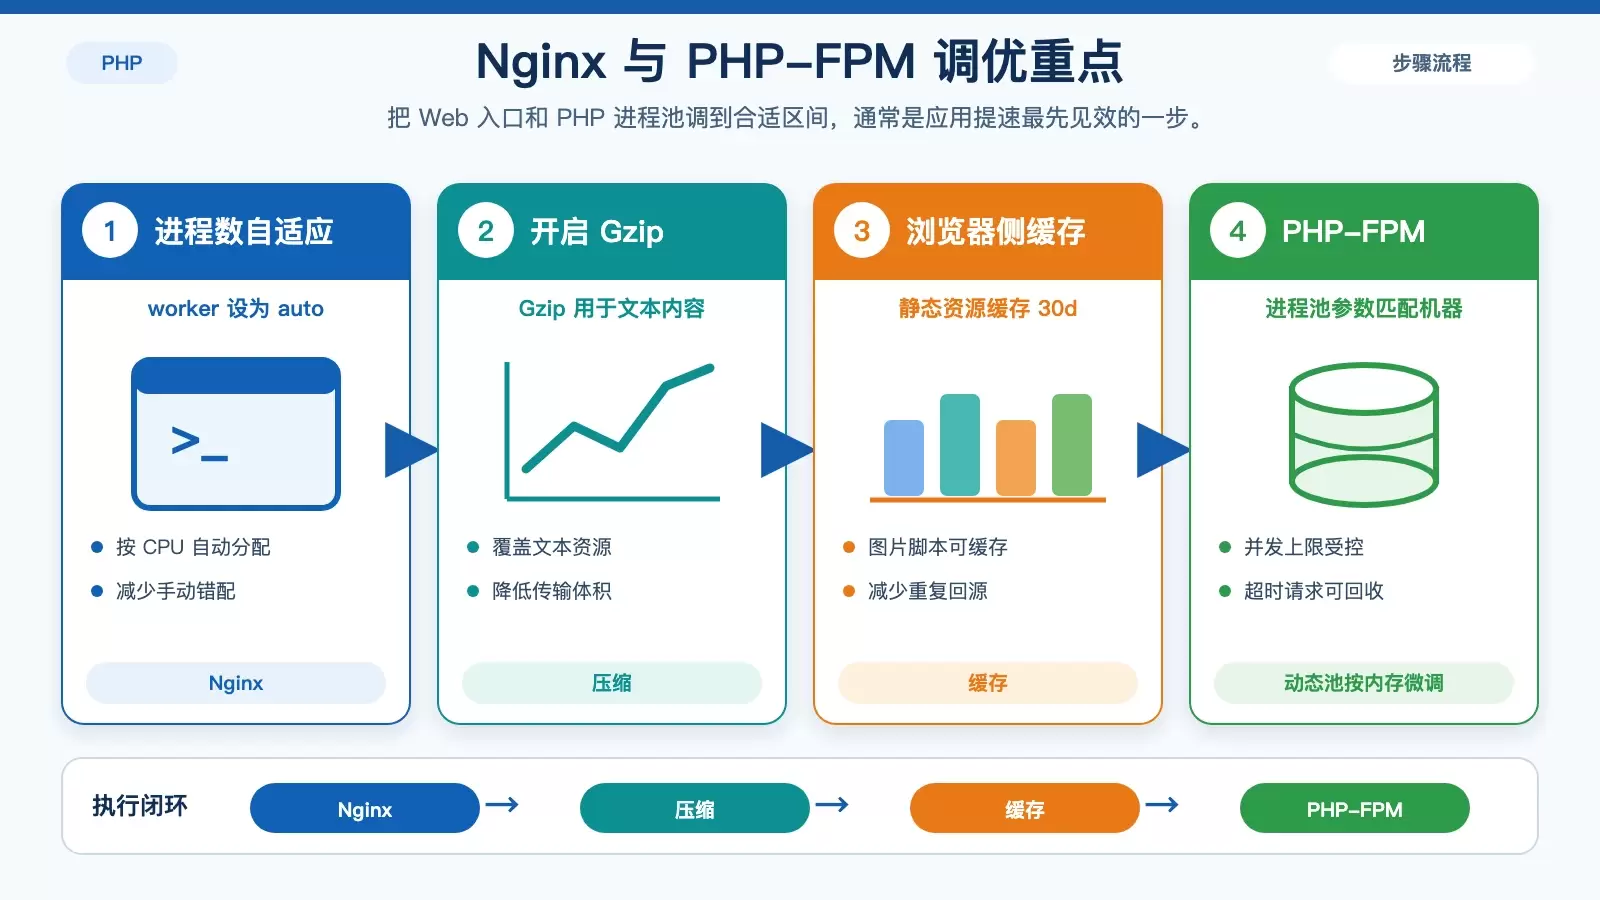
硬件资源没问题后,下一步就该看 Web 服务和 PHP 进程池。Nginx 负责接住请求、处理静态资源,PHP-FPM 负责真正执行 PHP 代码,两边都直接影响响应时间。
Nginx 配置优化
Nginx 作为反向代理和静态文件服务器,可以优先检查 worker 进程、压缩和静态缓存策略。原始示例如下:
http {
    # 增加 worker 进程数,一般设为 auto 即可
    worker_processes auto;
    worker_connections 1024;

    # 启用 Gzip 压缩,文本类资源能省不少带宽
    gzip on;
    gzip_types text/plain text/css application/json application/ja vascript text/xml application/xml application/xml+rss text/ja vascript;

    # 静态资源缓存,浏览器端直接拿缓存,不用每次请求服务器
    location ~* .(jpg|jpeg|png|gif|ico|css|js)$ {
        expires 30d;
        add_header Cache-Control "public";
    }

    # 反向袋里设置
    server {
        listen 80;
        server_name yourdomain.com;

        location / {
            root /path/to/your/thinkphp/project;
            index index.php index.html index.htm;
            try_files $uri $uri/ /index.php?$query_string;
        }

        location ~ .php$ {
            fastcgi_pass unix:/tmp/php-cgi.sock;
            fastcgi_index index.php;
            include fastcgi.conf;
            fastcgi_param SCRIPT_FILENAME $document_root$fastcgi_script_name;
            fastcgi_param PATH_INFO $fastcgi_path_info;
        }
    }
}
这里有几个重点值得单独理解:
- worker_processes auto;:通常可以让 Nginx 按 CPU 核心数自动分配进程数。
- worker_connections 1024;:决定单个 worker 可处理的连接上限,过低时高并发更容易出现排队。
- gzip on;:对文本资源启用压缩,能减少传输体积,尤其适合 CSS、JS、JSON 这类内容。
- expires 30d; 与 Cache-Control "public":把静态资源尽量交给浏览器缓存,减少重复请求回源。
- try_files:让 ThinkPHP 的路由入口转发更直接,避免无效路径处理。
如果站点静态资源较多,这一层往往能先带来一轮比较明显的提速。
PHP-FPM 进程池优化
PHP-FPM 的关键在于动态进程池参数是否和机器资源、实际并发匹配。可以编辑 /etc/php-fpm.d/www.conf,参考下面这组配置:
pm = dynamic
pm.max_children = 50
pm.start_servers = 5
pm.min_spare_servers = 5
pm.max_spare_servers = 35
request_terminate_timeout = 30s
这些参数的含义可以简单理解为:
- pm = dynamic:使用动态进程池,按负载变化增减 PHP 子进程。
- pm.max_children = 50:限制最大子进程数,决定并发承载上限,但也直接消耗内存。
- pm.start_servers = 5:服务启动时预创建的进程数,影响冷启动后的响应速度。
- pm.min_spare_servers = 5 与 pm.max_spare_servers = 35:控制空闲进程区间,避免请求高峰时临时拉起太多进程。
- request_terminate_timeout = 30s:限制单请求最长执行时间,避免慢请求长期占住 worker。
要注意,这些数值不是通用模板。内存大的机器可以适当提高 pm.max_children,但如果 PHP 进程把内存吃满,系统照样会因为交换或 OOM 变慢。调优时最好结合实际内存占用和并发峰值来看,而不是机械套参数。
应用层提速:减少查询、控制执行开销、用好缓存
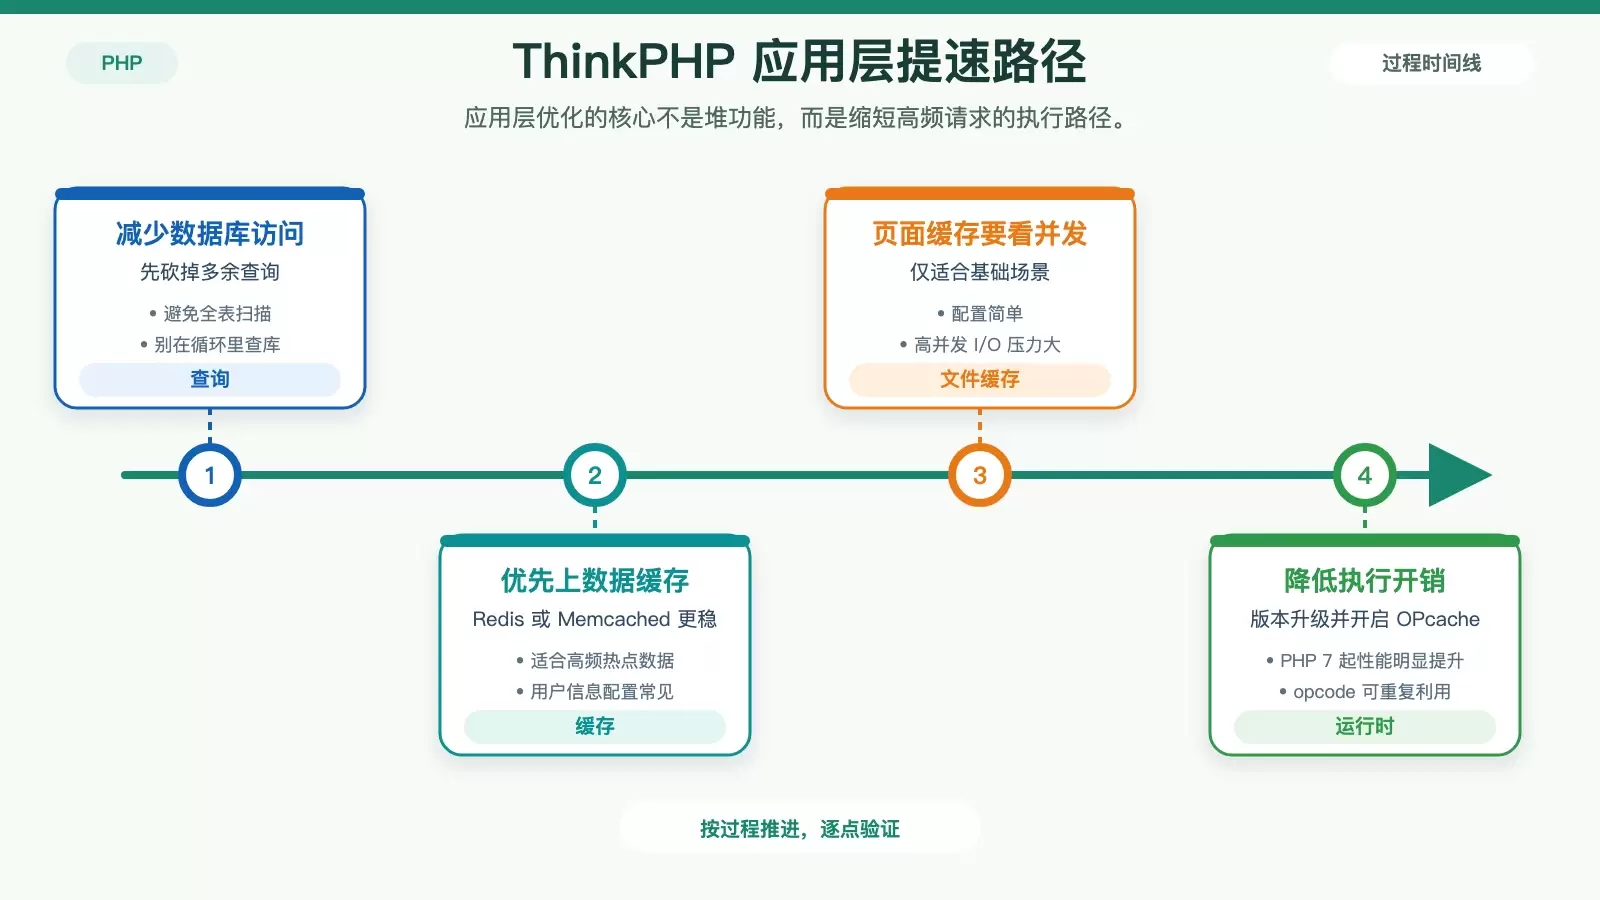
环境层调完之后,真正决定 ThinkPHP 响应速度的,还是应用代码本身。这里最常见的慢点通常集中在数据库访问过多、缓存没用起来,以及 PHP 运行开销偏高。
先减少不必要的数据库查询
很多项目不是服务器不够强,而是请求里做了太多本可避免的查库操作。优化时优先看两件事:
- 确保索引存在:查询字段没有索引,再高的硬件配置也很难扛住全表扫描。
- 避免循环查库:这是性能问题里最典型的一类。能一次取完的关联数据,就不要在循环里一条一条查询。
如果某个接口逻辑上看起来不复杂,但响应时间却一直偏高,先怀疑是否出现了 N+1 查询,往往比先改服务器参数更有效。
把缓存放到高频访问路径上
缓存的目标不是“哪里都加”,而是把重复计算、重复读取最重的部分挡在后端之前。对 ThinkPHP 来说,常见缓存方式有两类:
- 数据缓存:适合用户信息、配置参数、热门文章列表这类频繁读取但变化不快的数据,常用 Redis 或 Memcached。
- 页面缓存:适合部分更新不频繁的页面,ThinkPHP 本身也提供了相应能力。
例如在 config/app.php 中可以这样配置:
'cache' => [
    'type' => 'file',
    'path' => '/tmp/cache',
],
这类文件缓存适合基础场景或低并发站点,但在生产环境里,如果访问量持续升高,更推荐把缓存驱动换成 Redis 或 Memcached。原因很直接:文件缓存会带来额外磁盘 I/O,高并发下容易成为新的瓶颈。
降低 PHP 执行成本
除了查库和缓存,PHP 本身的执行效率也值得单独处理:
- 优先使用 PHP 7 或更高版本:PHP 7 相比 5.x 性能提升很大,而当前主流的 8.x 往往更合适。
- 避免高开销函数:像
eval()、assert()这类函数不但性能差,也会带来安全风险。 - 开启 OPcache:把编译后的 opcode 缓存下来,减少 PHP 文件被重复编译的时间。
对于代码层优化,建议先关注请求次数最多、耗时最长的接口,而不是全局平均地“扫一遍代码”。这样更容易看到真实收益。
数据库优化要聚焦索引、SQL 写法和日常维护
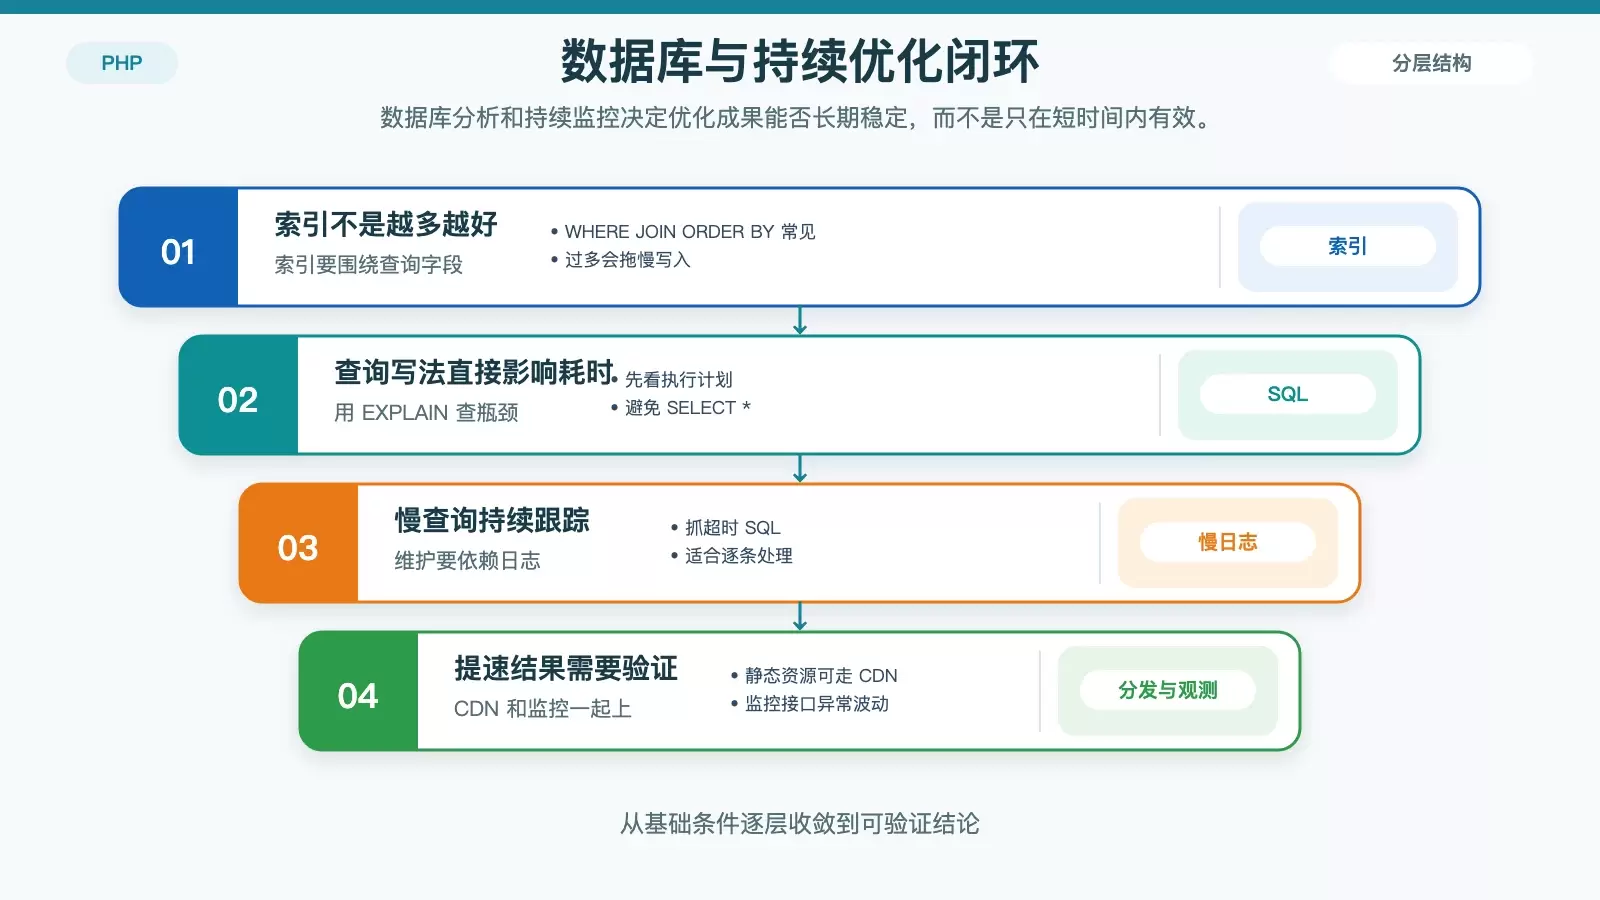
ThinkPHP 项目的慢请求,很多最后都会落到数据库上。数据库调优不一定复杂,但要抓住最影响响应时间的几件事:索引是否合理、SQL 是否只取需要的数据、慢查询是否有持续跟踪。
索引优化
- 经常出现在
WHERE、JOIN、ORDER BY中的字段,通常应该建立索引。 - 索引并不是越多越好。索引越多,
INSERT、UPDATE、DELETE的维护成本也越高,需要在读写之间平衡。
如果某张表读多写少,可以更积极地做索引优化;如果写入频繁,就要评估索引带来的额外开销。
查询优化
- 用
EXPLAIN分析 SQL,重点看是否出现全表扫描、文件排序等问题。 - 避免
SELECT *,只查询真正需要的字段,减少数据传输和内存占用。
很多接口慢,并不是 SQL 逻辑写错了,而是“能跑但不高效”。通过 EXPLAIN 看执行计划,往往比凭感觉猜更靠谱。
定期维护
- 定期备份并清理历史数据,尤其是日志表、临时表这类容易持续膨胀的数据。
- 开启慢查询日志,把执行时间超过阈值的 SQL 记录下来,再逐条做针对性优化。
这一步看起来不像调参数那样“立刻提速”,但对长期稳定性很关键。很多系统前期不慢,往往是因为数据量还没上来;一旦历史数据累积,这类维护工作就会直接影响响应时间。
静态资源分发和监控分析,决定优化能否持续有效
前面的配置和代码优化解决的是服务端处理速度,剩下还要考虑两件事:静态资源是否能更快送到用户手里,以及优化后有没有持续观测手段。
静态资源走 CDN
如果站点包含大量图片、CSS、JS 文件,接入 CDN 往往是成本最低、收益最稳定的办法。静态资源分发到离用户更近的节点后,加载速度通常会更好,源站压力也能跟着下降。
这类优化尤其适合前后台分离页面、图片较多的内容站,以及访问地区分布较广的业务。
用监控和日志找真实瓶颈
- 可以使用 New Relic、Datadog 或 Prometheus 持续监控应用性能,观察接口响应时间、异常峰值和资源使用情况。
- 同时分析 Nginx 与 PHP 日志,定位慢请求的根因,例如数据库死锁、第三方 API 超时,或者某个接口在特定时间段集中变慢。
真正有效的优化通常都不是“一次性完成”。上线后继续看监控,再结合压力测试和日志数据验证结果,才能知道变慢的到底是 Nginx、PHP-FPM、数据库,还是外部依赖。
实际调优时,建议按这条顺序推进
如果你要在 CentOS 上系统地优化 ThinkPHP 响应时间,可以按这个顺序落地:先确认硬件资源是否明显不足,再调 Nginx 和 PHP-FPM,接着收紧数据库查询与缓存策略,然后检查 SQL、索引和慢查询日志,最后把 CDN 与监控补齐。
这样做的好处是,每一步都能对应一类清晰瓶颈,也更容易通过日志和压测判断是否值得继续深入。对大多数项目来说,只要把这些环节逐项过一遍,响应时间通常都会有比较明确的改善。









