


做横向统计报表时,很多人第一反应是找 PIVOT,但一进真实项目就会碰到兼容性、空值和动态分类的问题。相比之下,CASE WHEN 配合聚合函数虽然看起来更基础,却更适合在 MySQL、PostgreSQL、SQL Server、Oracle 等混合环境里稳定落地。下面就按实际使用中最容易出错的几个点来拆开看,帮助你判断什么时候能直接写 SQL,什么时候该把逻辑交给应用层或报表工具。
为什么横向报表更常用 CASE WHEN + 聚合
很多教程会把 PIVOT 讲成横表统计的标准解法,但在生产环境里,SUM(CASE WHEN ...) 往往才是优先选项。原因不复杂:它的可移植性更强,几乎所有主流 SQL 引擎都能一致运行,而 PIVOT 的支持情况却很分裂。
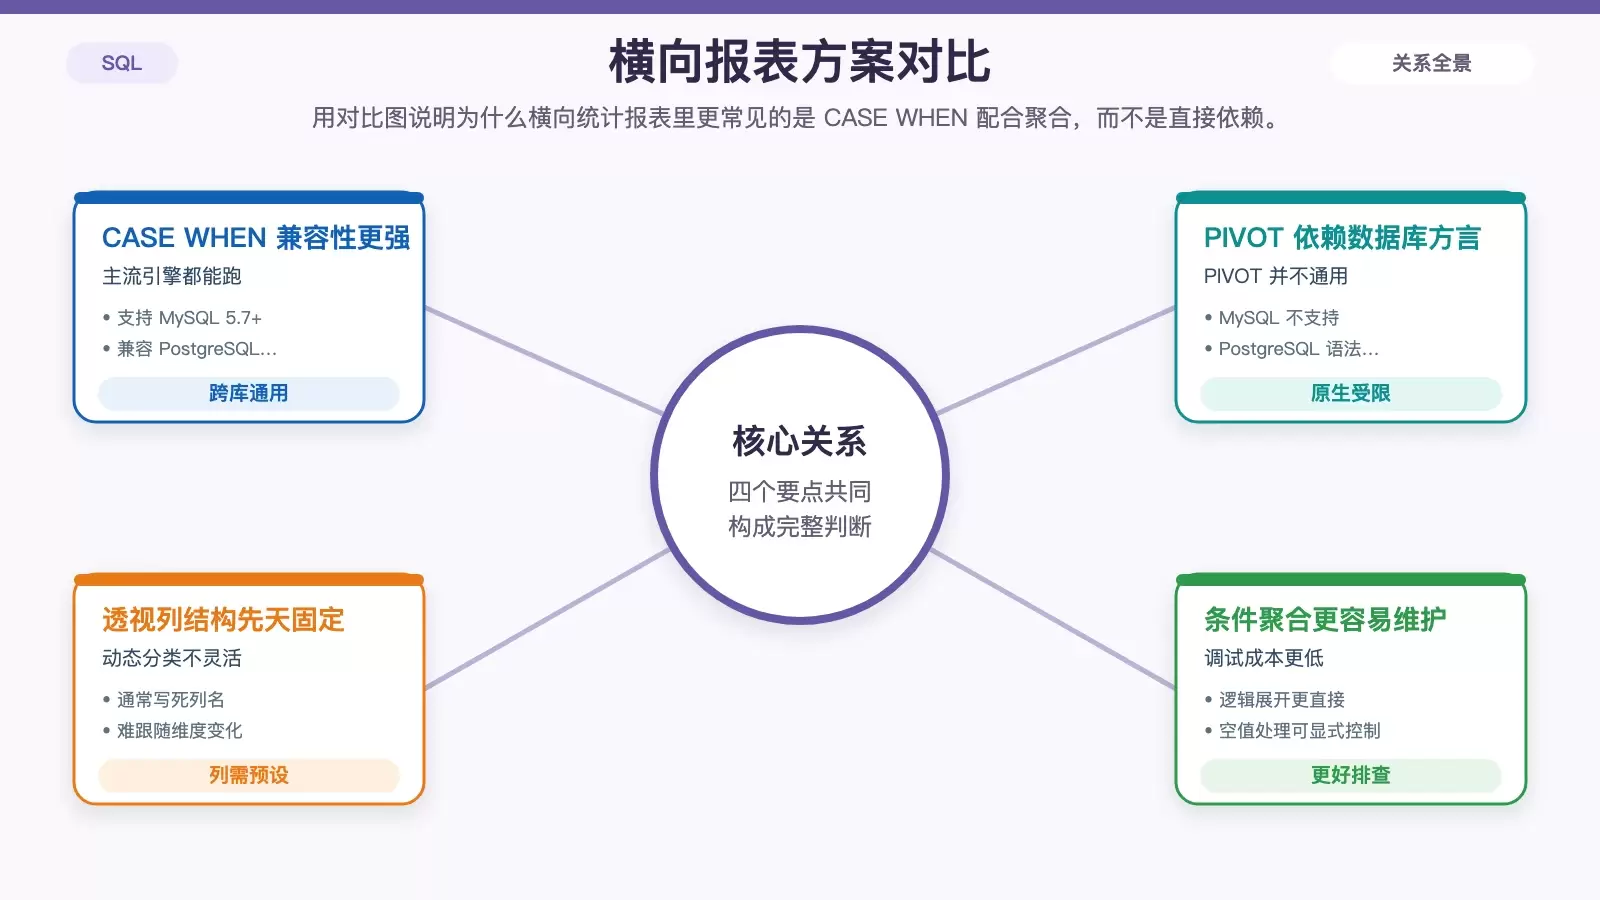
绝大多数线上环境使用的是 MySQL 或 PostgreSQL,可它们并没有统一、成熟的原生 PIVOT 能力。MySQL 根本不支持,PostgreSQL 的写法也有限制;只有 SQL Server、Oracle 等数据库才提供原生支持。也就是说,如果你的 SQL 需要跨库复用,或者团队内部数据库并不统一,直接上 PIVOT 很容易把查询写死在某一种方言里。
相比之下,CASE WHEN 加聚合函数的思路更朴素,也更稳:
- 兼容 MySQL 5.7+、PostgreSQL、SQL Server、Oracle 等主流数据库
- 逻辑展开后可读性高,排查错误更直接
- 可以精确控制
NULL的处理方式 - 在分类值固定时,不依赖额外数据库特性
更关键的是,PIVOT 通常要求把输出列名提前写死,这会让它很难适配动态维度。实际业务里只要分类字段会新增取值,比如订单状态多出一个 'refunded',原来的透视列定义就可能马上过期。
忘写 ELSE 0,结果为什么会静默失效
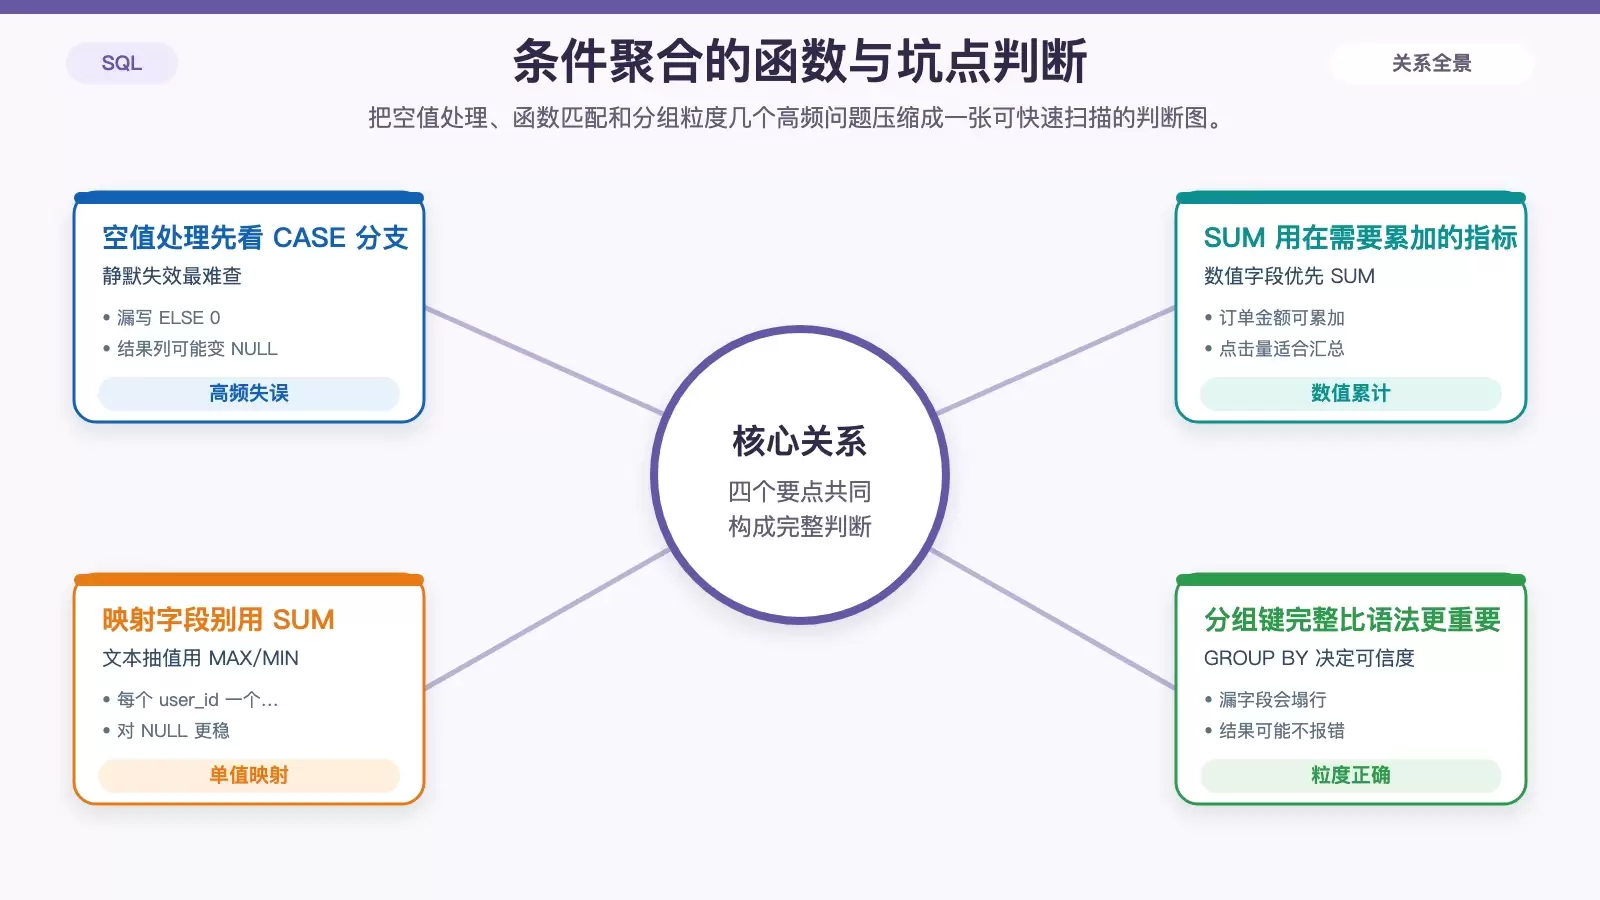
条件聚合最常见、也最隐蔽的坑,就是漏掉 ELSE 0。很多人写第一版 SQL 时,只关注命中的条件分支,却忽略了未命中时返回什么值。结果不是报错,而是返回大量 NULL,最后让整列统计结果变得不可信。
例如下面这两种写法,看起来只差一点,结果却完全不同:
- 正确写法:
SUM(CASE WHEN status = 'shipped' THEN amount ELSE 0 END) - 错误写法:
SUM(CASE WHEN status = 'shipped' THEN amount END)
问题在于,条件不满足时,第二种写法会返回 NULL。而当参与聚合的数据全是 NULL 时,SUM(NULL) 的结果仍然是 NULL。它不会提醒你 SQL 写错了,只会在报表中表现成空白、NaN,或者看起来像“没有数据”。这种静默失效在前端表格和导出报表里尤其难排查。
因此,只要你做的是数值型条件累计,通常都应该显式补上 ELSE 0。这样即使某一类当前没有命中记录,结果列也会稳定返回 0,而不是把空值一路传递到最终展示层。
如果你的场景不是数值累加,而是从多行里抽一个文本值出来,就不要再用 SUM。例如:
MAX(CASE WHEN tag_type = 'city' THEN tag_value END)这种写法更适合字符串映射场景,也能避免把文本字段交给 SUM 后出现类型报错或隐式转换问题。
分类值不固定时,SQL 该做到哪一步
条件聚合还有一个天然边界:输出列必须事先确定。也就是说,硬编码的 CASE WHEN 天生适合“分类集合已知”的报表,不适合完全动态的横向展开。
比如你原本只统计 'pending'、'shipped'、'delivered' 三种状态,SQL 写好后运行正常。但某天业务新增了 'refunded',旧 SQL 并不会自动多出一列。这不是数据库 bug,而是横向报表设计本身的限制:列结构在执行前就已经固定了。
遇到这种情况,常见处理方式有几种:
- 先查询所有分类值:
SELECT DISTINCT status FROM order_status_log - 在应用层用 Python/Java 拼接完整 SQL,再执行
- 预先设置兜底列,例如:
SUM(CASE WHEN status IN ('pending','shipped','delivered') THEN amount ELSE 0 END) AS other_amount - 如果使用 Metabase 这类报表工具,就让 SQL 只输出结构干净的纵表,再交给工具做透视
这背后的判断标准很简单:如果你需要的是稳定、可复用、固定列的统计报表,SQL 里直接写条件聚合最省事;如果你面对的是经常变化的维度集合,那就不该强行在一条静态 SQL 中解决所有问题,而是要把“生成列结构”的责任交给应用层或报表系统。
SUM、MAX、COUNT 分别适合什么场景
条件聚合不只是语法问题,更是业务语义问题。聚合函数选错,即使 SQL 能运行,结果也可能含义不对。实际判断时,可以先看原始值类型,再看你到底是要“累计”“抽值”还是“计数”。
数值累计:优先用 SUM
如果字段是数值型,而且目标就是累加,比如订单金额、点击量、退款额,那么用 SUM 最自然:
SUM(CASE WHEN status = 'shipped' THEN amount ELSE 0 END)这类写法适合把同一组内满足条件的金额或次数汇总成单个指标。
单值映射:优先用 MAX 或 MIN
如果每个分组下理论上只会出现一个有效值,比如每个 user_id 只有一个 city,那么用 MAX 或 MIN 更合适。它们的语义不是“求和”,而是“从候选值里取一个非空结果”,对 NULL 也更鲁棒。
条件计数:用 COUNT 更直观
像“男/女数量”这种场景,本质是按条件计数,而不是金额求和。此时更推荐:
COUNT(CASE WHEN gender = '男' THEN 1 END)这种写法比拿 SUM 去累加 1 更直接,而且 COUNT 会天然忽略 NULL。
不要对字符串使用 SUM
这是另一个很容易被忽略的问题。字符串字段交给 SUM 后,不同数据库的表现并不一致:MySQL 可能会把它隐式转成 0,而 PostgreSQL 往往会直接报错。也就是说,这类写法不但语义有问题,跨库行为也不稳定。
真正决定报表是否可信的,是 GROUP BY 是否完整
很多人以为条件聚合最难的是把第一行 CASE WHEN 写对,实际上真正影响结果可信度的,往往是 GROUP BY 是否覆盖了所有需要的维度。
只要漏掉一个分组字段,原本应该按多维展开的结果,就可能被意外压缩成更粗的一层,甚至整张表塌成一行。更麻烦的是,这类问题通常也不会报错,SQL 依然能正常执行,只是结果已经失真。
因此,在检查横向统计报表时,至少要反过来确认两件事:
- 每一个输出指标,是否都建立在正确的分组粒度上
- 分组键是否完整覆盖了业务需要的维度,而不是只写了最显眼的一个字段
可以这样理解:CASE WHEN 决定列里装的是什么,聚合函数决定如何汇总,而 GROUP BY 决定这一切是按什么粒度成立。前两者写得再漂亮,只要分组粒度错了,整张报表就没有分析价值。
如果你需要一个在多数据库环境里长期可维护的横向统计方案,那么优先级通常应该是:先确认分组维度,再选择合适的聚合函数,最后用 CASE WHEN 明确写出各列逻辑。至于完全动态的透视需求,则更适合让应用层或报表工具接手,而不是把所有变化都压进一条静态 SQL。









