


处理用户输入、导入数据或历史字段时,字符串前导空格常会影响匹配结果,看起来最直接的办法就是上 LTRIM。但这个函数并不是所有数据库都支持,它能清掉的也不等于所有“空白字符”,如果再把它直接写进 WHERE,还可能把索引一并废掉。下面按常见使用场景拆开讲,先判断该不该用,再看遇到异常和性能问题时该怎么改写。
LTRIM 能做什么,先看数据库是否支持
LTRIM 的作用很明确:移除字符串左侧的 ASCII 空格,也就是 U+0020。它不是通用“清除所有空白”的函数,也不是所有 SQL 方言都认这个名字。
在不少现代 SQL 环境里,更常见的是标准化的 TRIM。例如 PostgreSQL、SQL Server 较新的版本都更适合优先考虑 TRIM。而 LTRIM 主要见于 SQL Server,以及部分较老的数据库实现,比如 Sybase。
使用前至少要先确认当前数据库类型,否则很容易把一段在 SQL Server 中可运行的语句原样带到别处,结果直接报错。
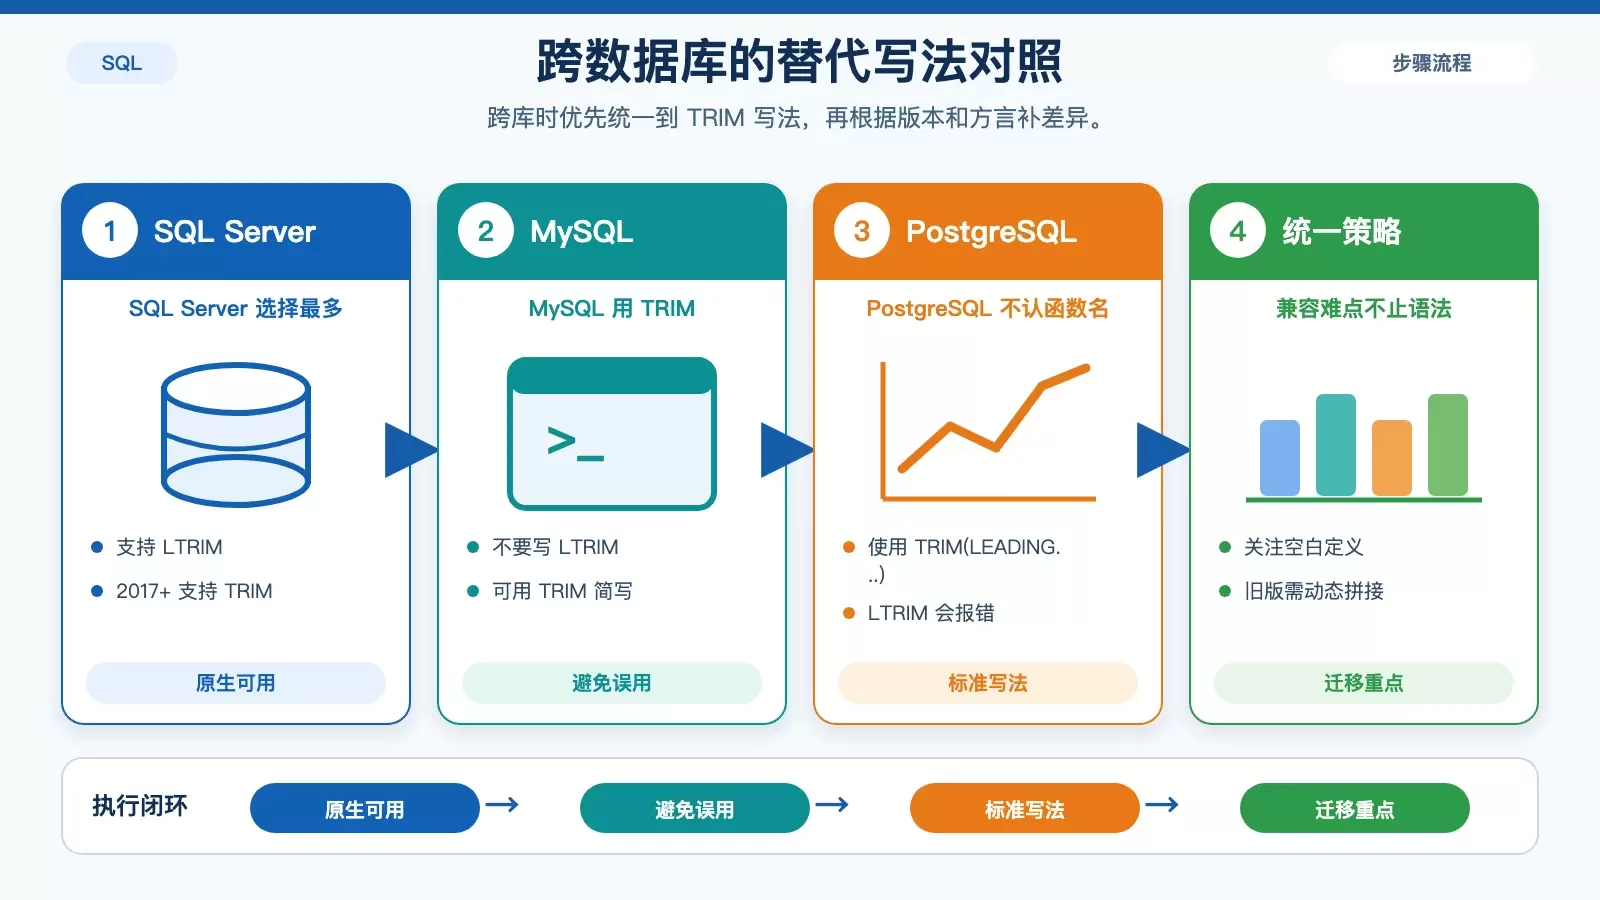
不同数据库中的可用情况
- SQL Server:可以直接使用
LTRIM(column_name) - MySQL:应改用
TRIM(LEADING FROM column_name),或使用默认去首尾空格的TRIM(column_name) - PostgreSQL:使用
TRIM(LEADING FROM column_name),不要写LTRIM
原文中提到的几个典型报错,需要特别留意:
- MySQL 中直接使用
LTRIM,会报错FUNCTION LTRIM does not exist - PostgreSQL 中硬写
LTRIM,会触发ERROR: function ltrim(unknown) does not exist
如果你的 SQL 需要跨库复用,那么从一开始就尽量使用 TRIM 体系,而不是把 LTRIM 当作默认选项。
为什么执行后“没效果”:它只认左侧 ASCII 空格
很多人第一次踩坑都发生在这里:语句执行成功了,但结果开头看起来还是有空白。通常不是函数失效,而是字段里的首字符根本不是普通空格。
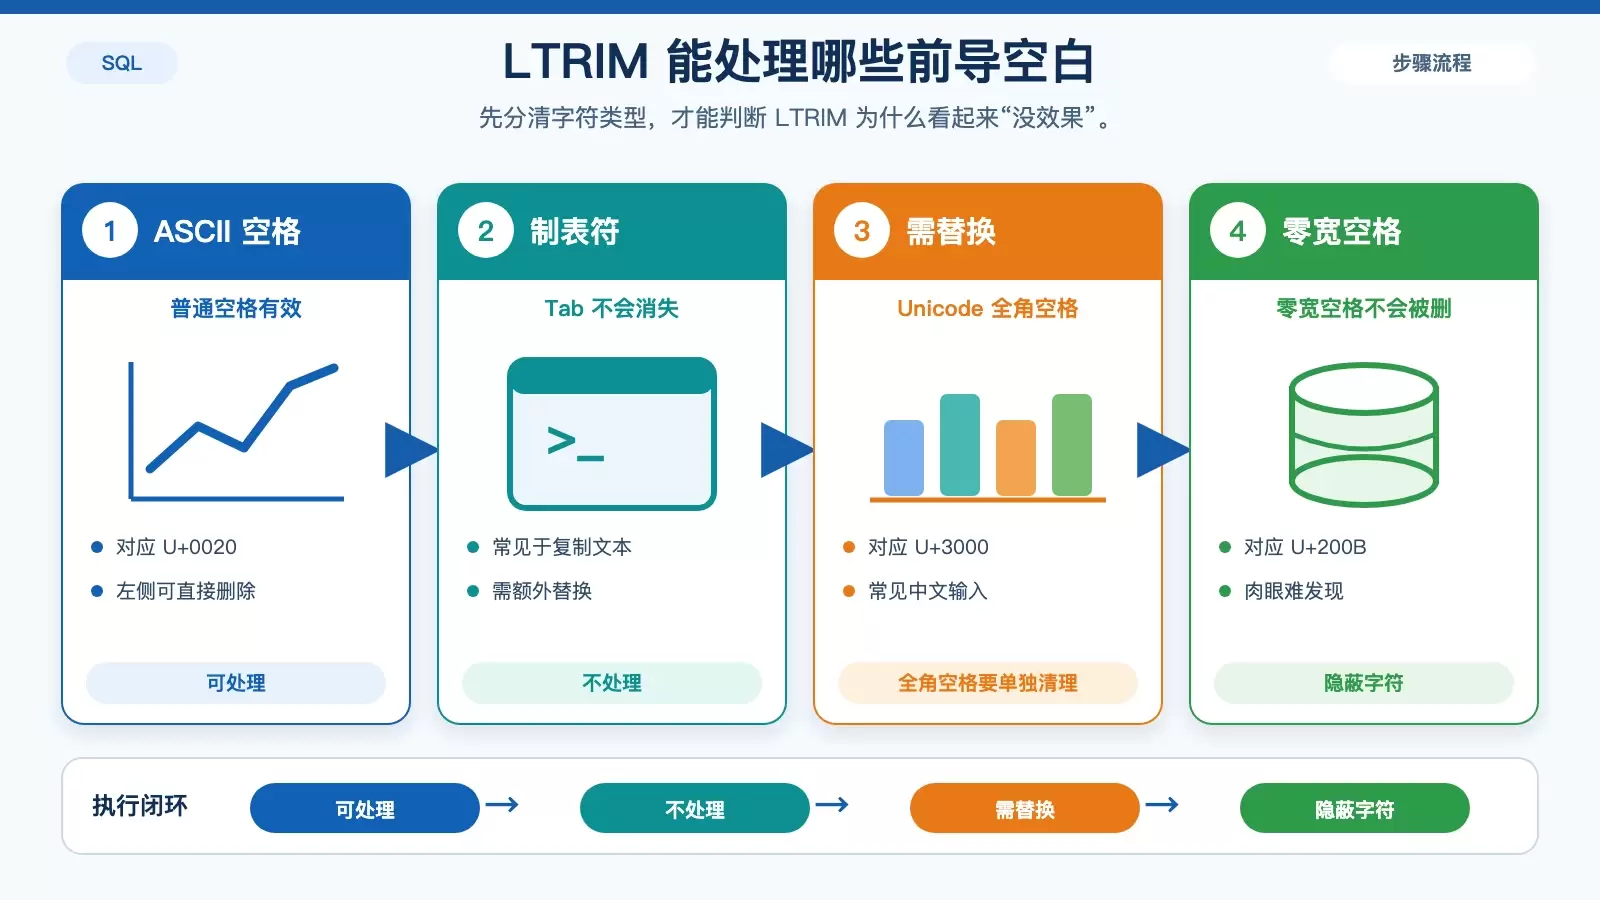
以 SQL Server 为例,LTRIM 只会处理 ASCII 32 对应的空格。下面这些字符,它都不会主动清掉:
- 制表符
- 换行符
- Unicode 空格,例如全角空格
U+3000 - 零宽空格,例如
U+200B
先确认首字符到底是什么
如果你执行了这样的语句:
SELECT LTRIM(name) FROM users结果依然有前导空白,就应该先检查原始值。原文给出的排查方式是:
SELECT name, DATALENGTH(name), SUBSTRING(name, 1, 1) AS first_char FROM users WHERE name LIKE ' %'这里的 DATALENGTH 可以帮助暴露隐藏字节,适合用来判断字段里是不是混入了肉眼不容易识别的字符。
遇到全角空格时怎么处理
如果确认是全角空格,在 SQL Server 中不能只靠一次 LTRIM 解决,通常需要先替换,再修剪。可用写法如下:
REPLACE(LTRIM(REPLACE(name, N' ', ' ')), N' ', '')这里的关键点在于:全角空格是 Unicode 字符,必须显式处理,不能假设它和普通半角空格行为一致。
更稳妥的替代思路
如果数据库版本允许,原文建议优先使用 SQL Server 2017+ 的 TRIM:
TRIM(' ' FROM column_name)这种写法的好处是行为更明确,你可以显式指定要删除的字符,控制力比默认的 LTRIM 更强。要注意的是,它依然不是“自动处理所有空白字符”的万能方案,面对不同 Unicode 空白时,仍然要先确认目标字符种类。
把 LTRIM 写进 WHERE,为什么会拖慢查询
另一个常见误区,是直接在筛选条件里写:
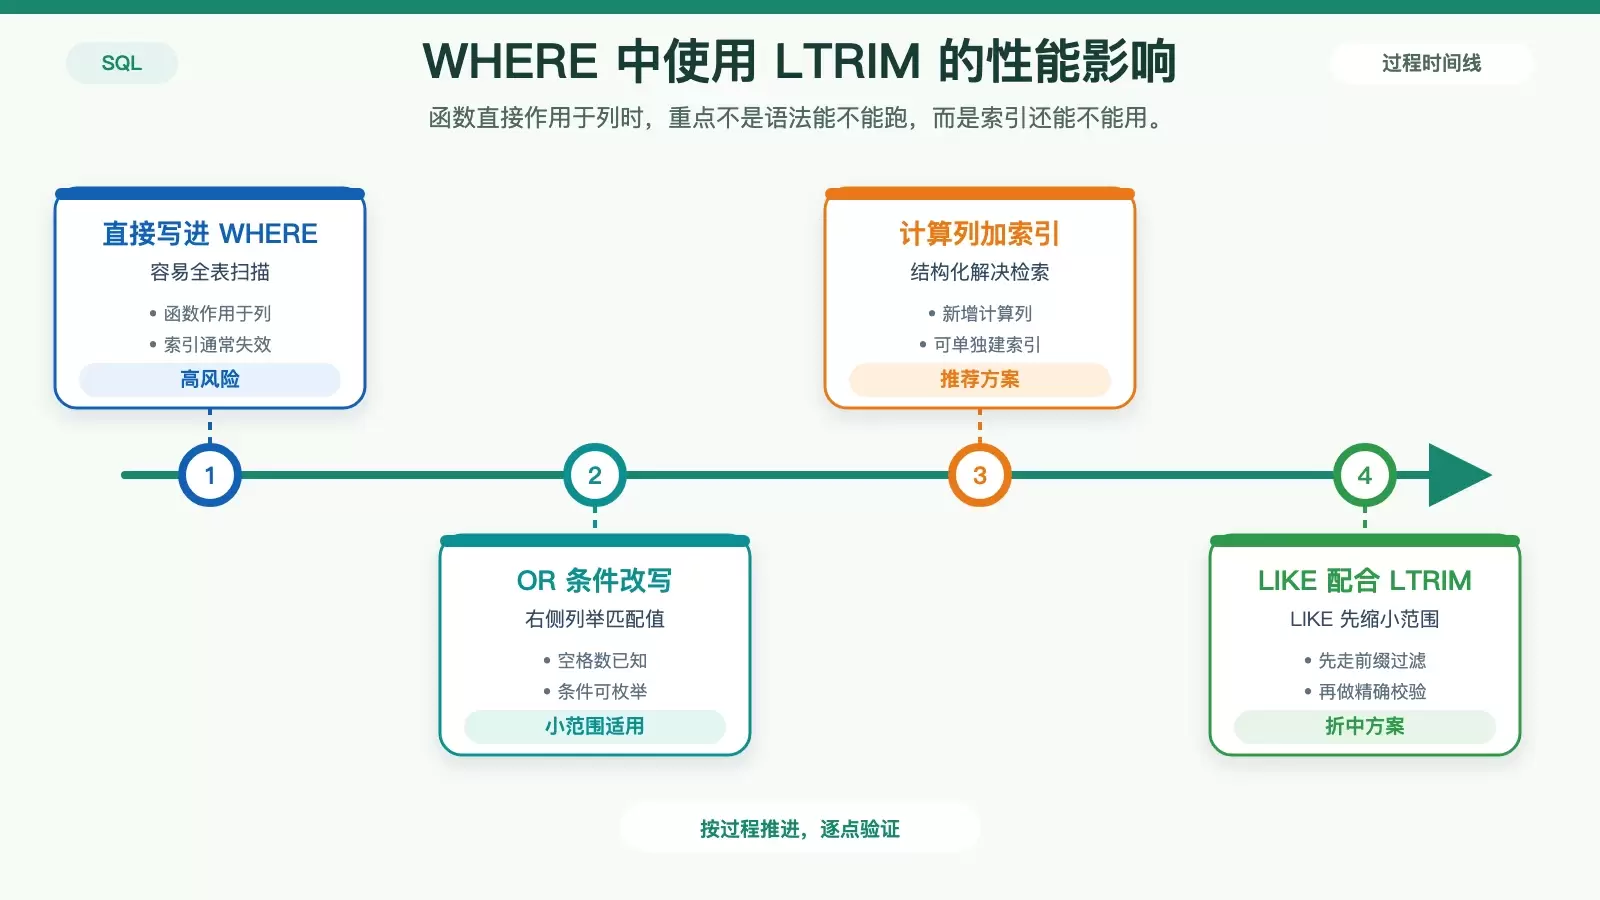
WHERE LTRIM(name) = 'John'这样写语义上没问题,但执行层面代价很高。原因在于函数被施加在列 name 上,优化器通常无法直接利用该列已有的索引,因此即使建了索引,也很可能退化为全表扫描。
这类问题在用户表、订单表、日志表等大表中尤其明显。查询慢并不是因为 LTRIM 本身计算多重,而是因为它改变了索引可用性。
更合适的改写方式
原文给出了几种替代方案,适用场景不完全一样。
第一种,是把判断尽量移到右侧,避免对列做函数计算:
WHERE name = 'John' OR name = ' John' OR name = 'John'这种方式只适合前导空格数量非常少、且数据分布已知的场景。它不是通用解法,但在少量脏数据修补时确实直接。
第二种,是建立计算列并为其建立索引:
ALTER TABLE users ADD name_trimmed AS LTRIM(name); CREATE INDEX IX_users_name_trimmed ON users(name_trimmed);如果业务中确实需要频繁按“去掉左侧空格后的值”来检索,这种方式通常更稳定。它把清洗逻辑前移为结构设计的一部分,让查询阶段不再临时对原列做函数运算。
第三种,是先借助 LIKE 进行索引过滤,再用 LTRIM 精确校验:
WHERE name LIKE 'John%' AND LTRIM(name) = 'John'这种组合思路的重点是让 LIKE 先缩小候选集,再由 LTRIM 处理最终精确匹配。是否能真正提升性能,还要结合具体执行计划判断,但相比单独在列上直接套函数,通常更有优化空间。
跨数据库迁移时,优先用 TRIM 而不是硬套 LTRIM
如果一段 SQL 要同时跑在 SQL Server、PostgreSQL 和 MySQL 之间,继续围着 LTRIM 打补丁,维护成本会越来越高。更稳妥的思路,是统一向标准 SQL 的 TRIM 靠拢。
更通用的写法
- SQL Server 2017+、PostgreSQL、MySQL 都支持:
TRIM(LEADING FROM column_name) - MySQL 还支持简写:
TRIM(column_name),等价于TRIM(BOTH FROM column_name)
如果必须兼容 SQL Server 2016 及更早版本,又不能调整表结构,那么只能在应用层或存储过程中做分支判断,根据数据库环境动态拼接 SQL。原文提到的判断依据包括 @@VERSION 或 current_database()。
真正难的是“空白”定义不一致
跨库兼容最容易被低估的,并不是函数名,而是不同数据库对空白字符和截断边界的处理方式并不完全相同。
例如原文特别提醒:SQLite 的 TRIM 会删除所有 Unicode 空白,而 SQL Server 的 LTRIM 只认普通空格。两边如果都叫“去空格”,但处理范围不同,那么在清洗用户输入、导入旧系统文本、做唯一性校验时,就可能出现结果不一致的问题。
因此,真正可靠的做法不是只记住某一个函数名,而是先明确两件事:你所在的数据库支持什么语法,以及你要清除的到底是哪一种字符。只有这两个前提都确认了,后续的清洗、检索和迁移策略才不会跑偏。
实际使用时的判断顺序
把上面的结论收拢成一套简单判断,实际写 SQL 时会更稳:
- 先确认数据库类型,不要默认所有环境都支持
LTRIM - 再确认待处理的是普通空格,还是制表符、全角空格、零宽空格等特殊字符
- 筛选条件中尽量避免直接对索引列使用
LTRIM - 需要跨数据库时,优先考虑
TRIM及其兼容写法
LTRIM 适合解决的问题其实很具体:清理左侧 ASCII 空格。只要超出这个边界,无论是字符类型、数据库兼容性,还是查询性能,都需要额外设计,而不是把它当成一个放之四海而皆准的“去空白函数”。









