


很多 PostgreSQL 触发器问题,并不是语法不会写,而是几个运行时约束容易被忽略:函数类型、返回值、动态 SQL 拼接方式,以及 NEW/OLD 的使用边界。本文按 PostgreSQL 14 的实际行为拆开说明,帮助你判断哪些写法会在 CREATE TRIGGER 阶段直接失败,哪些写法要到批量执行时才暴露出性能和逻辑问题。
触发器函数为什么必须返回 TRIGGER
在 PostgreSQL 14 中,触发器函数的声明必须写成 RETURNS TRIGGER。如果不是这个返回类型,创建触发器时就会直接报错:
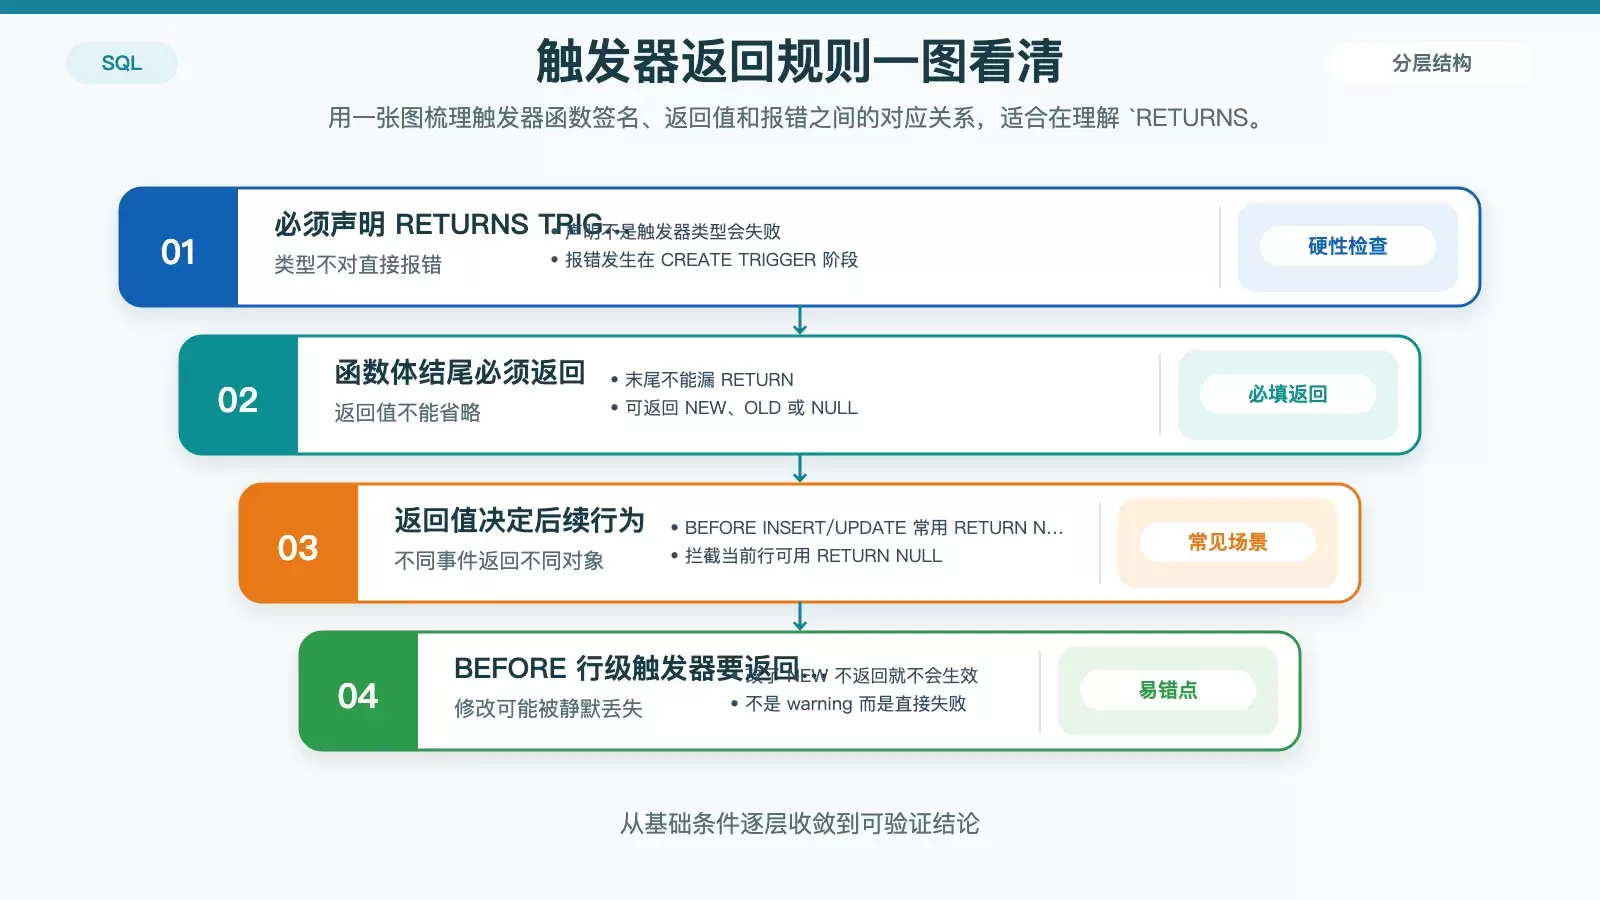
ERROR: function must return type trigger这里不是提示或警告,而是硬性类型检查。也就是说,就算函数体里已经写了 RETURN,只要函数签名不是触发器类型,CREATE TRIGGER 也不会通过。
常见错误写法
- 把函数声明成
RETURNS void - 把函数声明成
RETURNS text - 函数体末尾漏写返回语句
正确理解返回值含义
RETURN NEW:常用于BEFORE INSERT或BEFORE UPDATE,表示让当前修改后的行继续执行后续原操作RETURN OLD:通常用于需要返回旧记录语义的场景RETURN NULL:表示跳过当前行,常见于校验失败拦截或条件过滤
尤其要注意,BEFORE 行级触发器里即便你已经改动了 NEW,如果最后没有 RETURN NEW,这些变更也不会生效,等于直接丢失。
动态 SQL 里如何安全拼接表名和列名
在触发器函数中,直接写下面这种拼接方式并不可靠:
EXECUTE 'INSERT INTO ' || TG_TABLE_NAME || ' ...'问题不只是“写法不优雅”,而是它可能引发解析错误,也会把标识符和字面量混在一起,留下注入风险。因为 TG_TABLE_NAME 是运行时值,不能按普通字符串随意拼接后就假定 SQL 一定合法。
推荐写法:用 format() 区分标识符和字面量
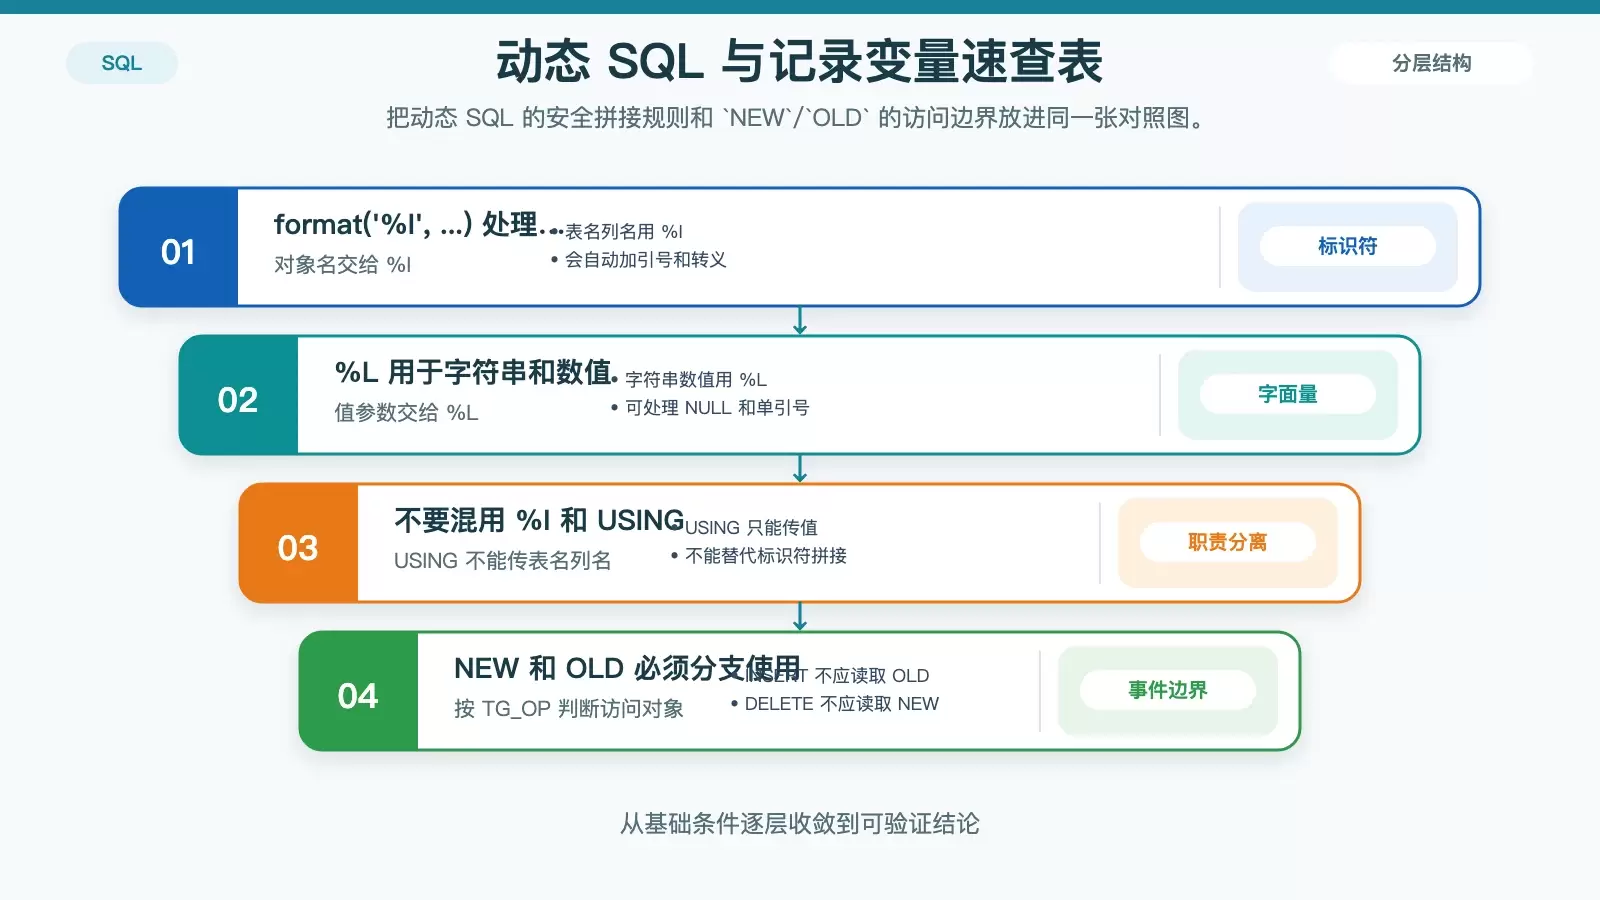
%I:用于标识符,比如表名、列名、schema 名,会自动加双引号并转义%L:用于字符串或数值字面量,效果等价于quote_literal(),还能正确处理NULL和单引号
例如:
format('SELECT %I FROM %I', 'name', TG_TABLE_NAME)这类写法的关键,不是“能运行”而已,而是把对象名和数据值分开处理,避免后续在特殊字符、大小写、保留字场景下出错。
一个容易混淆的限制
不要把 %I 和 USING 的用途混为一谈。像下面这种组合里:
EXECUTE format('... %I ...') USING ...USING 只能传“值”,不能传表名、列名这类标识符。也就是说,标识符该由 %I 处理,参数值再交给 USING,两者职责不同,不能互换。
NEW 和 OLD 为什么必须按 TG_OP 分支访问
PostgreSQL 14 对触发器记录变量的检查很严格,不会替你做静默兼容。如果在 INSERT 触发器里读取 OLD.id,或者在 DELETE 触发器里访问 NEW.created_at,运行时就会报错,例如:
record "old" has no field "id"根本原因是:NEW 和 OLD 并不是任何事件下都同时可用,它们是否存在取决于当前触发事件。
实用写法
最稳妥的方式是根据 TG_OP 显式分支:
IF TG_OP = 'UPDATE' THEN
  ...
END IF;OLD只适用于UPDATE和DELETE场景NEW只适用于INSERT和UPDATE场景- 不要无条件写
OLD.updated_at或NEW.created_at
能不能统一取值
某些场景里,可以用 COALESCE(NEW.field, OLD.field) 来合并读取逻辑,但前提是业务语义本身成立。比如审计时间字段,有时这样做合理;但如果字段在新旧记录中的含义不同,这种“省事写法”反而会掩盖逻辑错误。
另外还要记住一条边界:在语句级触发器中,NEW 和 OLD 都是 NULL,不能套用行级触发器的写法。
FOR EACH ROW 的性能成本为什么常被低估
触发器逻辑在小数据量下通常看不出问题,但一旦进入批量更新,行级触发器的成本会迅速放大。比如一条影响 50 万行的 UPDATE,如果定义的是 FOR EACH ROW,触发器函数就会被调用 50 万次。
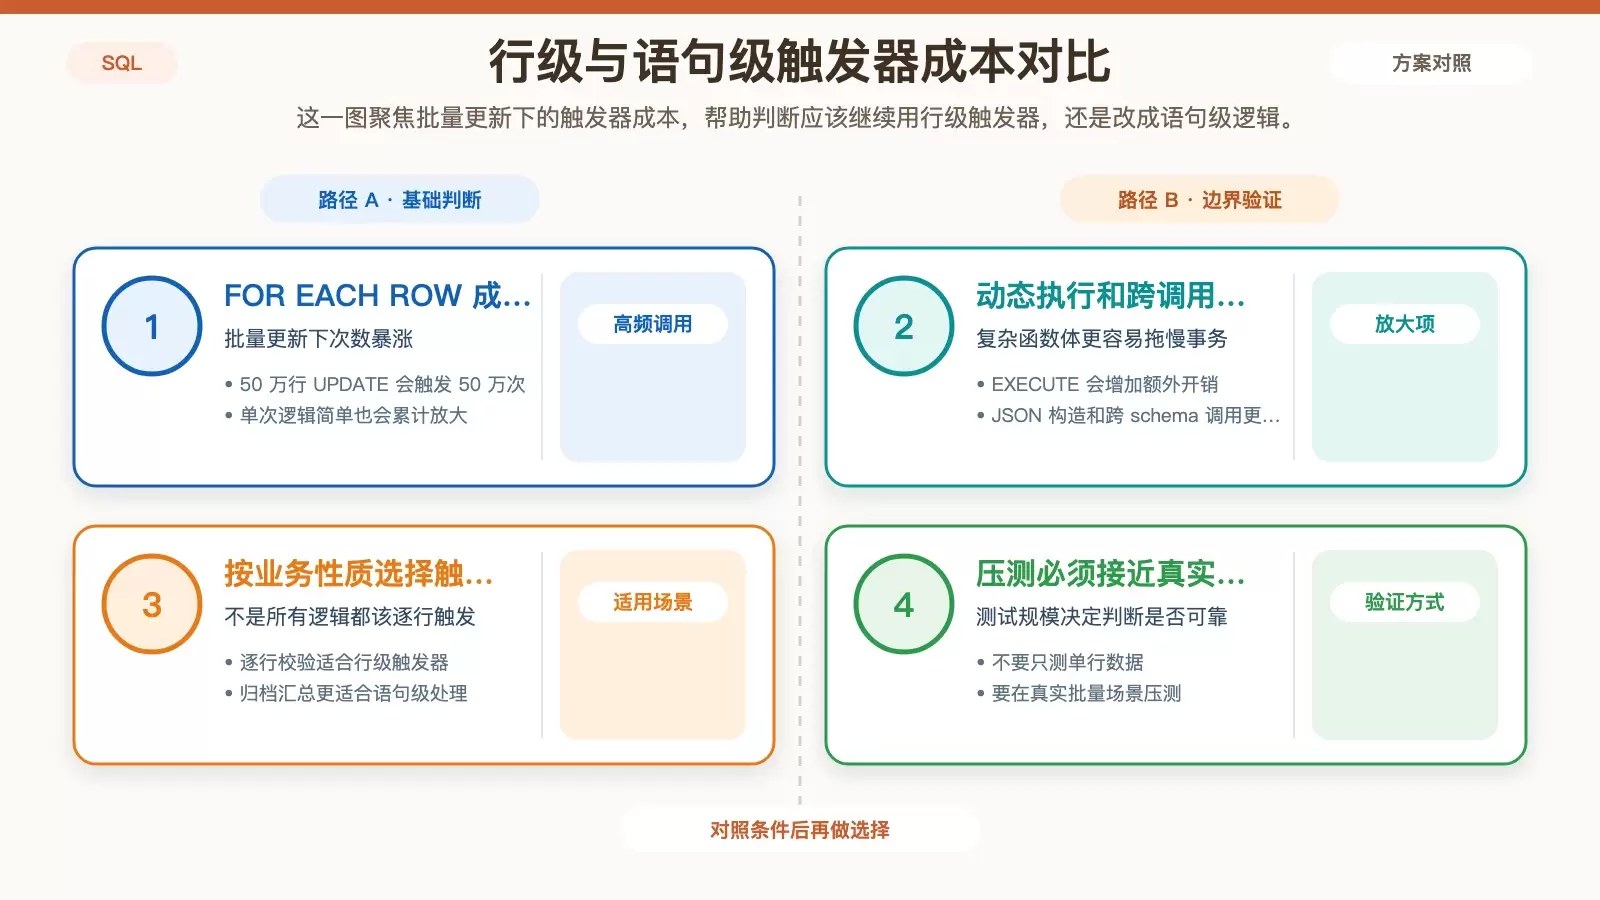
即便函数体只有简单赋值,累计开销也不低;如果里面还包含 EXECUTE、JSON 构造、跨 schema 函数调用,性能影响会更明显。
哪些细节最容易被忽略
- 多个触发器并存时,执行顺序受创建顺序影响,不能单靠
BEFORE/AFTER来表达复杂依赖 - 文中提到的顺序判断可从
pg_trigger.tgrelid + pg_trigger.tgname这一类内部组织方式理解,但实际设计上更重要的是避免让多个触发器彼此耦合 - 如果逻辑本质上适合批量处理,比如日志归档,优先考虑
FOR EACH STATEMENT+ 手动查变更行 - 测试不要只拿单行样本验证,必须在接近真实规模的批量场景下压测
如何做出更稳妥的选择
如果你的需求是逐行校验、逐行改写字段,行级触发器很难完全避免;但如果只是做记录归档、统计汇总、批量日志写入,就要认真评估是否真的需要每一行都触发一次。很多线上性能问题,不是 SQL 本身慢,而是触发器把一次语句级操作拆成了成千上万次函数调用。
写 PostgreSQL 14 触发器前,先检查这 4 件事
- 函数签名是否明确为
RETURNS TRIGGER - 函数末尾是否根据触发场景返回了
NEW、OLD或NULL - 动态 SQL 是否用
format('%I', ...)和%L正确区分标识符与字面量 - 是否按
TG_OP控制NEW/OLD的访问,并评估了FOR EACH ROW在批量操作中的成本
把这几项在建触发器前先过一遍,能挡掉大部分“创建时报错”和“上线后才发现性能异常”的问题。对 PostgreSQL 14 来说,触发器不是不能写得灵活,而是必须先满足这些非常明确的运行规则。









