Python中True和False的判断陷阱:逻辑取反与条件语句详解
本文详解Python中True和False的使用陷阱,重点区分逻辑取反not与按位取反~的差异。解析if条件语句中非零值自动转为True的机制,以及pandas DataFrame.loc中布尔索引与Series取反行为的特殊性,帮助开发者避免常见错误。
2026-10-15
7

本文详解Python中True和False的使用陷阱,重点区分逻辑取反not与按位取反~的差异。解析if条件语句中非零值自动转为True的机制,以及pandas DataFrame.loc中布尔索引与Series取反行为的特殊性,帮助开发者避免常见错误。
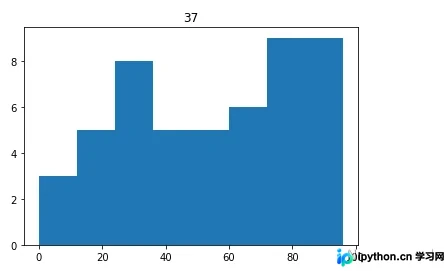
本文介绍Python数据分析中常用的Matplotlib可视化库。通过具体代码示例,详细讲解直方图、堆叠图、饼图、散点图、箱线图及雷达图等多种图表的绘制方法。内容涵盖参数设置、中文显示处理及数据呈现技巧,帮助读者快速掌握数据可视化基础技能。
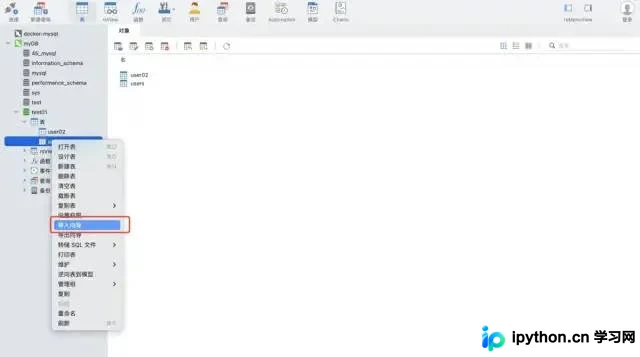
本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
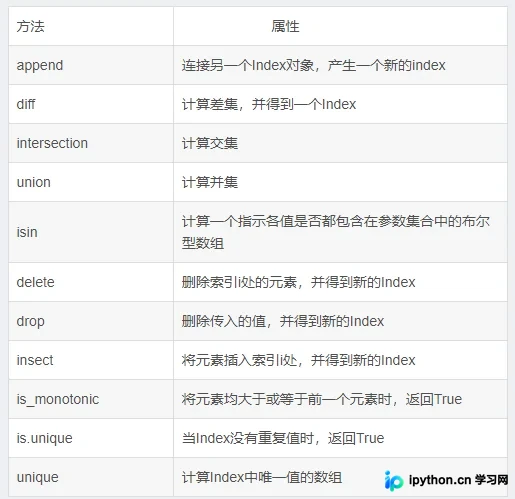
本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。
本文详细介绍在pandas DataFrame中批量修改数据的四种常用方法。通过iloc进行行列定位赋值,利用where和mask函数根据条件替换数值,以及使用replace函数处理文本、字典映射及正则表达式。涵盖具体代码示例与参数说明,帮助开发者高效完成数据清洗与预处理任务。
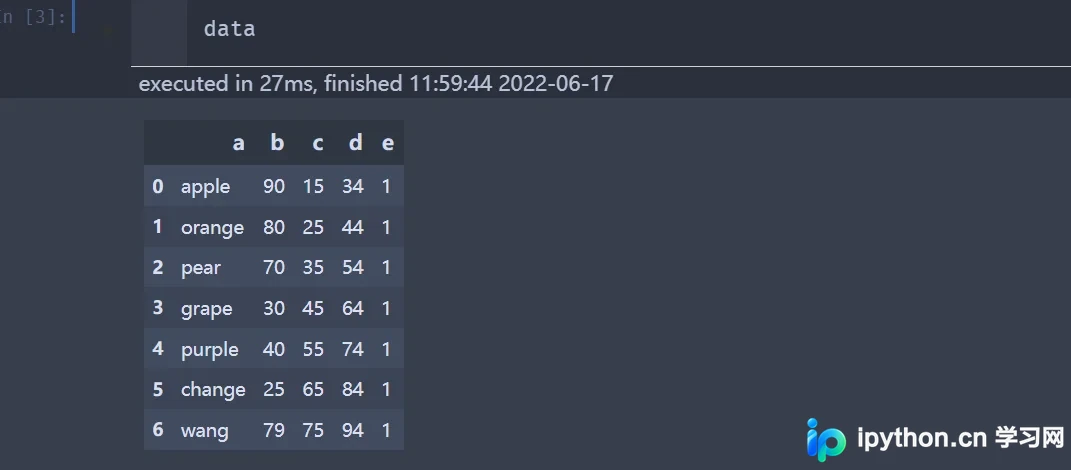
本文介绍如何利用Python的Openpyxl库对Excel文件中的特定单元格进行颜色填充。通过结合Pandas读取数据与Openpyxl操作样式,实现自动识别并高亮显示大于50的数值。文章详细讲解了PatternFill的使用、Excel列名的动态生成逻辑以及完整的代码实现流程,帮助开发者解决Excel批量格式化处理需求。

本文介绍如何在Python中使用pandas的groupby函数结合apply和lambda提取每组数据的最大值与最小值。通过异或逻辑筛选极值,并演示如何重置索引及导出Excel,解决直接groupby无法保留完整行的问题。
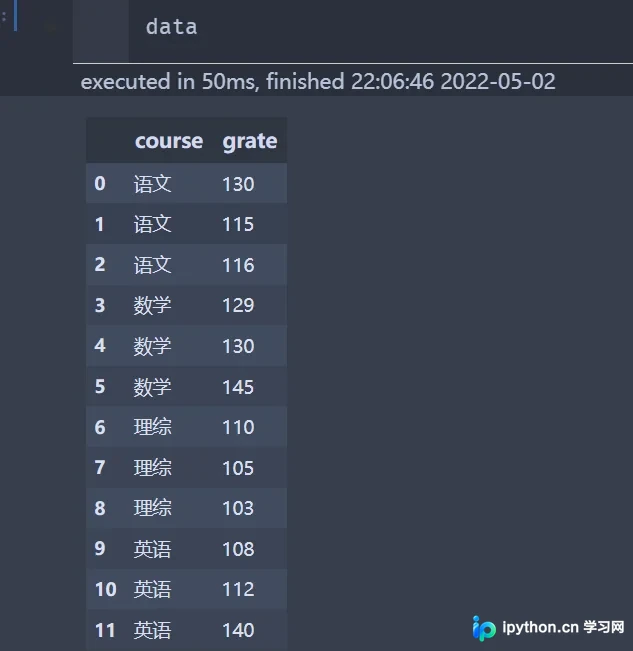
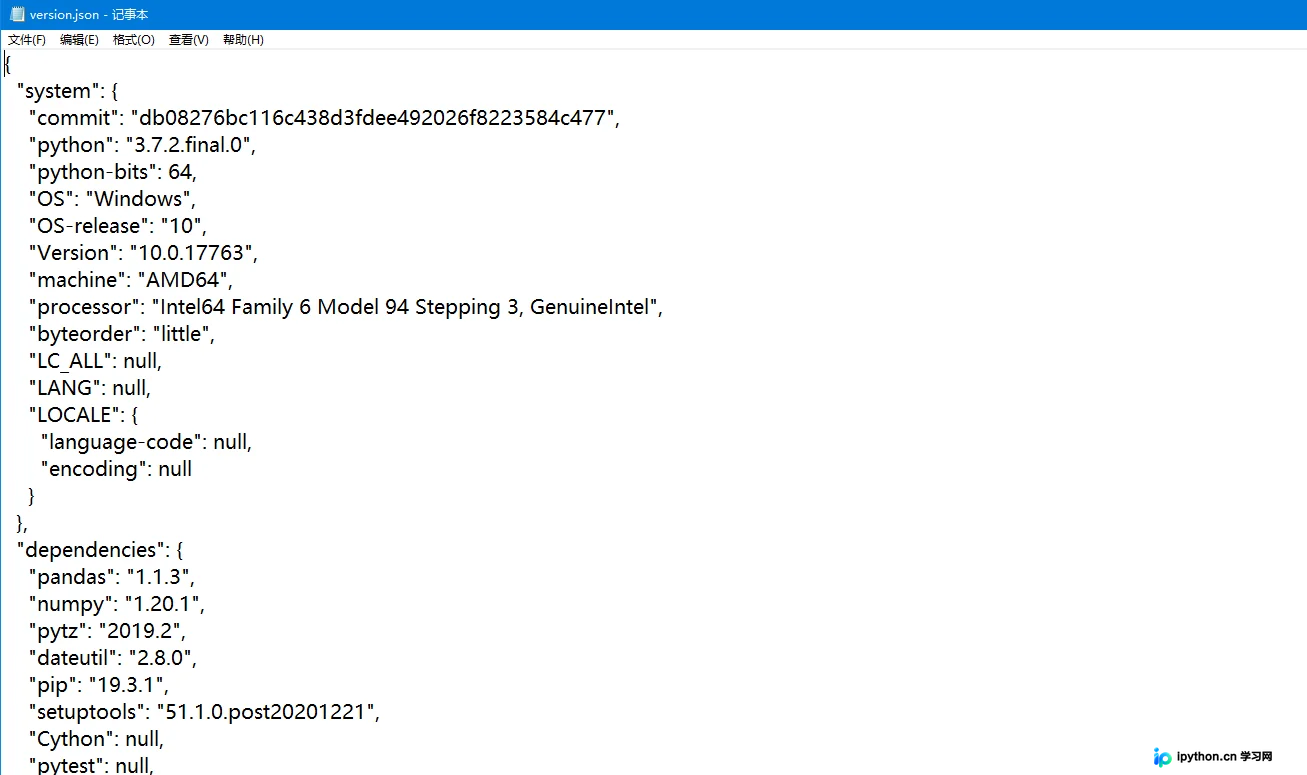
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
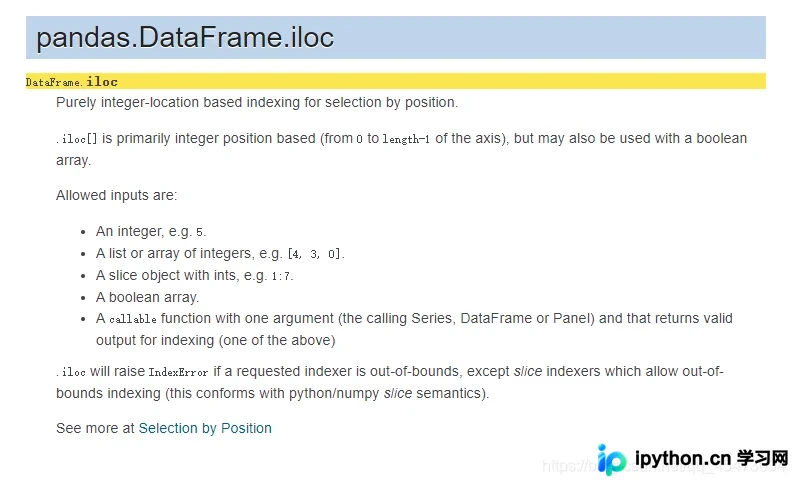
本文详细解析pandas中DataFrame.iloc方法的五种索引方式,包括整数索引、列表索引、切片索引、布尔数组索引及可调用函数索引。通过具体代码示例演示如何精准提取行、列及子集数据,帮助开发者掌握高效的数据筛选技巧。
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。
本文介绍了在 Python 的 Pandas 库中为 DataFrame 添加列名的两种常用方法。第一种是在创建 DataFrame 时通过 columns 参数直接指定;第二种是先创建无列名的 DataFrame,再使用 columns 属性进行赋值。文章提供了具体的代码示例和运行结果,帮助开发者快速掌握相关操作技巧。