Python Pandas fillna() 函数详解:参数、方法及实战代码
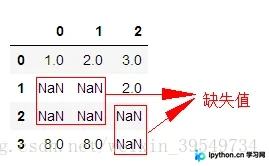
本文详细介绍Pandas中fillna()函数处理缺失值的多种方法。涵盖inplace参数对原对象的影响、method参数(ffill/bfill)的前后填充逻辑,以及limit和axis参数的控制技巧。通过常数填充、字典映射及具体代码示例,帮助开发者高效完成数据清洗任务。
2026-10-15
6

本文详细介绍Pandas中fillna()函数处理缺失值的多种方法。涵盖inplace参数对原对象的影响、method参数(ffill/bfill)的前后填充逻辑,以及limit和axis参数的控制技巧。通过常数填充、字典映射及具体代码示例,帮助开发者高效完成数据清洗任务。
本文详细介绍Pandas中计算相关性系数的corr()方法。涵盖相关性的定义、正负相关判断及系数范围[-1,1]。重点解析method参数的三种选项:pearson(线性)、kendall(分类/无序)和spearman(非线性),并通过一元二次方程示例对比各系数在非线性数据下的表现差异,强调相关性与因果性的区别。
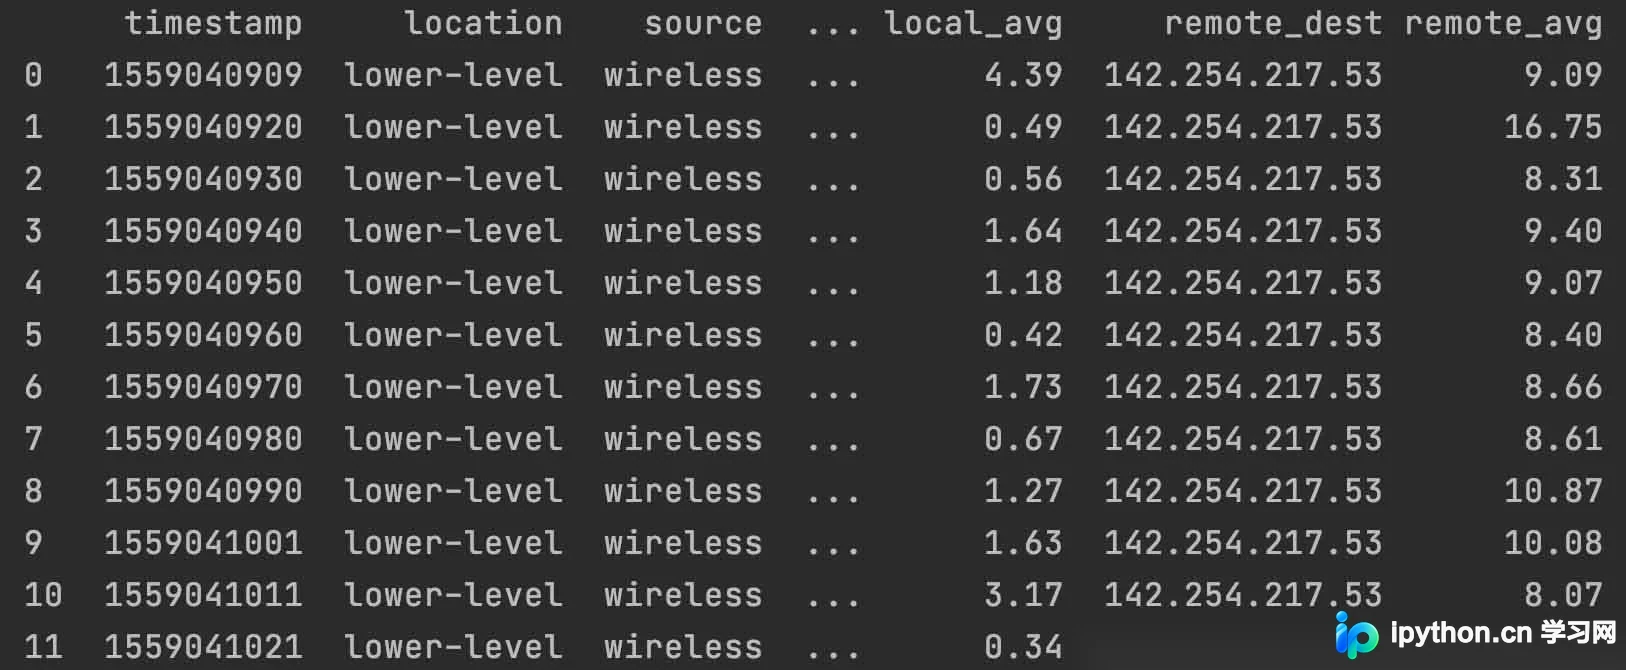
本文详解pandas库中to_datetime()函数的核心用法,重点讲解如何将CSV数据中的Unix时间戳(timestamp)通过指定unit='s'参数转换为标准的datetime格式,并附带代码示例与运行结果分析,帮助开发者高效处理时间序列数据。
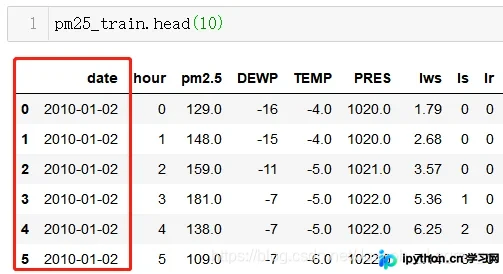
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
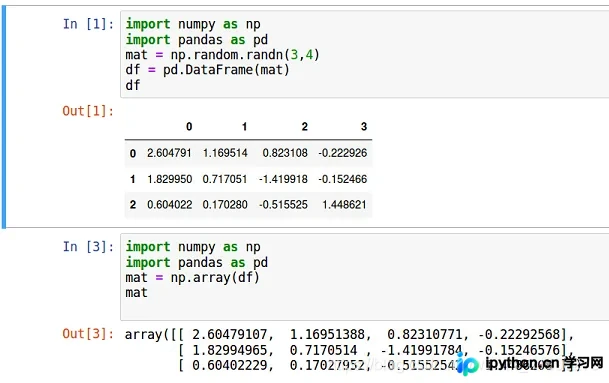
本文介绍Python中NumPy数组与Pandas DataFrame之间的相互转换方法。内容包括将NumPy数组转换为DataFrame,以及将DataFrame转换为NumPy数组的三种常用方式:values方法、as_matrix()方法和np.array()函数,帮助开发者在数据分析时灵活处理两种数据结构。
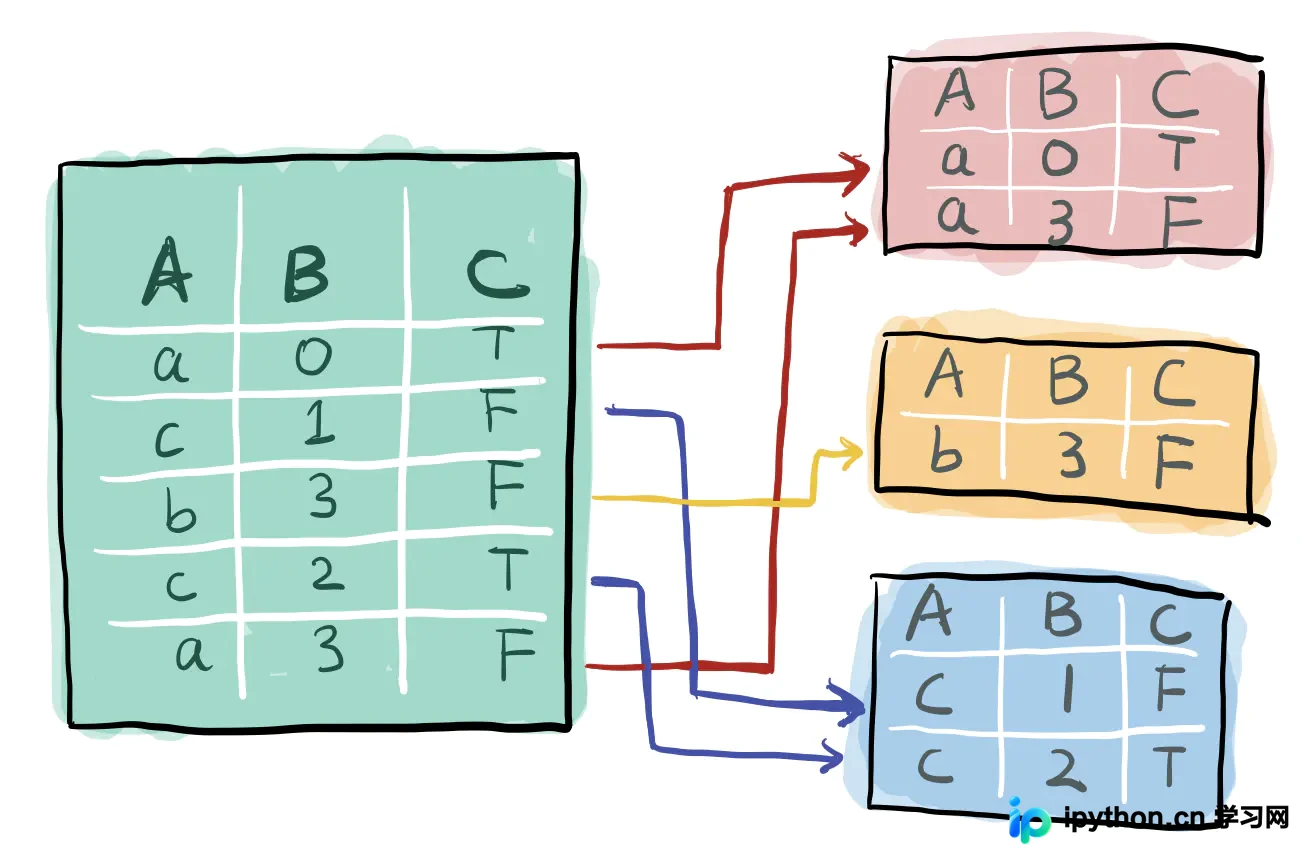
本文深入解析Python Pandas库中groupby函数的核心原理与使用方法。涵盖分组键类型、axis参数设置,详细演示mean、count、size等聚合函数的应用,以及通过agg和apply实现复杂自定义聚合。结合代码实例,讲解多列聚合、字典映射操作及实际数据处理场景,帮助开发者高效掌握数据分组与统计技巧。
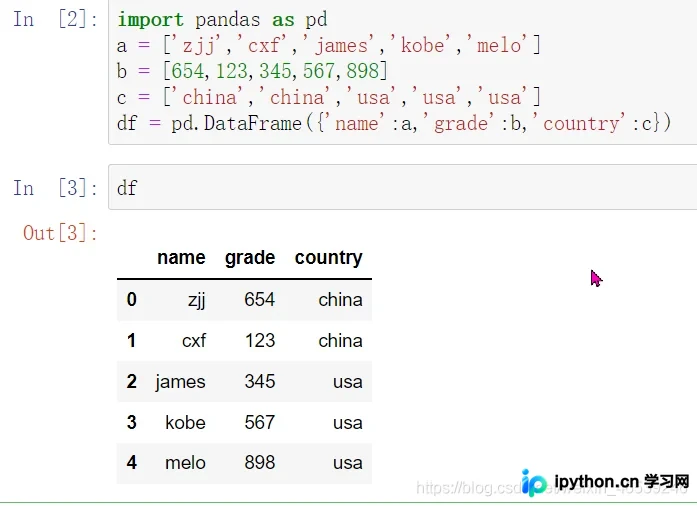
本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。
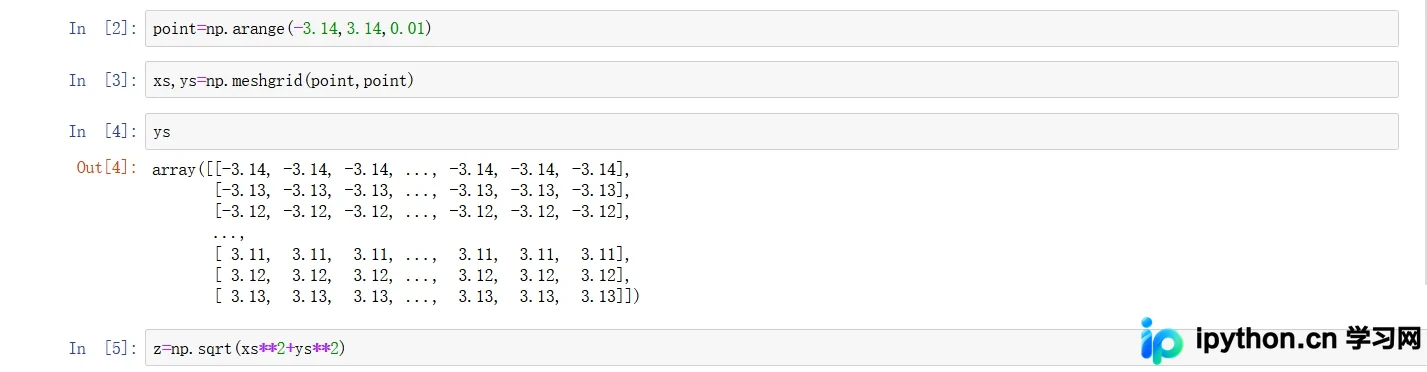
本文详解Python Numpy库中面向数组编程的核心操作。通过向量化计算替代循环,显著提升数据处理效率。深入解析np.where三元表达式、sum/mean等统计聚合函数、布尔数组判定以及unique等集合操作,提供从基础生成到复杂逻辑处理的完整代码示例,助力高效数据分析。
本文详解pandas核心数据结构Series与DataFrame的创建、索引及排序操作,并介绍numpy高效存取硬盘数据的二进制文件格式。涵盖np.save与np.load的使用,以及np.savez保存多个未压缩数据的方法,帮助开发者掌握Python数据分析与存储的基础技能。
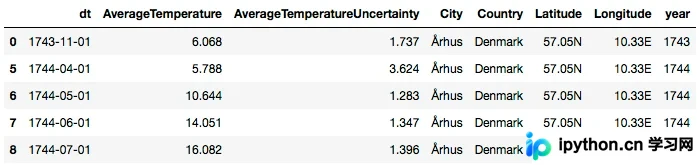
本文详细介绍如何使用Python的matplotlib库绘制各类分析图表。通过引入Salary_Ranges及GlobalLandTemperaturesByCity数据集,演示折线图、饼图、散点图、面积图、直方图及条形图的绘制方法。重点讲解颜色配置、样式选择(如ggplot风格)及图表细节优化,帮助分析师提升图表美观度与专业性。
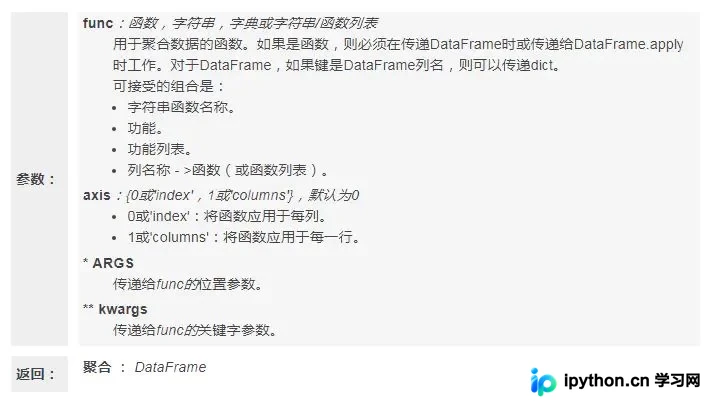
本文详细介绍pandas中DataFrame.agg()聚合函数的使用方法。通过对比numpy聚合函数,解析func参数的多种格式(函数、列表、字典),并演示如何在指定轴上执行单个或不同列的多重聚合操作,包括处理NaN填充的逻辑。
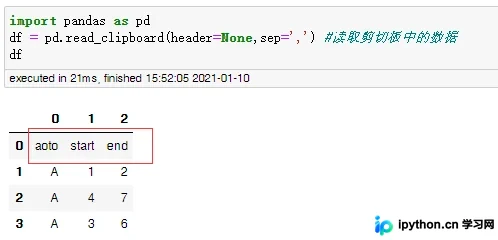
本文介绍如何利用Python的pandas库实现剪贴板数据的读取与写入。通过read_clipboard函数可快速将复制的表格数据转换为DataFrame,支持自定义分隔符与表头处理;利用to_clipboard方法可将DataFrame对象保存至系统剪贴板,便于粘贴至Excel或其他应用。