

Python使用groupby结合apply提取分组最大最小值

发布时间:2026-10-15| 4人浏览过
本文介绍如何在Python中使用pandas的groupby函数结合apply和lambda提取每组数据的最大值与最小值。通过异或逻辑筛选极值,并演示如何重置索引及导出Excel,解决直接groupby无法保留完整行的问题。
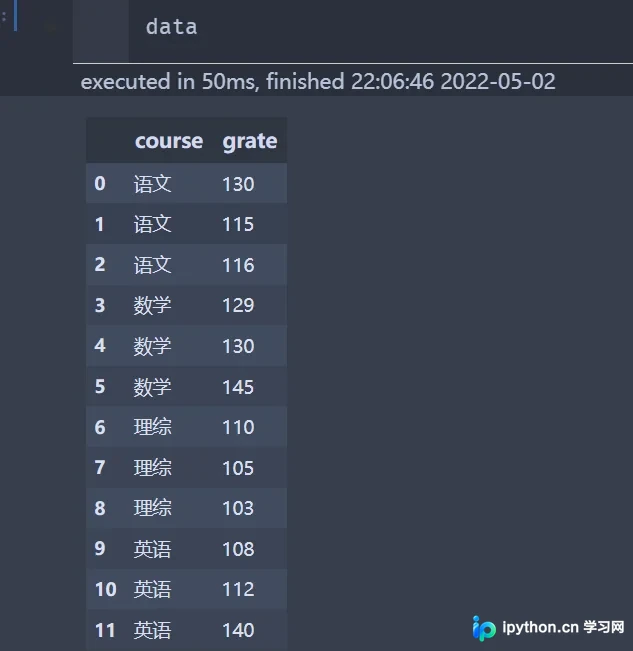
需求背景与目标
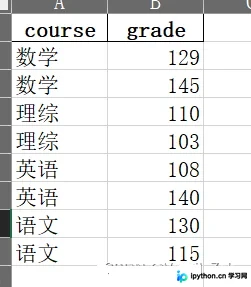
当前需求是对课程(course)数据进行分组,并从每个组中提取成绩(grade)的最大值和最小值,同时保留对应的完整行数据。
期望得到的最终数据结果如下所示。
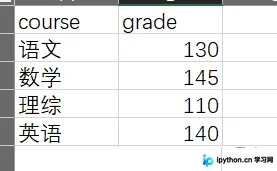
核心实现逻辑
仅使用groupby函数无法直接实现这一效果,必须在groupby操作后追加apply方法,并配合lambda函数进行自定义处理。
代码实现与索引处理
具体实现代码如下。
import pandas as pd
data = pd.read_excel('group_apply.xlsx')
data1 = data.groupby('course').apply(lambda t: t[(t['grade']==t['grade'].min()) ^ (t['grade']==t['grade'].max())])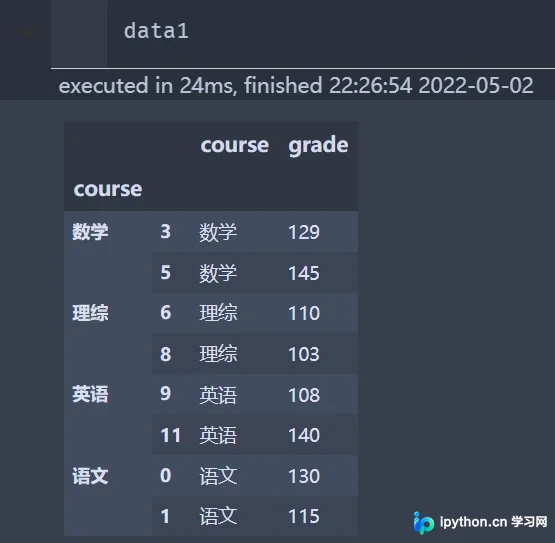
处理后的结果会生成一个MultiIndex索引结构,包含两列层级索引。为了便于后续使用,需要对该索引进行清理,直接删除多余的索引层级即可。
data2 = data1.reset_index(drop=True)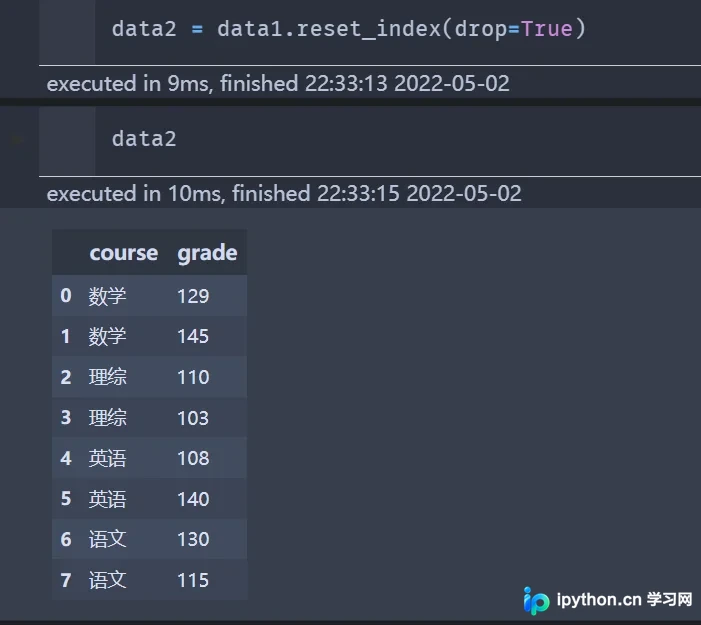
完整代码与导出
将上述步骤整合后的完整代码如下。
import pandas as pd
data = pd.read_excel('group_apply.xlsx')
data1 = data.groupby('course').apply(lambda t: t[(t['grade']==t['grade'].min()) ^ (t['grade']==t['grade'].max())])
data2 = data1.reset_index(drop=True)
最后,将处理好的数据写入到Excel文件中。
至此,关于Python groupby函数实现分组后选取最值的方法介绍完毕。如需了解更多Python groupby相关内容,欢迎查阅本站往期文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









