

Python 高效处理千万级数据写入 MySQL:Navicat、Pymysql 与 Pandas 方案对比

本文系统分享将千万级数据写入 MySQL 的两种场景及对应方案。针对非频繁写入,推荐使用 Navicat 导入向导;针对增量自动化写入,对比了 Pymysql 与 Pandas+SQLAlchemy 两种 Python 实现方式。测试显示,Pandas 方案仅需五行代码且耗时约 4 分钟,远优于 Pymysql 的 12 分 47 秒,且无需预先建表,推荐作为高效首选。
前言
在开发工作中,通过 Python 读取数据并自动写入 MySQL 数据库是一项常见需求,涉及数据库的读写与更新操作。虽然数据库类型可能包括 MongoDB、ES 等,但核心处理思路相似,仅需调整数据库操作语法即可。本文将系统介绍如何将千万级数据写入 MySQL,涵盖两种典型场景及对应的实现方式。
场景一:数据不需要频繁的写入mysql
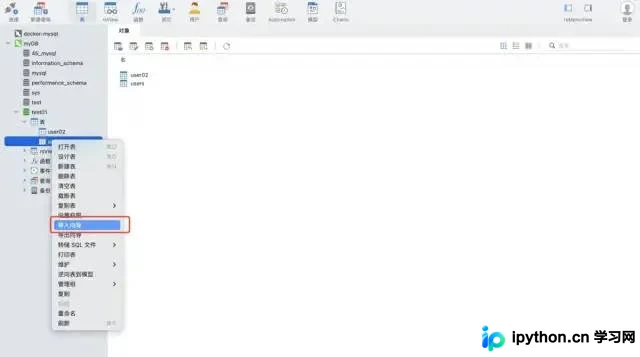
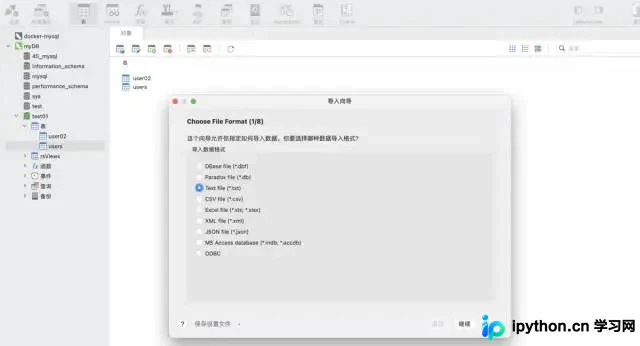
推荐使用 Navicat 工具的导入向导功能。该功能支持多种文件格式,能够根据文件字段自动创建新表,或向已有表中插入数据,操作非常快捷方便。
场景二:数据是增量的,需要自动化并频繁写入mysql
测试数据采用 CSV 格式,规模约为 1200 万行。
import pandas as pd
data = pd.read_csv('./tianchi_mobile_recommend_train_user.csv')
data.shape
打印结果:

方式一:python ➕ pymysql 库
安装 pymysql 命令:
pip install pymysql代码实现:
import pymysql
# 数据库连接信息
conn = pymysql.connect(
       host='127.0.0.1',
       user='root',
       passwd='wangyuqing',
       db='test01',
       port = 3306,
       charset="utf8")
# 分块处理
big_size = 100000
# 分块遍历写入到 mysql
with pd.read_csv('./tianchi_mobile_recommend_train_user.csv',chunksize=big_size) as reader:
    for df in reader:
        datas = []
        print('处理:',len(df))
#         print(df)
        for i ,j in df.iterrows():
            data = (j['user_id'],j['item_id'],j['behavior_type'],
                    j['item_category'],j['time'])
            datas.append(data)
        _values = ",".join(['%s', ] * 5)
        sql = """insert into users(user_id,item_id,behavior_type
        ,item_category,time) values(%s)""" % _values
        cursor = conn.cursor()
        cursor.executemany(sql,datas)
        conn.commit()
 # 关闭服务
conn.close()
cursor.close()
print('存入成功!')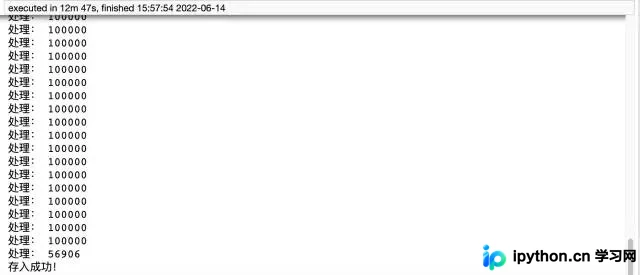
方式二:pandas ➕ sqlalchemy:pandas 需要引入 sqlalchemy 来支持 SQL,在 sqlalchemy 的支持下,它可以实现所有常见数据库类型的查询、更新等操作。
代码实现:
from sqlalchemy import create_engine
engine = create_engine('mysql+pymysql://root:wangyuqing@localhost:3306/test01')
data = pd.read_csv('./tianchi_mobile_recommend_train_user.csv')
data.to_sql('user02',engine,chunksize=100000,index=None)
print('存入成功!')
总结
Pymysql 方法耗时 12 分 47 秒,耗时较长且代码量大;而 Pandas 方案仅需五行代码即可实现该需求,耗时仅约 4 分钟。此外,方式一需要提前建表,方式二则无需此步骤。因此,推荐大家使用第二种方式,既方便又效率高。若仍觉得速度不够快,可考虑引入多进程或多线程优化。
最全的三种将数据存入到 MySQL 数据库方法:
- 直接存,利用 navicat 的导入向导功能
- Python pymysql
- Pandas sqlalchemy
到此这篇关于Python 读取千万级数据自动写入 MySQL 数据库的文章就介绍到这了,更多相关Python 读取数据内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









