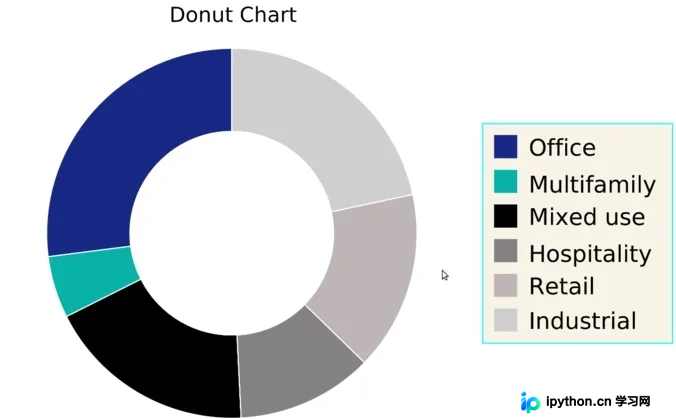
Python利用matplotlib绘制圆环图(环形图)的实战案例
本文详细介绍如何使用Python的matplotlib库绘制圆环图(Donut Chart)。文章从圆环图与饼图的对比入手,通过空气质量评级数据展示实战案例,深入解析wedgeprops、startangle及text等关键参数的用法,并提供完整代码与效果演示,帮助读者掌握多环对比与内部标注技巧。
2026-10-15
6

本文详细介绍如何使用Python的matplotlib库绘制圆环图(Donut Chart)。文章从圆环图与饼图的对比入手,通过空气质量评级数据展示实战案例,深入解析wedgeprops、startangle及text等关键参数的用法,并提供完整代码与效果演示,帮助读者掌握多环对比与内部标注技巧。
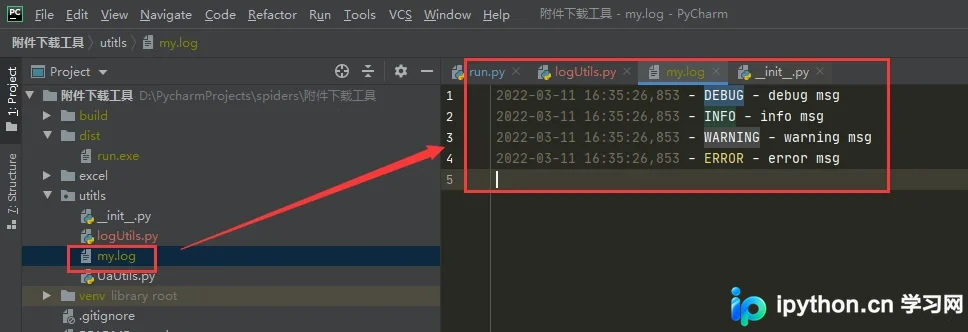
本文介绍如何使用Python和pandas编写命令行脚本处理Excel文件。内容包括封装logging日志模块、接收操作目录、检测并读取唯一Excel文件、自动备份、异常处理、动态添加列以及进度展示与阶段保存等实用技巧,帮助开发者高效完成数据批量处理任务。
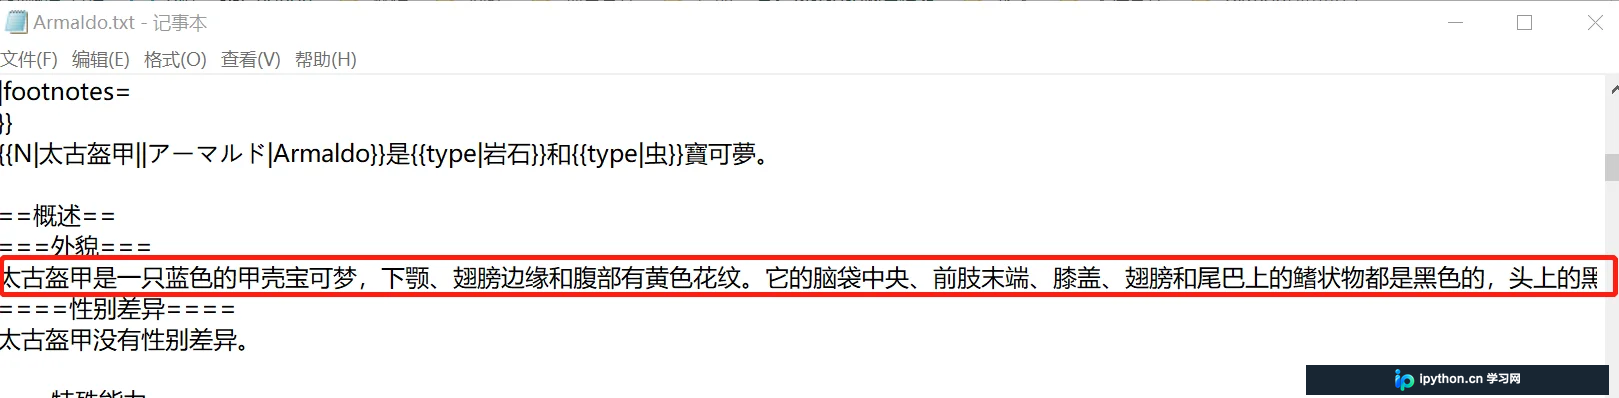
本文介绍如何使用Python批量从TXT文件中提取特定文本并写入Excel。通过正则表达式匹配特定标识符(如栖息地描述),结合Pandas库扩展数据框列,实现非结构化数据的结构化处理。文中包含代码示例与参数说明,解决跨行匹配及编码问题,适用于数据清洗与批量处理场景。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
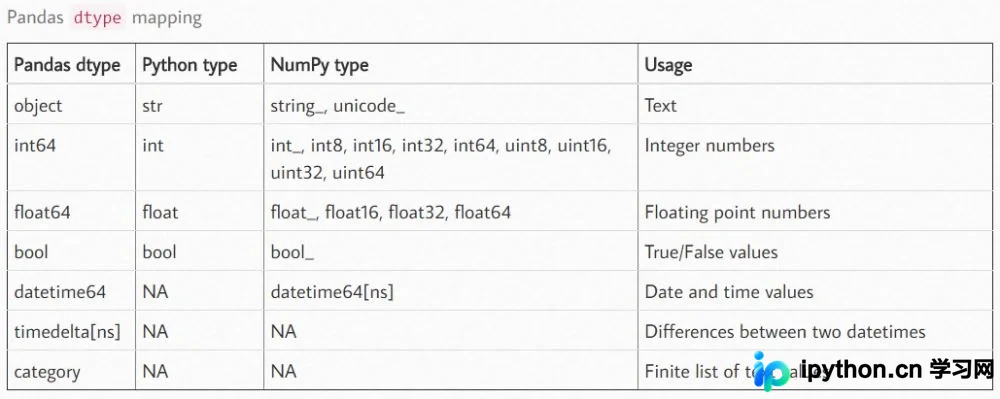
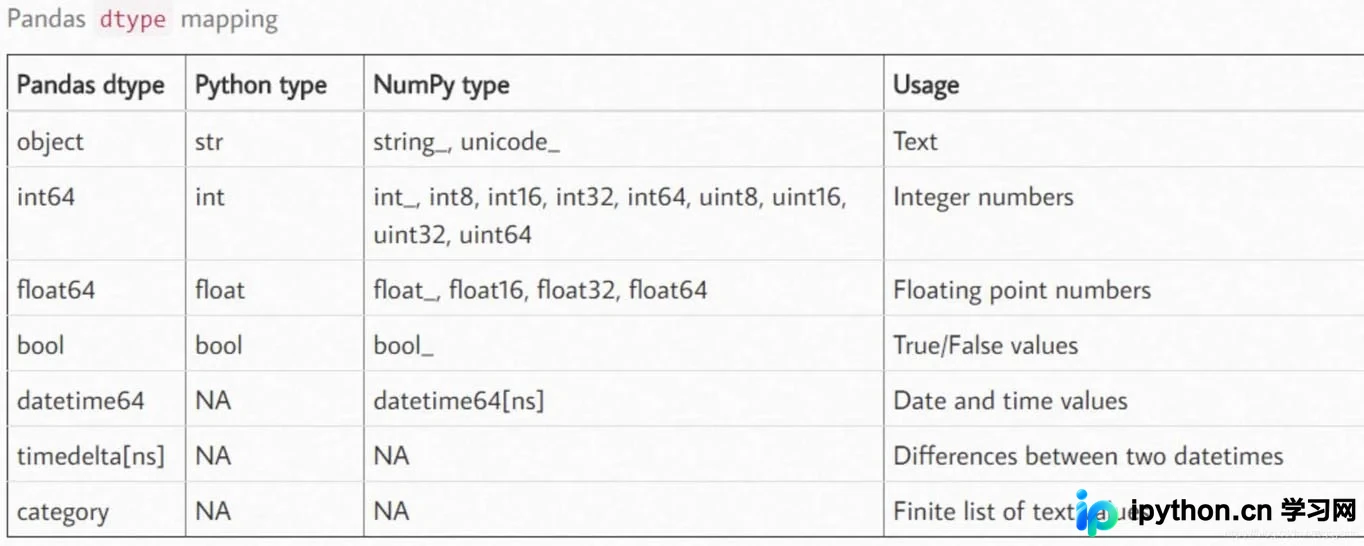
本文详细介绍Pandas中查看和转换数据类型的核心方法。通过df.dtypes、df.shape及df.info()快速获取数据框的维度、列名、非空计数及内存占用等关键信息。重点讲解df.astype()函数的多种用法,包括全局转换、指定列转换及索引类型转换,并深入解析object类型的特殊性及其清洗策略,帮助开发者高效处理数据格式问题。
本文系统整理了Python中Pandas库的45个高频实用命令,涵盖数据读取、类型转换、缺失值处理、时间序列分析及数据可视化等核心场景。通过具体代码示例,帮助开发者快速掌握高效处理大型数据集的方法,提升数据分析与建模效率。
本文详细介绍Pandas中astype()函数的用法,涵盖基础类型转换、处理非标准数据格式(如含百分号的字符串)以及加载时指定类型。通过示例解析如何安全地将数值、字符串及时间类型进行转换,并指出转换失败时的处理策略,帮助开发者高效进行数据清洗。
本文深入解析Pandas中sort_values()函数的核心用法,涵盖by、axis、ascending等关键参数的配置细节。通过Series与DataFrame的实例演示,展示单列、多列及混合升降序的排序技巧,并补充处理缺失值、原地修改及索引重置等高级操作,帮助开发者高效实现数据排序需求。
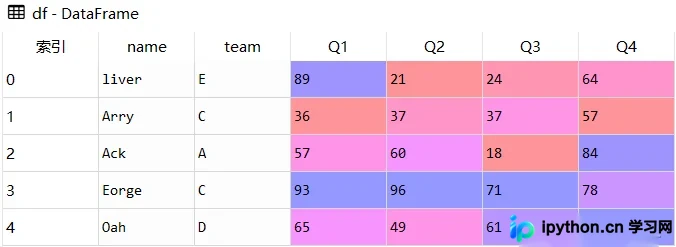
本文详细介绍Pandas中df.sort_index()函数的使用方法,包括默认的升序排列及通过ascending=False实现降序排序。同时讲解df.reindex()如何自定义行和列的索引顺序,涵盖axis参数及具体代码示例,帮助开发者高效管理DataFrame数据顺序。
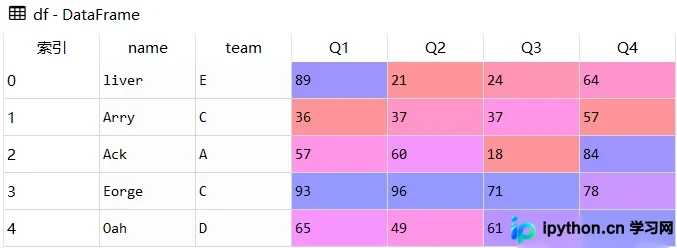
本文详细介绍Pandas库中df.dropna()函数的使用方法,涵盖axis、how、thresh、subset及inplace等核心参数的具体含义与操作示例。通过代码演示整行整列删除、条件过滤及原地修改等常见场景,帮助开发者高效处理数据中的空值。
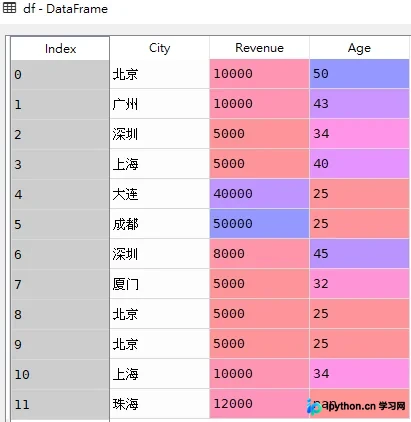
本文详细介绍Pandas库中value_counts()方法的使用。该函数用于统计Series或DataFrame指定列中各值的出现频次,返回排序后的Series。文章解析了sort、ascending、normalize、bins及dropna等关键参数的具体作用,并通过包含城市、营收及年龄数据的DataFrame示例,演示了降序、升序、标准化占比计算以及NaN值处理等实际应用场景。
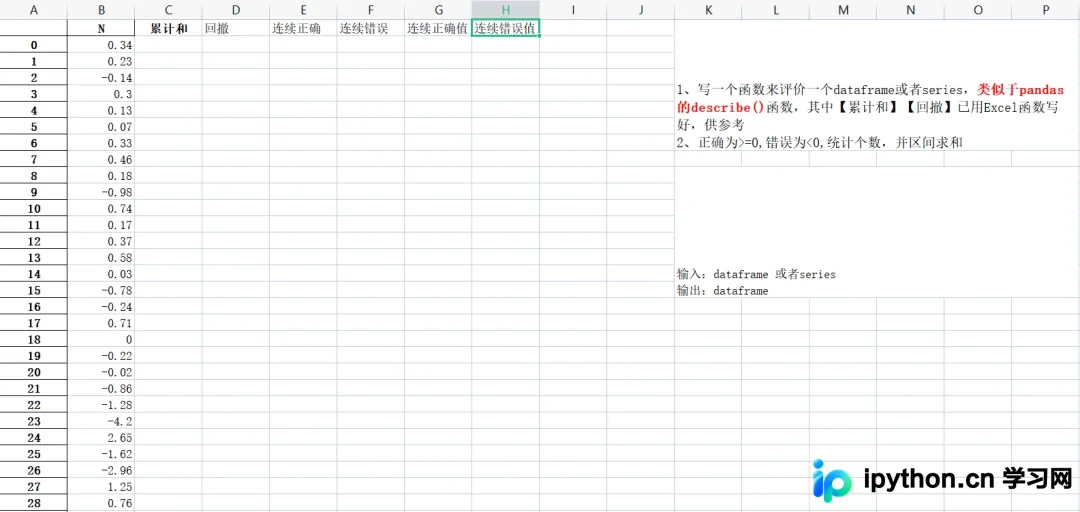
本文介绍如何使用Python和Pandas库,对Excel原始数据进行统计分析。通过基础语法实现累计和、最大回撤、连续正确/错误次数及对应值的计算逻辑,并将结果保存回Excel文件,帮助开发者掌握数据处理的基本流程。