

Python Pandas中iloc与loc切片用法详解
本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。
2026-10-15
6

本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。
本文通过10个具体示例,详细讲解如何使用Python的Seaborn库绘制分布图。内容涵盖直方图、核密度估计(KDE)图和经验累积分布函数(Ecdf)图的创建与参数调整,包括处理异常值、分类变量分组及二维分布等场景,帮助读者掌握数据探索中的关键可视化技巧。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文介绍Python数据分析中Numpy库的核心使用方法。涵盖通过array、arange及random模块创建多维数组,详解dtype、ndim和shape属性以查看数据类型与维度,并简述ones、zeros等辅助创建函数,帮助初学者快速掌握Numpy基础操作。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作。涵盖通过 index 和 columns 获取索引,利用 []、loc、iloc、at、iat 进行元素查询;使用 rename 修改行列索引,通过指定位置赋值修改元素值;以及利用 drop 方法按标签或轴删除行与列,并解析各方法的参数与注意事项。
本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
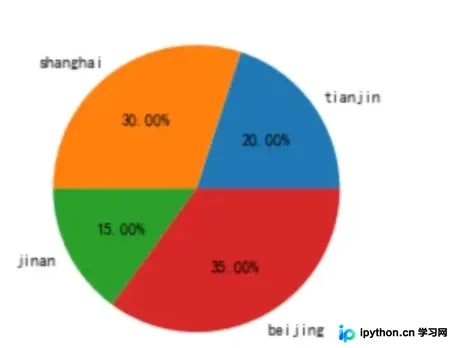
本文详细介绍如何使用Python的Matplotlib库绘制饼图。通过plt.pie()方法,可自定义数据、标签、颜色及百分比格式。文章列举了explode、autopct等关键参数,并附带完整代码示例,帮助开发者快速掌握饼图可视化技巧。
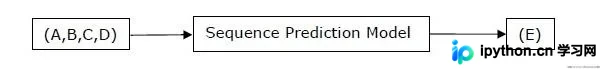
本文介绍如何使用Python进行时间序列数据分析。内容涵盖Pandas库的安装与使用,包括数据读取、切片、统计提取及重采样;同时详解隐马尔可夫模型(HMM)在序列预测中的应用,涵盖其数学定义与状态转换概率矩阵等核心概念。
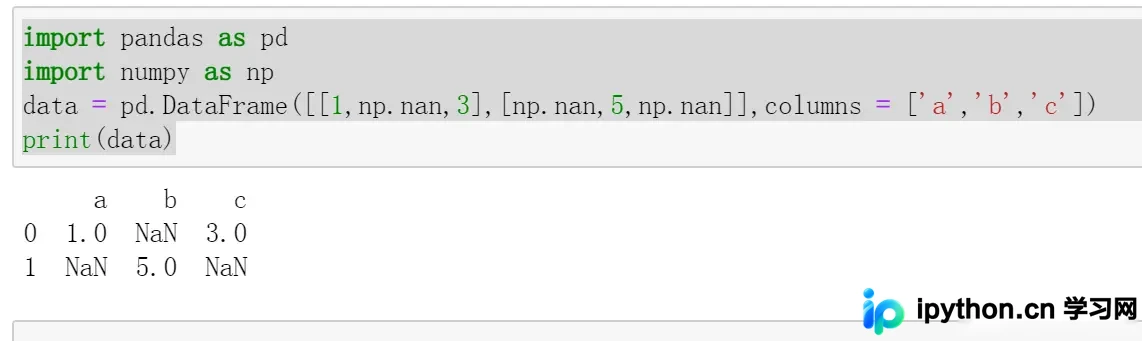
本文详解Python中处理缺失值的两种核心策略:删除与填充。通过演示isnull/isna检测空值,使用dropna按行或阈值删除含NaN数据,以及利用fillna结合均值进行数据补全,帮助开发者掌握Pandas中缺失值处理的关键函数与参数设置。
在R语言中,常需将连续数值转换为分类数据。本文介绍三种实现方式:使用attach/detach进行直接索引赋值;使用within()优化作用域管理;以及利用cut()函数配合breaks、labels及区间控制参数(right、include.lowest)进行高效分箱。重点解析cut函数的开闭区间逻辑及极端值处理细节。
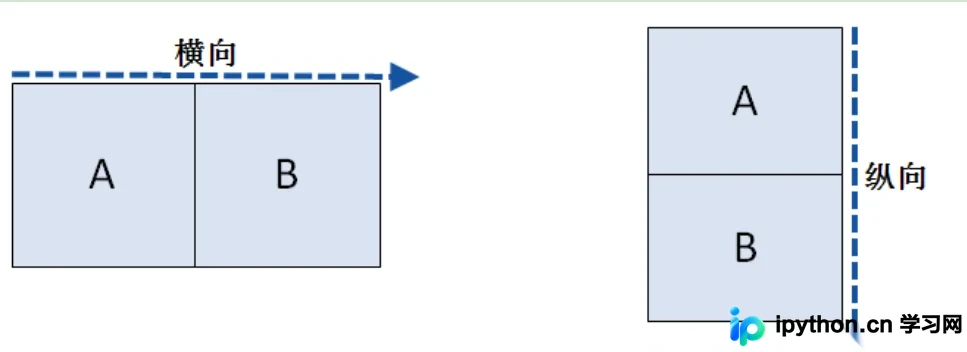
本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。