

Python Pandas 数据结构详解:Series、DataFrame 与 Index

本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。
前言:
Pandas 库主要包含三种数据结构:Series、DataFrame 和 Panel。其中,Series 类似于一维数组;DataFrame 类似于二维表格;而 Panel 可被视为包含多个 Sheet 的多维数据容器(注:新版 Pandas 中 Panel 已弃用,此处保留原文描述)。
1.Series
Series 是一种一维标记数组对象,它包含一个值序列以及对应的数据标签,即索引(index)。用户可以通过索引来高效地访问数组中的具体数据。
1.1通过列表创建Series
示例1:通过列表创建 Series
import pandas as pd
obj = pd.Series([1,-2,3,4])   #仅由一个数组构成
print(obj)
输出结果如下:
0 1 1 -2 2 3 3 4 dtype: int64
输出结果的第一列为 index(索引),第二列为 value(数据值)。如果在创建 Series 时未指定 index,Pandas 会自动使用整数序列作为索引。此外,还可以利用 Python 原有的索引和切片技术来访问数据。
示例2:创建 Series 时指定索引
import pandas as pd
i = ["a","c","d","a"]
v = [2,4,5,7]
t = pd.Series(v,index=i,name="col")
print(t)
输出:
a 2 c 4 d 5 a 7 Name: col, dtype: int64
即使创建 Series 时指定了 index,Pandas 内部仍保留隐藏的整数位置索引。因此,Series 提供两种数据访问方式:基于位置(positional)和基于标签(label)。
示例3:Series 位置索引与标签索引的使用
import pandas as pd
val = [2,4,5,6]
idx1 = range(10,14)
idx2 = "hello the cruel world".split()
s0 = pd.Series(val)
s1 = pd.Series(val,index=idx1)
t = pd.Series(val,index=idx2)
print(s0.index)
print(s1.index)
print(t.index)
print(s0[0])
print(s1[10])
print('default:',t[0],'label:',t["hello"])
1.2通过字典创建Series
如果数据存储在 Python 字典中,可以直接利用该字典创建 Series。
示例4:通过字典创建 Series
import pandas as pd
sdata = {'Ohio':35000,'Texass':71000,'Oregon':16000,'Utah':5000}
obj = pd.Series(sdata)
print(obj)
Ohio 35000 Texass 71000 Oregon 16000 Utah 5000 dtype: int64
若仅传入一个字典,生成的 Series 索引将对应原字典的键(按字母顺序排列)。
示例5:通过字典创建 Series 时的索引行为
import pandas as pd
sdata = {"a":100,"b":200,"e":300}
obj = pd.Series(sdata)
print(obj)
a 100 b 200 e 300 dtype: int64
如果字典中的键与指定的索引列表不匹配,对应缺失索引的值将显示为 NaN(Not a Number)。
示例6:字典键值与指定索引不匹配的情况
import pandas as pd
sdata = {"a":100,"b":200,"e":300}
letter = ["a","b","c","e"]
obj = pd.Series(sdata,index=letter)
print(obj)
a 100.0 b 200.0 c NaN e 300.0 dtype: float64
Series 的一个重要功能是:在进行算术运算时,它会自动根据索引对齐不同 Series 的数据。
示例7:不同索引数据的自动对齐
import pandas as pd
sdata = {'Ohio':35000,'Texas':71000,'Oregon':16000,'Utah':5000}
obj1 = pd.Series(sdata)
states = ['California','Ohio','Oregon','Texas']
obj2 = pd.Series(sdata,index=states)
print(obj1+obj2)
California NaN Ohio 70000.0 Oregon 32000.0 Texas 142000.0 Utah NaN dtype: float64
Series 的索引可以通过赋值操作进行就地修改。
示例8:Series 索引的修改
import pandas as pd
obj = pd.Series([4,7,-3,2])
obj.index = ['Bob','Steve','Jeff','Ryan']
print(obj)
Bob 4 Steve 7 Jeff -3 Ryan 2 dtype: int64
2.DataFrame
DataFrame 是一种表格型数据结构,包含一组有序的列,每列可以是不同的数据类型(如数值、字符串、布尔值等)。DataFrame 同时拥有行索引和列索引,可视为由共享同一索引的 Series 组成的字典。与其他数据结构相比,DataFrame 在面向行和面向列的操作上保持了较好的平衡。
构建 DataFrame 的方式多样,最常用的是传入一个由等长列表或 NumPy 数组组成的字典。
示例9:DataFrame 的创建
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data)
print(df)
name sex year city 0 张三 female 2001 北京 1 李四 female 2001 上海 2 王五 male 2003 广州 3 小明 male 2002 北京
DataFrame 会自动生成整数索引(与 Series 类似),且所有列会按字母顺序排列。如果指定了列名序列,DataFrame 的列将按照指定顺序排列。
示例10:DataFrame 的列索引控制
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city'])
print(df)
name year sex city 0 张三 2001 female 北京 1 李四 2001 female 上海 2 王五 2003 male 广州 3 小明 2002 male 北京
与 Series 类似,如果传入的列名在原始数据中不存在,生成的 DataFrame 中对应位置将填充 NaN 值。
示例11:DataFrame 创建时的空缺值处理
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'])
print(df)
name year sex city address 0 张三 2001 female 北京 NaN 1 李四 2001 female 上海 NaN 2 王五 2003 male 广州 NaN 3 小明 2002 male 北京 NaN
DataFrame 构造函数允许通过 columns 参数指定列名,通过 index 参数指定行标签。
示例12:DataFrame 构建时指定列名与行索引
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'],index = ['a','b','c','d'])
print(df)
name year sex city address a 张三 2001 female 北京 NaN b 李四 2001 female 上海 NaN c 王五 2003 male 广州 NaN d 小明 2002 male 北京 NaN
3.索引对象
Pandas 的索引对象(Index)负责管理轴标签及其他元数据(如轴名称)。在构建 Series 或 DataFrame 时,提供的任何数组或序列标签都会被转换为 Index 对象。
示例13:显示 DataFrame 的索引和列名
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'],index = ['a','b','c','d'])
print(df)
print(df.index)
print(df.columns)
name year sex city address a 张三 2001 female 北京 NaN b 李四 2001 female 上海 NaN c 王五 2003 male 广州 NaN d 小明 2002 male 北京 NaN Index(['a', 'b', 'c', 'd'], dtype='object') Index(['name', 'year', 'sex', 'city', 'address'], dtype='object')
索引对象是不可变的,尝试修改会引发错误。这种不可变性至关重要,因为它确保了 Index 对象可以在多个数据结构之间安全共享。除了具备数组外观,Index 的功能还类似于固定大小的集合。
示例14:检查 DataFrame 的 Index 成员资格
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'],index = ['a','b','c','d'])

print('name'in df.columns)
print('a'in df.index)
True
True
每个索引对象都提供了一些方法和属性,用于执行逻辑判断并回答关于索引包含数据的常见问题。
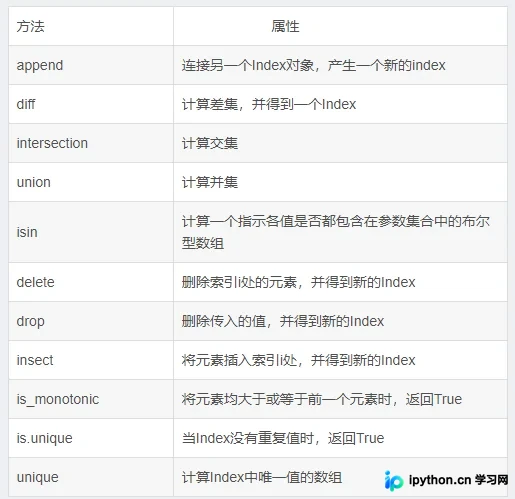
示例15:尝试插入索引值(注:Index 不可变,此操作通常需生成新 Index)
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'],index = ['a','b','c','d'])

df.index.insert(1,'w')
Index(['a', 'w', 'b', 'c', 'd'], dtype='object')
4.查看DataFrame的常用属性
DataFrame 的基础属性包括 values、index、columns、dtypes、ndim 和 shape,分别用于获取数据值、索引、列名、数据类型、维度数和形状。
示例16:显示 DataFrame 的各项属性
import pandas as pd
data = {
    'name':['张三','李四','王五','小明'],
    'sex':['female','female','male','male'],
    'year':[2001,2001,2003,2002],
    'city':['北京','上海','广州','北京']
}
df = pd.DataFrame(data,columns = ['name','year','sex','city','address'],index = ['a','b','c','d'])

print(df)
print('信息表的所有值为:\n',df.values)
print('信息表的所有列为:\n',df.columns)
print('信息表的元素个数:\n',df.size)
print('信息表的维度:\n',df.ndim)
print('信息表的形状:\n',df.shape)
 #//输出
  name  year     sex city address
a   张三  2001  female   北京     NaN
b   李四  2001  female   上海     NaN
c   王五  2003    male   广州     NaN
d   小明  2002    male   北京     NaN
信息表的所有值为:
 [['张三' 2001 'female' '北京' nan]
 ['李四' 2001 'female' '上海' nan]
 ['王五' 2003 'male' '广州' nan]
 ['小明' 2002 'male' '北京' nan]]
信息表的所有列为:
 Index(['name', 'year', 'sex', 'city', 'address'], dtype='object')
信息表的元素个数:
 20
信息表的维度:
 2
信息表的形状:
 (4, 5)
到此这篇关于 Python Pandas 中的数据结构详解的文章就介绍到这了,更多相关Python Pandas 内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









