

Python实现免验证码获取上学吧题目答案

本文介绍如何使用Python脚本绕过上学吧网站的验证码限制,自动获取题目详情与答案。通过构造随机X-Forwarded-For头信息规避IP检测,结合requests和BeautifulSoup库下载并解析验证码图片,用户只需手动输入计算结果即可实现免验证跳转查看内容。
Python绕过验证码获取题目答案教程
在浏览网页时,许多用户常遇到必须输入验证码才能继续访问的情况。面对此类限制,常规做法往往涉及繁琐的注册或验证流程。本文提供一种基于Python的解决方案,旨在帮助用户无需进行传统验证即可访问相关内容。
以常见的问答平台“上学吧”为例,访问其答案页面时通常会弹出验证提示,要求通过验证后方可查看具体内容。接下来将展示如何利用Python脚本实现跳过这一验证码环节的操作。
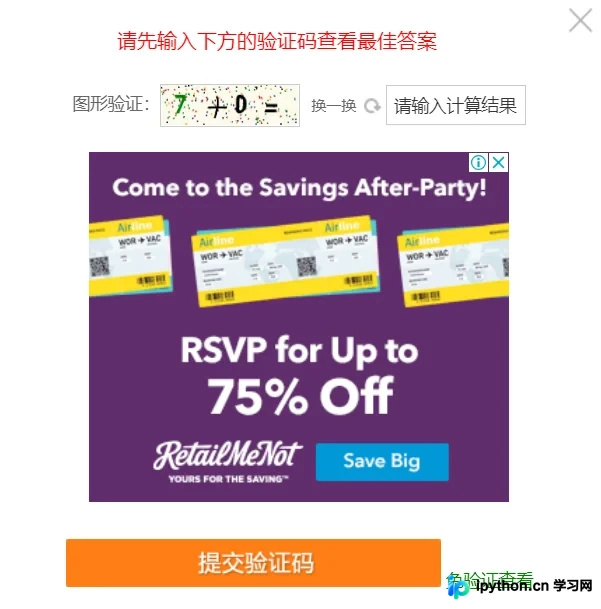
核心思路是通过Python构造随机的X-Forwarded-For请求头信息,以此绕过基于ASP架构网站的IP地址检测机制。该脚本还具备对输入网址格式进行正确性校验的功能,并能处理验证码验证失败时的重试逻辑。
Python脚本代码实现
实现该功能的Python代码示例如下:
完整代码解析
# 绕过验证码无限次获取上学吧题目答案
# 上学吧网址:https://www.shangxueba.com/ask
import os
import random
import requests
import urllib3
urllib3.disable_warnings() # 这句和上面一句是为了忽略 https 安全验证警告,参考:https://www.cnblogs.com/ljfight/p/9577783.html
from bs4 import BeautifulSoup
from PIL import Image
def get_verifynum(session): # 网址的验证码逻辑是先去这个网址获取验证码图片,提交计算结果到另外一个网址进行验证。
r = session.get("https://www.shangxueba.com/ask/VerifyCode2.aspx", verify=False) # HTTPS 请求进行 SSL 验证或忽略 SSL 验证才能请求成功,忽略方式为 verify=False。参考:https://www.cnblogs.com/ljfight/p/9577783.html
with open('temp.png','wb+') as f:
f.write(r.content)
image = Image.open('temp.png')
image.show() # 调用系统的图片查看软件打开验证码图片,如果不能打开,可以自己找到 temp.png 打开。
verifynum = input("\n请输入验证码图片中的计算结果:")
image.close()
os.remove("temp.png")
return verifynum
def get_question(session):
r = session.get(link)
soup = BeautifulSoup(r.content, "html.parser")
description = soup.find(attrs={"name":"description"})['content'] # 抓取题干内容
return description
def get_answer(session, verifynum, dataid):
data1 = {
"Verify": verifynum,
"action": "CheckVerify",
}
session.post("https://www.shangxueba.com/ask/ajax/GetZuiJia.aspx", data=data1) # 核查验证码正确性
data2 = {
"phone":"",
"dataid": dataid,
"action": "submitVerify",
"siteid": "1001",
"Verify": verifynum,
}
r = session.post("https://www.shangxueba.com/ask/ajax/GetZuiJia.aspx", data=data2)
soup = BeautifulSoup(r.content, "html.parser")
ans = soup.find('h6')
print("\n" + '-'*45)
if(ans): # 只有验证码核查通过才会显示答案
print("\n题目:" + get_question(session))
print(ans.text)
else:
print('\n没有找到答案!请检查验证码或网址是否输入有误!\n')
print('-'*45)
if __name__ == '__main__':
s = requests.session()
while True:
s.headers.update({"X-Forwarded-For":"%d.%d.%d.%d"%(random.randint(120,125),random.randint(1,200),random.randint(1,200),random.randint(1,200))}) # 这一句是整个程序的关键,通过修改 X-Forwarded-For 信息来欺骗 ASP 站点对于 IP 的验证。
link = input("\n请输入上学吧网站上某道题目的网址,例如:https://www.shangxueba.com/ask/8952241.html\n\n请输入:").strip() # 过滤首尾的空格
if(link[0:31] != "https://www.shangxueba.com/ask/" or link[-4:] != "html"):
print("\n网址输入有误!请重新输入!\n")
continue
dataid = link.split("/")[-1].replace(r".html","") # 提取网址最后的数字部分
if(dataid.isdigit()): # 根据格式,dataid 应该全部为数字,判断字符串是否全部为数字,返回 True 或者 False
verifynum = get_verifynum(s)
get_answer(s, verifynum, dataid)
else:
print("\n网址输入有误!请重新输入!\n")
continue
请注意,运行脚本前需确保已安装requests和beautifulsoup4两个第三方库。推荐使用pip工具进行安装,具体命令如下:
pip install requests pip install beautifulsoup4
脚本运行流程与步骤
Python脚本的具体运行步骤如下:
首先,复制目标题目在上学吧网站上的完整URL,格式通常如下所示:
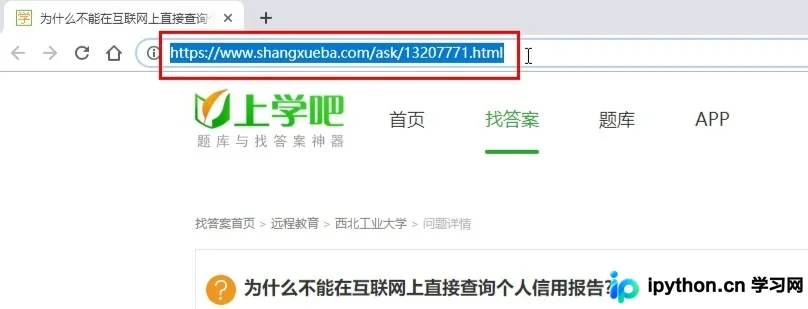
随后运行编写好的Python脚本,将复制的网址粘贴至命令行提示处。
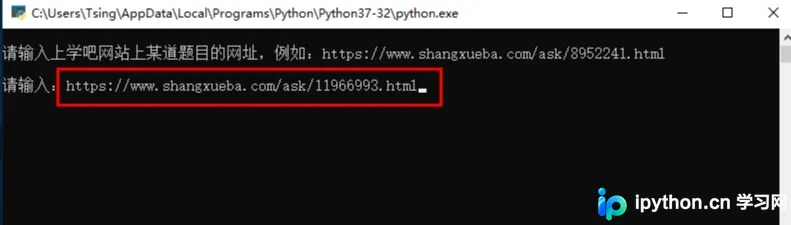
按下Enter键后,程序会自动下载验证码图片并将其保存为当前目录下的temp.png文件。同时,脚本会调用系统默认图片查看器展示该验证码;若自动打开失败,用户也可手动前往同目录查找并打开temp.png文件。
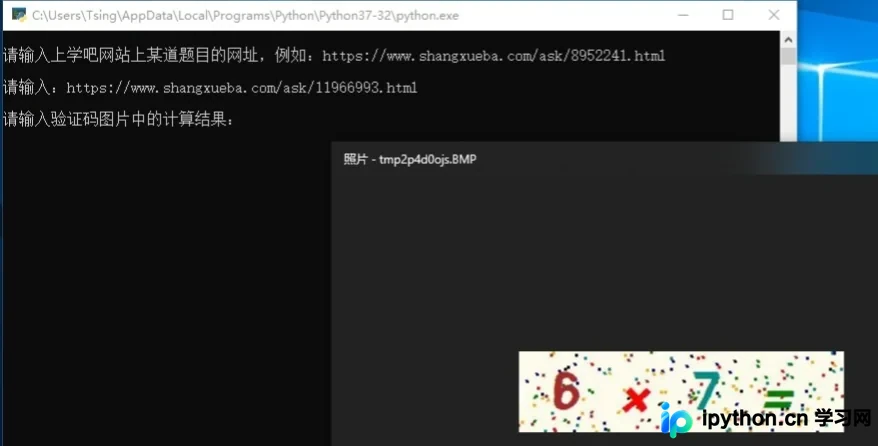
最后,在命令行窗口中输入验证码图片所示的计算结果。验证通过后,程序将返回题目详情及正确答案。
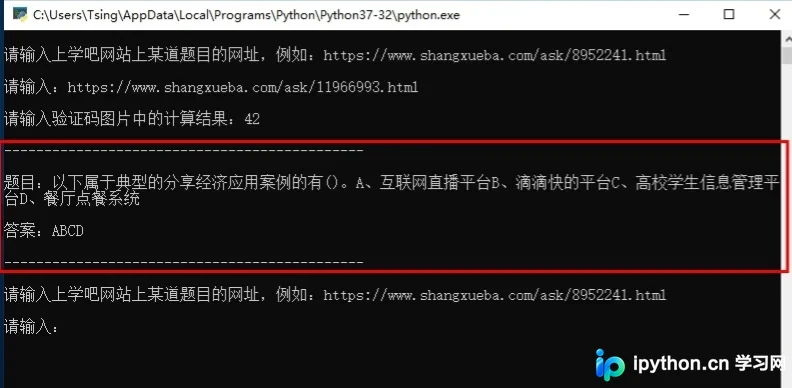
以上就是关于利用Python免验证跳转至内容页的完整实现过程。如需了解更多相关技巧,可查阅本站过往文章或继续关注后续更新。感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









