
Python爬虫实战:基于维基百科的六度分隔遍历算法
本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
2026-10-13
6


本文详解如何使用Python编写爬虫程序,通过BeautifulSoup解析HTML并配合正则表达式过滤有效词条链接,实现维基百科“六度分隔理论”的自动化遍历。文章涵盖链接提取、随机路径生成及随机数种子设置等核心步骤,旨在帮助开发者理解单域名遍历爬虫的基本逻辑与注意事项。
本文详细解析Python中Beautiful库如何结合Lambda表达式进行网页数据抓取。通过具体案例演示如何利用匿名函数筛选具有特定属性数量的标签,并展示如何用Lambda替代内置find_all参数。此外,还介绍了结合正则表达式匹配属性字符串模式的进阶用法,帮助开发者灵活处理复杂的HTML解析需求。
本文详细介绍如何使用Python编写爬虫程序,从笔趣网爬取小说《一念永恒》。重点讲解BeautifulSoup库的安装与使用,包括通过开发者工具定位HTML元素、构造带User-Agent的HTTP请求以及解析响应数据的具体步骤。旨在帮助初学者掌握基础的网络数据采集技巧,同时强调支持正版阅读的重要性。
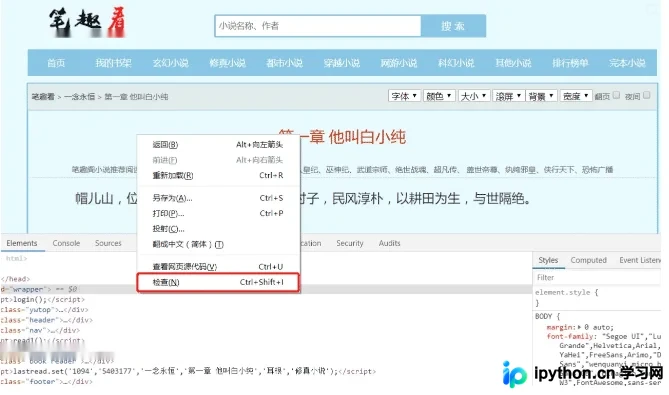
本文详解如何利用Python的requests库获取网页数据,结合BeautifulSoup解析HTML结构,提取One推送的文字与图片链接。通过封装下载函数并遍历DOM节点,实现自动化获取每日图文内容并保存至本地,为Python网络爬虫初学者提供完整代码示例与操作参考。
本文详细介绍如何利用Python3标准库urllib结合BeautifulSoup解析HTML,实现自动投票功能。通过获取Cookie、解析动态验证码并提交POST请求,完成投票逻辑。代码包含完整的请求头设置与数据封装示例,适用于需要批量处理投票场景的开发参考。
本文详细解析如何使用Python的requests库进行网页请求,结合BeautifulSoup解析HTML结构,从图灵网抓取图书列表并提取详情页链接。文章通过具体代码示例,演示了如何从列表页解析链接,并从详情页提取书名、定价及电子书价格等关键信息,提供了完整的爬虫实现思路与代码片段。
本文详细介绍如何使用Python结合BeautifulSoup4库爬取名言网top10标签下的名言数据,并将包含名言、作者及标签的信息存储至MySQL数据库。代码涵盖网页解析、分页处理及数据库插入操作,适合Python初学者参考学习。
本文介绍如何使用Python的Beautiful库解析HTML字符串,重点演示通过textarea标签定位内容,并利用get_text()方法清除所有HTML标签,从而高效提取纯净文本数据。
本文提供基于Python的电影下载链接爬虫实现方案。利用urllib2发起请求,结合BeautifulSoup解析HTML结构,提取电影标题及下载URL。代码包含分页处理、文件写入及编码转换逻辑,适用于学习Python网络爬虫基础与网页数据提取技术。
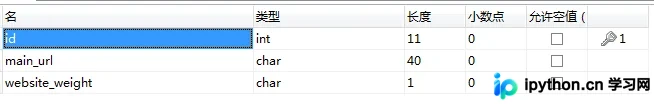
本文详细解析如何使用Python3批量查询网站百度权重。通过openpyxl读取Excel中的网址列表,利用Requests伪造请求获取seo.chinaz.com页面,并用BeautifulSoup提取权重数据。最终将结果写入MySQL数据库及Excel文件,提供完整的代码逻辑与配置说明。
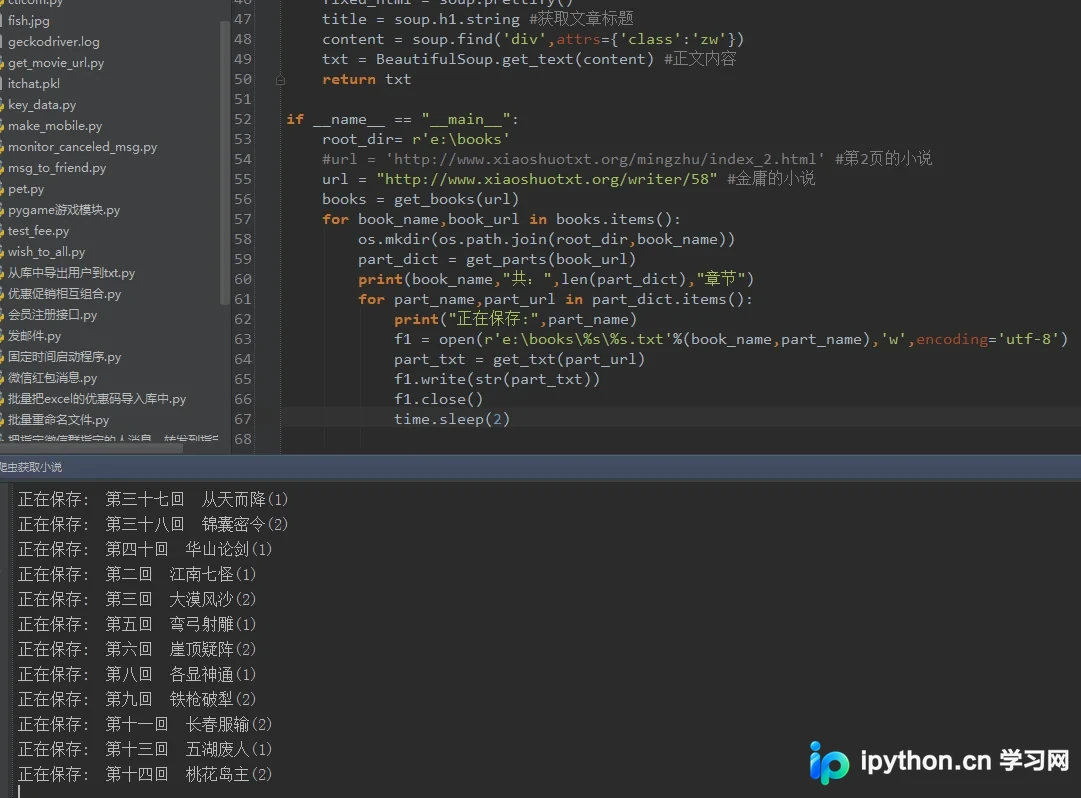
本文提供基于Python的完整爬虫示例,演示如何自动抓取金庸小说全集。通过BeautifulSoup解析网页结构,遍历章节列表并逐章下载保存为本地文本文件。代码包含URL请求、HTML解析及文件写入逻辑,适合Python初学者学习网络数据采集与文件处理实战。
本文分析Python BeautifulSoup库中常见的TypeError: list indices must be integers or slices, not str错误。该错误源于混淆了find/select与find_all/select的返回值类型。通过对比Tag与ResultSet/List的区别,并提供索引取值和改用select_one两种解决方案,帮助开发者快速定位并修复代码。