

Python爬虫网页解析的4种主流方式:原理、代码与对比

本文详细解析Python中解析HTML网页的四种主流方式:正则表达式、requests-html、BeautifulSoup及lxml XPath。通过豆瓣小组页面抓取实例,对比各库在代码复杂度、执行效率及适用场景上的差异,帮助开发者根据实际需求选择最高效的数据提取工具。
Python网页解析概述
本文深入探讨Python爬虫中解析网页内容的四种核心方法,并结合具体实例剖析其工作原理。文中提供的示例代码详尽清晰,旨在为从事数据分析或自动化抓取工作的开发者提供具有实际参考价值的技术指南。
在当前技术环境下,使用Python编写爬虫程序已成为获取互联网数据的基础技能。无论是为了后续的数据分析还是其他自动化处理需求,编写程序从互联网抓取资料已成为广泛应用的实践。
爬虫的基本原理是将目标网址的页面内容下载至内存,此时获取到的原始数据为HTML格式。随后,程序需对这段HTML字符串进行解析,依据预设逻辑提取出所需的关键数据。本文将重点介绍Python中处理HTML内容的四种解析方案,它们各具特色,适用于不同的应用场景。
为了演示解析过程,我们选取一个典型的网站作为目标。考虑到Python生态的广泛性,这里选择豆瓣网站作为示例对象,因其技术栈与Python紧密相关,适合用于教学演示。
具体目标页面选定为豆瓣的Python爬虫小组主页,其页面结构如下所示。
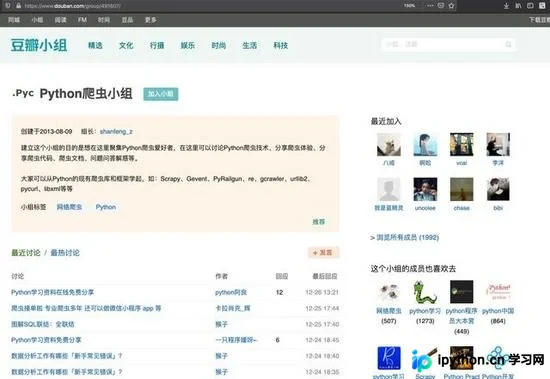
借助浏览器开发者工具检查HTML源码,我们可以定位到需要提取的具体数据区域。本例的目标是抓取该讨论组内所有帖子的标题及其对应的链接地址。
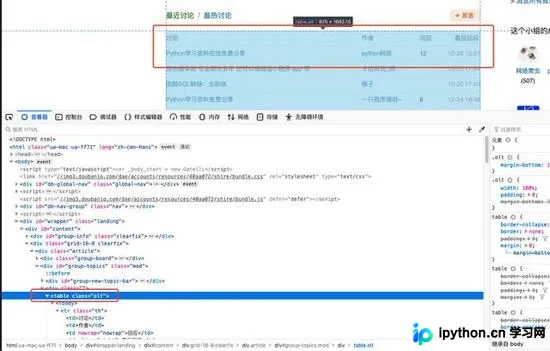
经过源码分析,目标数据集中分布在特定的HTML标签区域内。因此,解析的核心任务即是从整个HTML文档中精准定位并提取该区域内的内容。
示例目标:豆瓣小组页面
接下来开始编写具体的解析代码。
方法一:正则表达式解析
第一种方法:正则表达式(Regular Expression)
正则表达式主要用于检索和替换符合特定模式的文本。利用这一特性,我们可以通过定义复杂的匹配规则来提取目标信息。
具体实现参考以下代码逻辑。
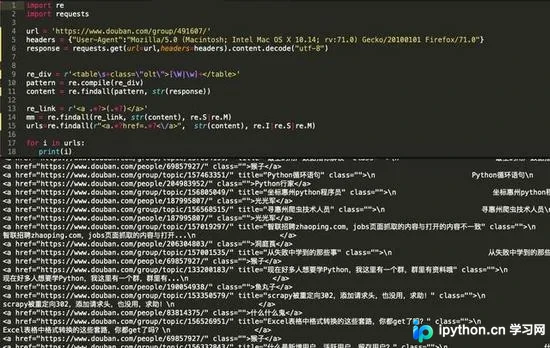
在代码的第6行和第7行,必须手动设置请求头(header)中的User-Agent字段,以模拟浏览器行为。若不进行此设置,豆瓣服务器可能会识别出非正常请求并返回HTTP 418错误。
在第7行,代码直接使用requests库的get方法发起网络请求。获取响应后,需进行编码格式转换。这同样源于豆瓣页面的渲染机制,通常情况下,直接获取requests返回的content内容即可满足需求。
以下是Python模拟浏览器发起请求并解析内容的完整代码示例:
rl = 'https://www.douban.com/group/491607/'headers = {"User-Agent":"Mozilla/5.0 (Macintosh; Intel Mac OS X 10.14; rv:71.0) Gecko/20100101 Firefox/71.0"}response = requests.get(url=url,headers=headers).content.decode('utf-8') 正则表达式的优势在于匹配效率极高,但其缺点也不容忽视:编写难度大、逻辑复杂且难以理解。鉴于当前已有众多成熟的HTML解析库,个人并不推荐在常规场景下手动使用正则表达式进行内容匹配,因为这往往费时费力且复用性低。
正则解析的核心代码片段如下:
re_div = r'<table\s+class=\"olt\">[\W|\w]+</table>'pattern = re.compile(re_div)content = re.findall(pattern, str(response))re_link = r'<a .*?>(.*?)</a>'mm = re.findall(re_link, str(content), re.S|re.M)urls=re.findall(r"<a.*?href=.*?<\/a>", str(content), re.I|re.S|re.M) 方法二:requests-html库
第二种方法:requests-html库
这是作者个人较为推崇的库。该库由requests库的作者、知名程序员Kenneth Reitz开发,他在requests的基础上扩展了对HTML内容的解析功能,从而形成了requests-html这一独立库。
具体的应用范例如下所示。
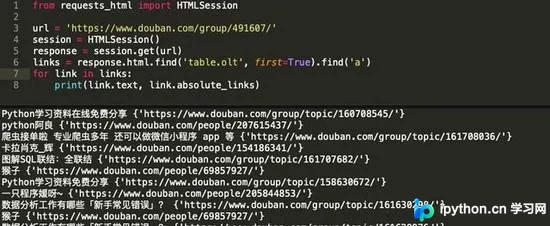
作者倾向于使用requests-html的原因在于其高度封装的特性。该库自动处理了请求返回内容的编码转换等繁琐细节,使得代码逻辑更加简洁直观,让开发者能够专注于核心的解析逻辑本身。
requests-html解析内容的核心代码:
links = response.html.find('table.olt', first=True).find('a') 安装命令:pip install requests-html
方法三:BeautifulSoup解析
第三种方法:BeautifulSoup库
作为Python HTML解析领域历史悠久的重量级库,BeautifulSoup功能全面但相对臃肿。其“重量”主要体现在功能大而全,适合处理复杂的文档结构。
首先查看其代码实现。
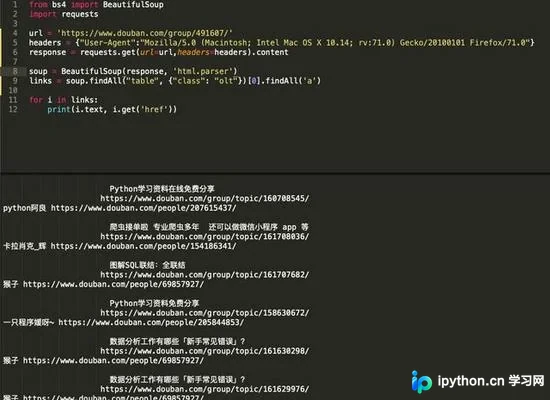
soup = BeautifulSoup(response, 'html.parser')links = soup.findAll("table", {"class": "olt"})[0].findAll('a') 使用BeautifulSoup进行解析时,同样需要将网络请求与数据解析步骤分离。从代码可读性角度来看,其表现尚可,但在处理复杂解析逻辑时,代码结构可能显得较为繁琐。总体而言,该库可用性强,具体使用取决于个人偏好。
安装命令:pip install beautifulsoup4
方法四:lxml与XPath
第四种方法:lxml库与XPath
lxml库同时支持HTML和XML格式的解析,并原生支持XPath查询语法。其解析效率较高,但要求使用者熟悉其特定的语法规则,例如常见的XPath表达式结构。
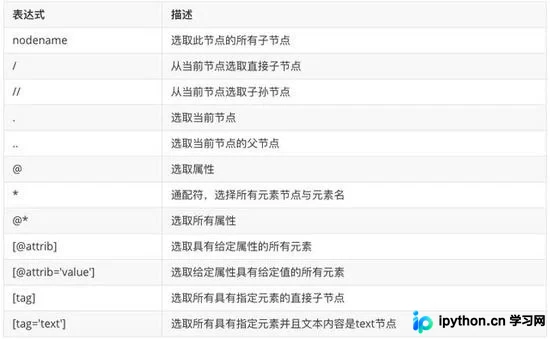
以下是利用XPath进行内容解析的具体示例。
lxml解析的核心代码:
content = doc.xpath("//table[@class='olt']/tr/td/a") 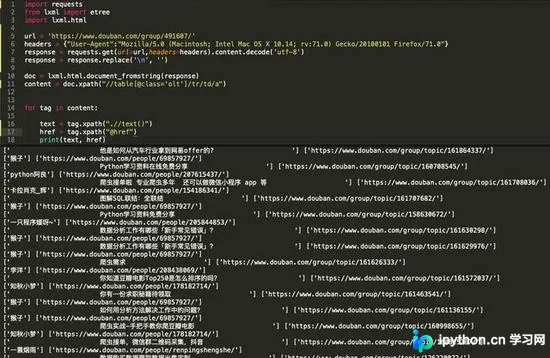
虽然XPath的语法相对复杂,但一旦熟练掌握,它便成为一种高效的解析手段。
安装命令:pip install lxml
四种方式对比总结
四种解析方式的总结与对比
正则表达式匹配方式不推荐用于生产环境,因为现有成熟的库已能直接处理解析任务,无需开发者手动编写大量难以维护的正则表达式,且正则表达式难以复用,此处仅作知识补充。
BeautifulSoup基于DOM(文档对象模型)机制工作。简而言之,它在解析过程中会将整个网页内容加载到内存中的DOM树里,因此内存开销较大且耗时较多。在处理海量数据时不建议使用。然而,BeautifulSoup的优势在于对HTML结构的要求较低,即使网页结构不清晰,它也能通过find方法直接定位到目标标签,因此适合处理结构混乱的网页。
XPath基于SAX(简单API for XML)的事件驱动机制进行解析。与BeautifulSoup不同,它不会将整个网页内容加载到DOM树中,而是逐行扫描事件,因此更加轻量级。但XPath要求网页结构相对清晰,且开发难度略高于DOM解析方式。在追求解析效率的场景下,推荐使用XPath。
requests-html是一个较新的库,其源码清晰且封装程度高。它整合了大量繁琐的解析操作,同时支持DOM解析和XPath解析两种方式,兼具灵活性与便利性,是目前作者使用频率较高的库之一。
除上述几种主流方式外,Python中还存在其他网页内容解析手段,此处不再逐一赘述。
开发爬虫的核心在于两点:如何高效抓取数据,以及如何准确解析数据。开发者应活学活用,根据具体场景选择最合适的工具以达成目标。
以上就是本文的全部内容,希望能为读者的学习和工作带来帮助,欢迎继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









