Python使用requests库爬取返回空值的解决方案
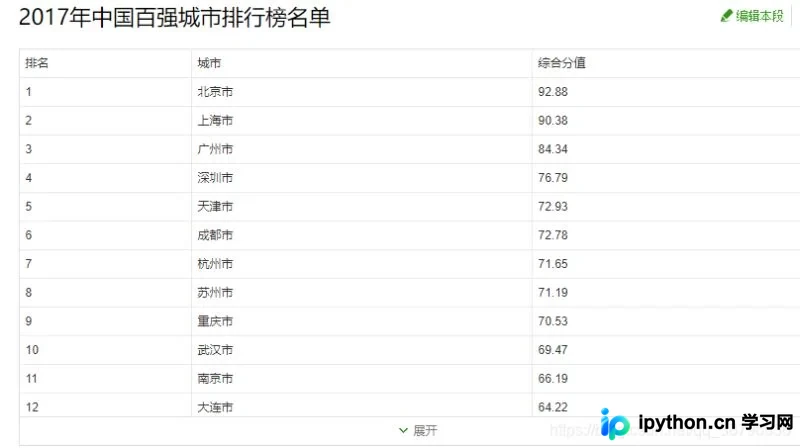
本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
2026-10-14
4


本文详解Python使用requests库爬取网页时返回空内容的常见原因及解决方法。通过修改User-Agent和Cookie模拟浏览器请求,成功绕过360搜索的反爬限制,并结合BeautifulSoup库提取表格数据,完整展示从请求到数据提取的全过程。
本文介绍使用Python编写爬虫程序,通过BeautifulSoup解析网页获取视频URL,并利用迅雷COM接口实现自动批量下载的方法。代码包含获取最新网址、分页处理、URL提取及调用迅雷一键下载功能,适合需要自动化视频采集场景的开发者参考。
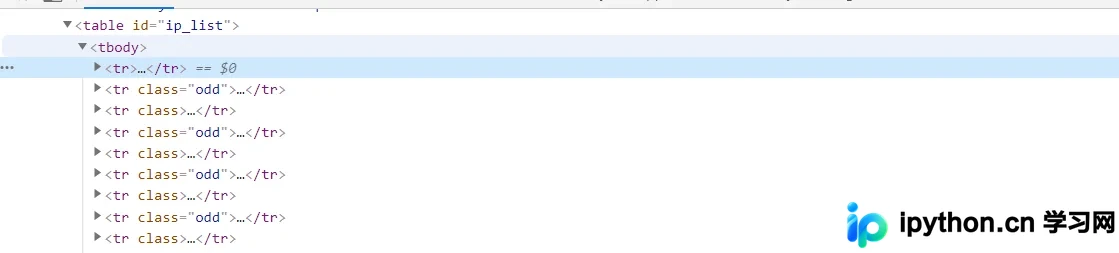
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
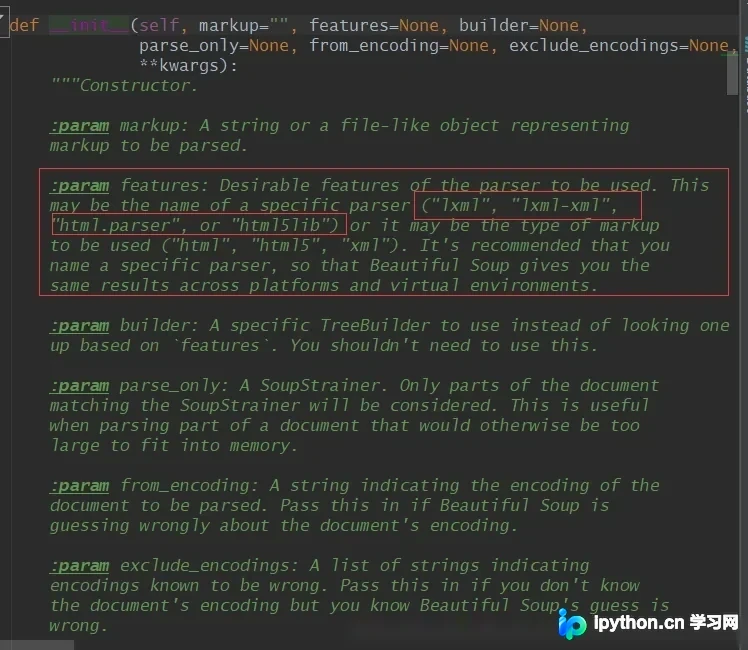
本文详细介绍Python中BeautifulSoup库的核心查找方法find和find_all。通过构建实例、解析HTML结构,演示如何精准定位标签、提取文本与属性。重点讲解处理class关键字冲突的技巧,以及find_all在批量提取数据时的灵活应用,帮助开发者高效完成网页数据抓取任务。
本文详解在Python爬虫中获取指定class样式的div标签的三种方法。对比字符串查找与正则表达式的局限性,重点介绍BeautifulSoup库的使用技巧。通过字典形式赋值attrs参数解决官方文档示例无效的问题,并提供完整代码示例及图片下载实战,帮助开发者高效准确提取网页数据。
本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
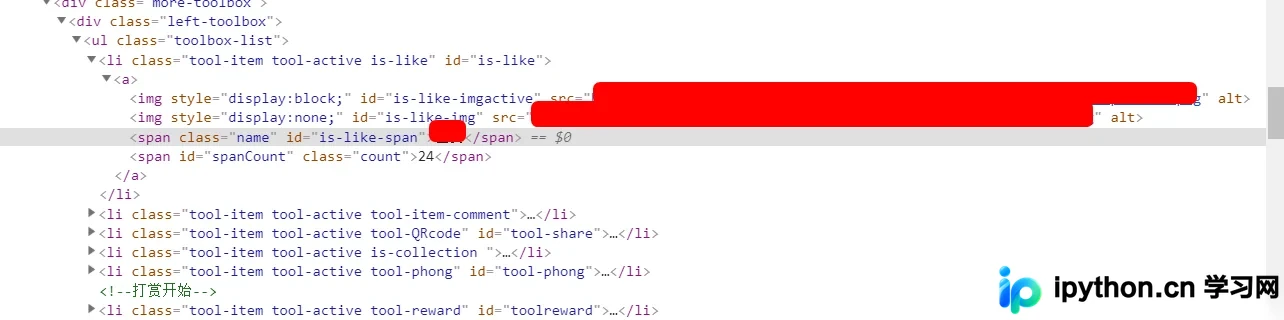
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
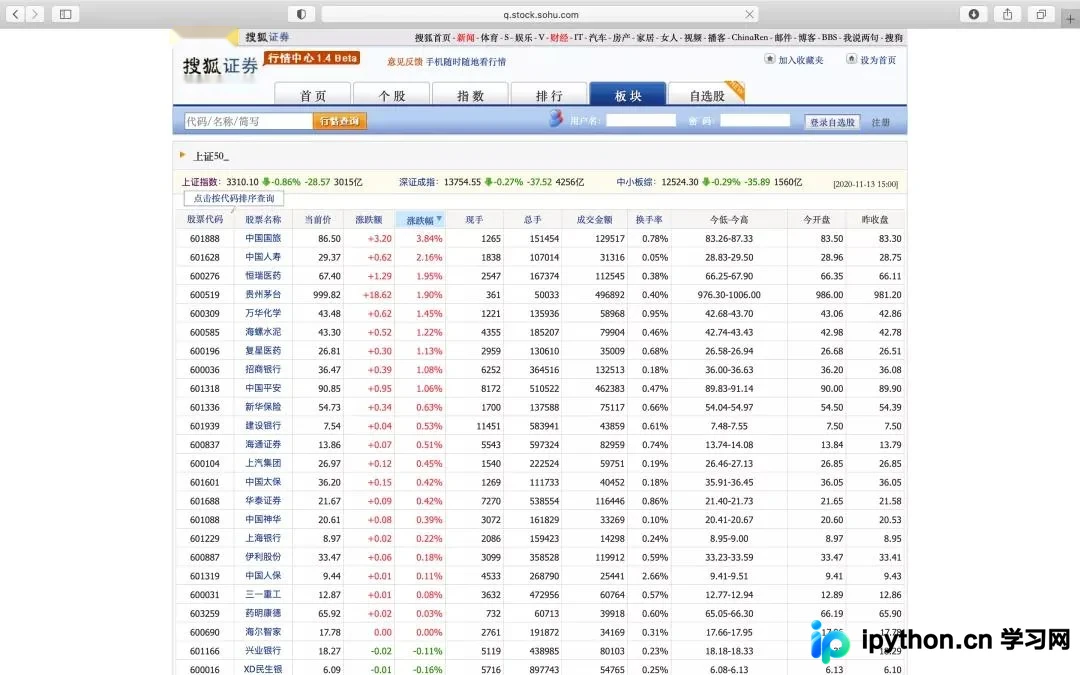
本文详解如何使用Python的requests和BeautifulSoup库,从搜狐证券网站抓取上证50成分股的股票代码。教程涵盖网页请求、编码处理(gb2312)、HTML表格解析及数据清洗,并将结果保存为pickle格式以便后续高效调用,适合金融数据抓取初学者参考。
本文提供基于Python 2的模拟登录与跳转示例。通过urllib2和cookielib管理Cookie,利用BeautifulSoup解析响应。代码展示了如何构建登录请求、处理验证码字段,并在登录成功后获取跳转页面的标题。注意代码依赖Python 2环境,urllib2在Python 3中已移除,实际使用时需进行相应适配。
本文详细解析使用Python爬取豆瓣电影Top250数据的完整流程。通过结合urllib获取网页、BeautifulSoup解析DOM以及正则表达式提取关键信息,实现了电影链接、标题、评分等数据的自动化采集,并将结果保存至Excel文件。
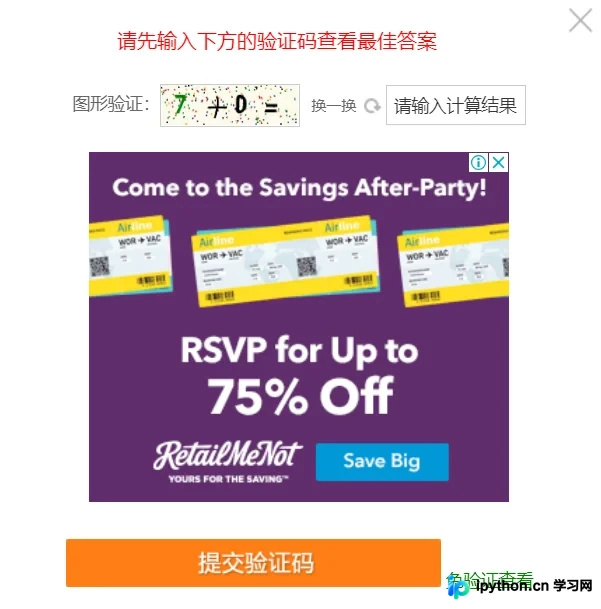
本文介绍如何使用Python脚本绕过上学吧网站的验证码限制,自动获取题目详情与答案。通过构造随机X-Forwarded-For头信息规避IP检测,结合requests和BeautifulSoup库下载并解析验证码图片,用户只需手动输入计算结果即可实现免验证跳转查看内容。
本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。