

Python多线程爬取西刺代理的完整实现与格式转换

发布时间:2026-10-14| 6人浏览过
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
西刺代理爬虫背景与资源
西刺代理曾是国内知名的IP代理服务,鉴于该服务已停止运营,此处分享原有的代码片段,供开发者参考学习。
访问镜像地址:https://www.blib.cn/url/xcdl.html
HTML数据解析逻辑
解析过程首先定位页面中所有的tr标签,并筛选出class属性包含odd的标签进行后续处理。
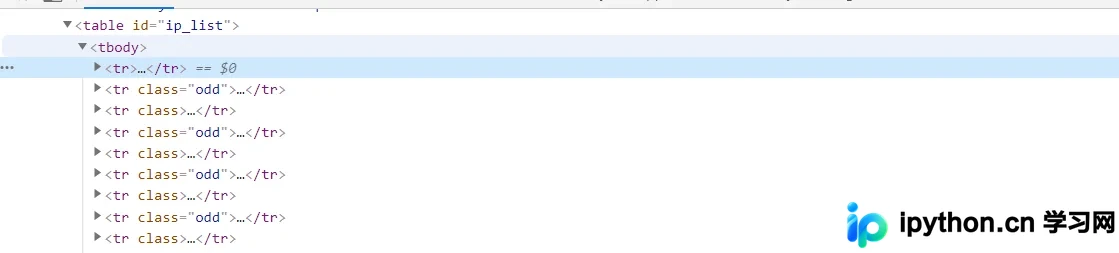
接着遍历每个tr标签内的td子标签,仅提取索引为1、2、5、9的四个位置的数据,忽略其他无关字段。
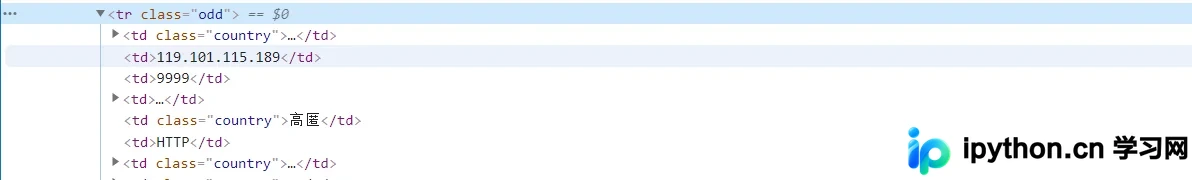
基于上述逻辑编写单页提取代码,并将提取结果保存至本地文件。
单页抓取与数据保存实现
import sys,re,threading
import requests,lxml
from queue import Queue
import argparse
from bs4 import BeautifulSoup

head = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.100 Safari/537.36"}

if __name__ == "__main__":
  ip_list=[]
  fp = open("SpiderAddr.json","a+",encoding="utf-8")
  url = "https://www.blib.cn/url/xcdl.html"
  request = requests.get(url=url,headers=head)
  soup = BeautifulSoup(request.content,"lxml")
  data = soup.find_all(name="tr",attrs={"class": re.compile("|[^odd]")})
  for item in data:
    soup_proxy = BeautifulSoup(str(item),"lxml")
    proxy_list = soup_proxy.find_all(name="td")
    for i in [1,2,5,9]:
      ip_list.append(proxy_list[i].string)
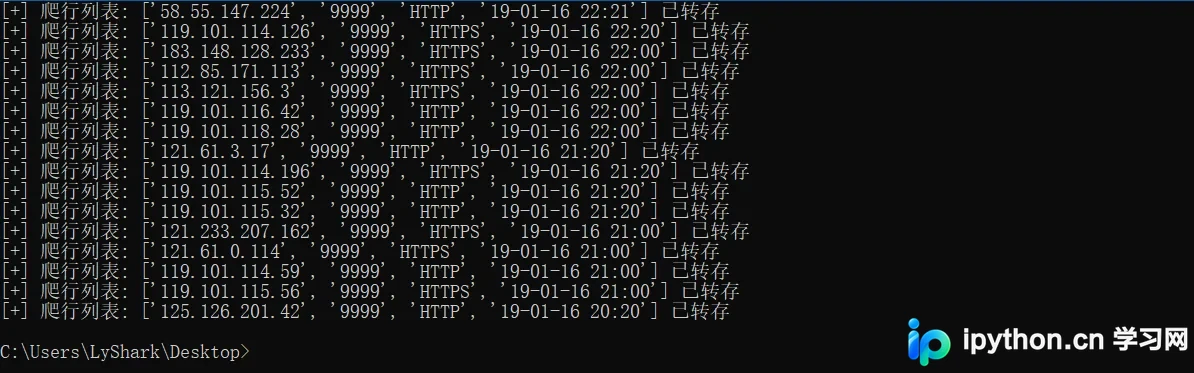
    print("[+] 爬行列表: {} 已转存".format(ip_list))
    fp.write(str(ip_list) + '\n')
    ip_list.clear()
爬取完成后,数据以SpiderAddr.json文件格式存储。
随后使用另一段代码将保存的数据转换为SSR代理工具可直接识别的格式,例如{'http': 'http://119.101.112.31:9999'}。
代理格式转换处理
import sys,re,threading
import requests,lxml
from queue import Queue
import argparse
from bs4 import BeautifulSoup

if __name__ == "__main__":
  result = []
  fp = open("SpiderAddr.json","r")
  data = fp.readlines()

  for item in data:
    dic = {}
    read_line = eval(item.replace("\n",""))
    Protocol = read_line[2].lower()
    if Protocol == "http":
      dic[Protocol] = "http://" + read_line[0] + ":" + read_line[1]
    else:
      dic[Protocol] = "https://" + read_line[0] + ":" + read_line[1]
    result.append(dic)
    print(result)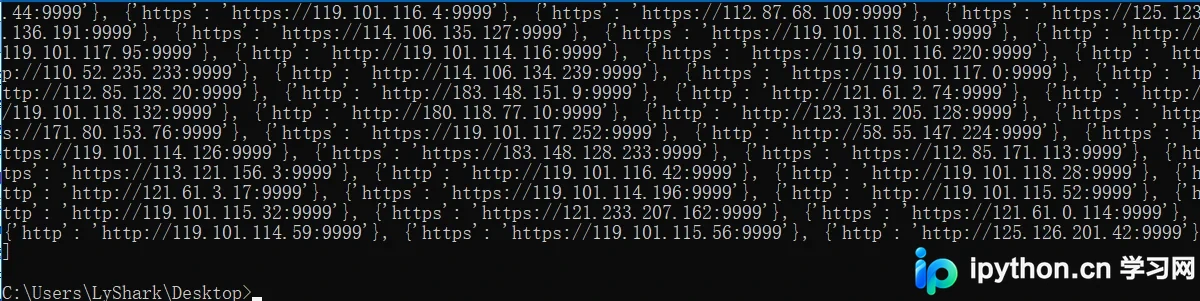
以下是完整的多线程版本代码实现。
多线程并发爬取完整代码
import sys,re,threading
import requests,lxml
from queue import Queue
import argparse
from bs4 import BeautifulSoup

head = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.100 Safari/537.36"}

class AgentSpider(threading.Thread):
  def __init__(self,queue):
    threading.Thread.__init__(self)
    self._queue = queue

  def run(self):
    ip_list=[]
    fp = open("SpiderAddr.json","a+",encoding="utf-8")
    while not self._queue.empty():
      url = self._queue.get()
      try:
        request = requests.get(url=url,headers=head)
        soup = BeautifulSoup(request.content,"lxml")
        data = soup.find_all(name="tr",attrs={"class": re.compile("|[^odd]")})
        for item in data:
          soup_proxy = BeautifulSoup(str(item),"lxml")
          proxy_list = soup_proxy.find_all(name="td")
          for i in [1,2,5,9]:
            ip_list.append(proxy_list[i].string)
          print("[+] 爬行列表: {} 已转存".format(ip_list))
          fp.write(str(ip_list) + '\n')
          ip_list.clear()
      except Exception:
        pass

def StartThread(count):
  queue = Queue()
  threads = []
  for item in range(1,int(count)+1):
    url = "https://www.xicidaili.com/nn/{}".format(item)
    queue.put(url)
    print("[+] 生成爬行链接 {}".format(url))

  for item in range(count):
    threads.append(AgentSpider(queue))
  for t in threads:
    t.start()
  for t in threads:
    t.join()

# 转换函数
def ConversionAgentIP(FileName):
  result = []
  fp = open(FileName,"r")
  data = fp.readlines()

  for item in data:
    dic = {}
    read_line = eval(item.replace("\n",""))
    Protocol = read_line[2].lower()
    if Protocol == "http":
      dic[Protocol] = "http://" + read_line[0] + ":" + read_line[1]
    else:
      dic[Protocol] = "https://" + read_line[0] + ":" + read_line[1]
    result.append(dic)
  return result

if __name__ == "__main__":
  parser = argparse.ArgumentParser()
  parser.add_argument("-p","--page",dest="page",help="指定爬行多少页")
  parser.add_argument("-f","--file",dest="file",help="将爬取到的结果转化为代理格式 SpiderAddr.json")
  args = parser.parse_args()
  if args.page:
    StartThread(int(args.page))
  elif args.file:
    dic = ConversionAgentIP(args.file)
    for item in dic:
      print(item)
  else:
    parser.print_help()
以上为Python多线程爬取西刺代理的示例详解,更多关于Python多线程代理抓取的资料,请参阅本站其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









