

Python与Hive UDF实现CSV批量MD5加密及常见陷阱解析
本文介绍使用Python脚本和Hive UDF两种方案对CSV文件中的手机号进行32位MD5批量加密,保障数据安全。重点解析Python中hashlib对象复用导致的连续加密错误陷阱,并提供正确的单次加密实现代码,适用于数据脱敏与安全导出场景。
2026-10-14
11

本文介绍使用Python脚本和Hive UDF两种方案对CSV文件中的手机号进行32位MD5批量加密,保障数据安全。重点解析Python中hashlib对象复用导致的连续加密错误陷阱,并提供正确的单次加密实现代码,适用于数据脱敏与安全导出场景。
本文详细讲解Python中MATLAB引擎库的安装与验证方法。不同于常规第三方库,该库安装方式特殊且需测试效果。文章提供了从环境配置到调用isprime函数的完整代码示例,帮助用户掌握Python与MATLAB交互的基础操作。
本文介绍使用Python和OpenCV库进行图像直线检测及角度计算的方法。通过HSV颜色空间转换、形态学处理及Canny边缘检测,利用HoughLinesP函数提取直线,并基于坐标计算其相对于水平线的倾斜角度。代码包含详细注释,适用于简单结构图像的直线识别场景。
本文介绍了如何使用Python内置的xml.etree.ElementTree库将XML文件转换为JSON格式。通过解析XML树结构,递归处理节点并构建字典或列表,最终利用json模块输出格式化JSON字符串。文章提供了完整的转换逻辑与代码示例,适用于需要处理XML数据并转换为JSON格式的开发场景。
本文详细介绍如何在 Python 中使用 Kazoo 库连接 ZooKeeper。内容涵盖安装、建立连接、创建(含临时与序列节点)、读取、更新及删除节点的具体代码示例,并解析关键参数如 ephemeral 和 sequence。此外,还讲解了如何利用 get 方法设置 watch 监听节点变化,帮助开发者快速掌握 ZooKeeper 的基础 API 使用。
本文详细介绍如何使用 Python 的 requests 模块实现网页图片的批量爬取与本地保存。通过解析网页 HTML 结构提取图片 URL,结合二进制流写入方式,将网络图片数据保存为 JPG 或 PNG 格式文件。文章包含从单图下载到批量处理的完整代码示例,涵盖 URL 拼接、文件命名及异常处理等关键步骤,适合初学者学习网络数据采集基础。
本文介绍如何使用 PyCharm Professional 版本在 Windows 或 Ubuntu 本地连接远程 Ubuntu 服务器。通过配置 SFTP 实现代码同步,并在 File 设置中添加远程 Python 解释器,指定 Conda 环境路径及映射关系,完成远程调试环境搭建。
本文介绍Python中高性能的lxml库,它基于C语言实现,支持HTML和XML数据的解析与提取。文章详细讲解了通过pip、PyCharm及官网三种方式安装lxml的方法,并演示了如何利用该库自动修复不规范HTML代码,以及通过字符串解析和文件读取两种方式提取数据的基本操作。
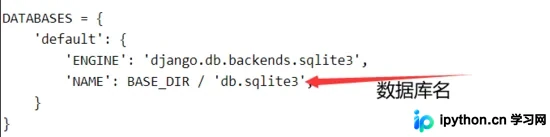
本文详解 Django 框架中 ORM(对象关系映射)的基本用法。通过定义 Python 类映射数据库表,利用 models.py 创建字段,并在 settings.py 中配置数据库连接。重点介绍如何使用 makemigrations 和 migrate 命令同步数据库结构,以及在 PyCharm 中查看和管理 SQLite 数据文件,帮助开发者快速掌握 Django 数据持久化核心流程。
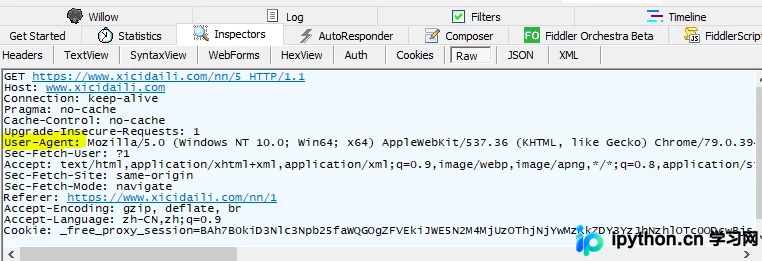
本文介绍使用Python爬取免费代理IP网站数据并生成JSON文件的方法。通过lxml模块提取IP和端口,利用requests库向百度发起请求以验证代理可用性,并将有效IP及耗时写入文件。代码包含分页抓取、延时处理及异常捕获,旨在为小型爬虫项目提供低成本的动态IP解决方案。
本文探讨Python中判断文件是否被占用的方法。首先指出os.access()仅返回读写属性,无法检测占用;其次验证try-except打开文件方式在Windows下无效。最终推荐依赖win32api模块的CreateFile函数,通过句柄值判断文件是否被其他进程锁定,并提供完整代码示例。
本文深入解析Python中类与对象的核心关系,通过生活化比喻与代码示例阐明概念。详细展示类的定义、实例化过程及变量方法调用机制,帮助开发者快速掌握面向对象编程基础,理解类作为模板与对象作为具体实例的区别与联系。