

Python 爬虫实现网页图片批量下载与本地保存

本文详细介绍如何使用 Python 的 requests 模块实现网页图片的批量爬取与本地保存。通过解析网页 HTML 结构提取图片 URL,结合二进制流写入方式,将网络图片数据保存为 JPG 或 PNG 格式文件。文章包含从单图下载到批量处理的完整代码示例,涵盖 URL 拼接、文件命名及异常处理等关键步骤,适合初学者学习网络数据采集基础。
图片爬取原理与单图下载实现
爬取图片与获取普通文本数据的原理基本一致,主要区别在于数据处理方式。普通数据通常直接返回字符串,而图片需要以二进制形式获取,并保存为特定的图像格式(如 .jpg、.png 等)文件。
以下提供一个示例 URL:https://img.ivsky.com/img/tupian/t/201008/05/bianxingjingang-001.jpg。将该链接复制到浏览器地址栏并访问,即可看到对应的图片内容。
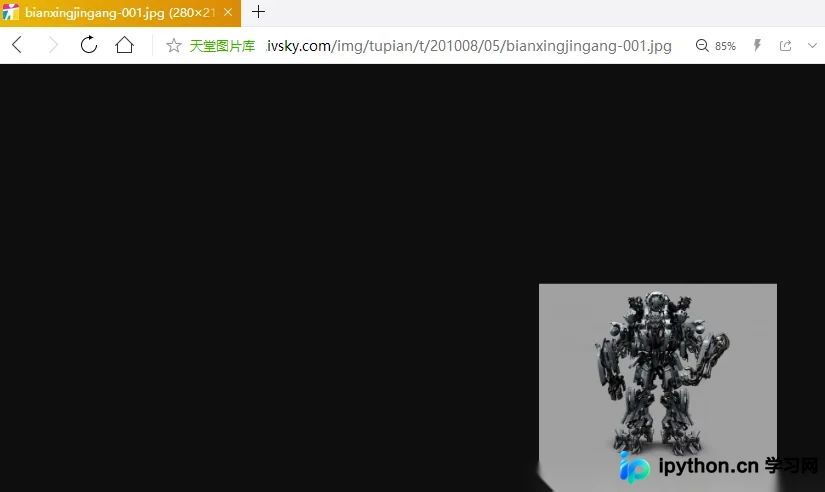
既然通过浏览器可以正常访问该图片,我们可以利用 Python 的 requests 模块发起请求。服务器会返回图片的二进制数据,我们只需将这部分数据写入本地文件即可完成下载,过程相对简单。
import requests
headers={
  'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
url='https://img.ivsky.com/img/tupian/t/201008/05/bianxingjingang-001.jpg'
re=requests.get(url,headers=headers)
print(re.status_code)#查看请求状态,返回200说明正常
path='test.jpg'#文件储存地址
with open(path, 'wb') as f:#把图片数据写入本地,wb表示二进制储存
      for chunk in re.iter_content(chunk_size=128):
        f.write(chunk)
执行上述操作后,将生成名为 test.jpg 的图片文件。

打开该文件即可查看,内容如下。
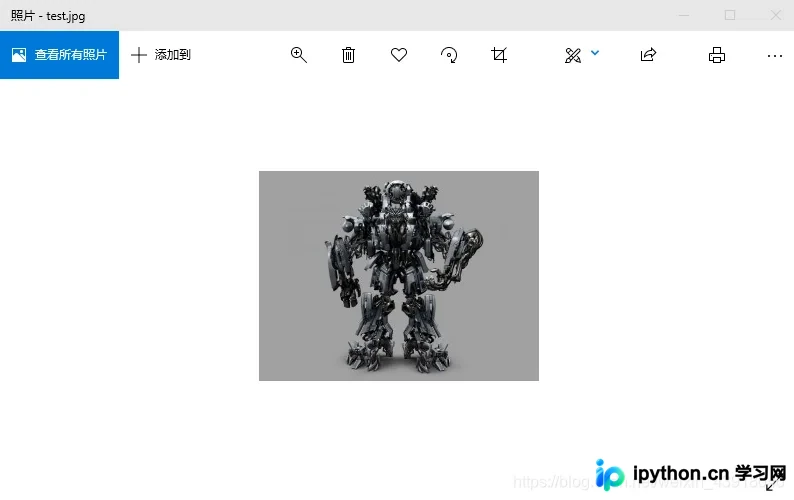
图片已成功下载,整个过程非常直观。
封装图片下载函数
接下来探讨批量下载的实现。我们将单图下载的逻辑封装为一个函数,针对每一张图片生成独立的文件名并发起请求,具体代码如下。
import requests
def get_pictures(url,path):
  headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
  re=requests.get(url,headers=headers)
  print(re.status_code)#查看请求状态,返回200说明正常
  with open(path, 'wb') as f:#把图片数据写入本地,wb表示二进制储存
        for chunk in re.iter_content(chunk_size=128):
          f.write(chunk)
url='https://img.ivsky.com/img/tupian/t/201008/05/bianxingjingang-001.jpg'
path='test.jpg'#文件储存地址
get_pictures(url,path)
批量获取图片 URL 与页面解析
要实现批量下载,首先需要获取页面中所有图片的 URL。为此,我们需要分析目标网页 https://www.ivsky.com/tupian/bianxingjingang_v622/ 的代码结构,页面展示效果如下。
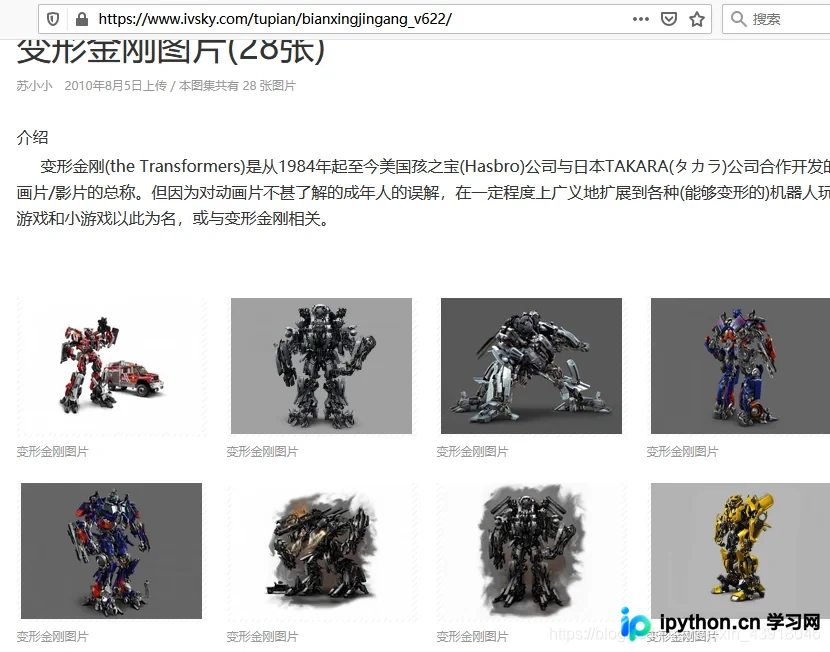
为了获取该页面中显示的所有图片链接,我们再次使用 requests 模块请求当前页面的 HTML 源码,代码如下。
import requests
headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
url='https://www.ivsky.com/tupian/bianxingjingang_v622/'
re=requests.get(url,headers=headers)
print(re.text)
运行代码后,返回的是当前页面的 HTML 结构文本。我们需要从中筛选出与图片相关的字符串,即包含 .jpg 或 .png 等后缀的链接片段,示例如下。

上述代码中高亮显示的 //img.ivsky.com/img/tupian/t/201008/05/bianxingjingang-017.jpg 即为图片路径。注意,这仅是相对路径,需要在前面拼接上 https: 前缀,从而构成完整的图片 URL,例如:https://img.ivsky.com/img/tupian/t/201008/05/bianxingjingang-017.jpg。
明确了数据结构后,我们可以编写一个简单的解析逻辑来提取这些 URL。
import requests
headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
url='https://www.ivsky.com/tupian/bianxingjingang_v622/'
re=requests.get(url,headers=headers)
def get_pictures_urls(text):
  st='img src="'
  m=len(st)
  i=0
  n=len(text)
  urls=[]#储存url
  while i<n:
    if text[i:i+m]==st:
      url=''
      for j in range(i+m,n):
        if text[j]=='"':
          i=j
          urls.append(url)
          break
        url+=text[j]
    i+=1
  return urls
urls=get_pictures_urls(re.text)
for url in urls:
  print(url)
运行上述解析代码,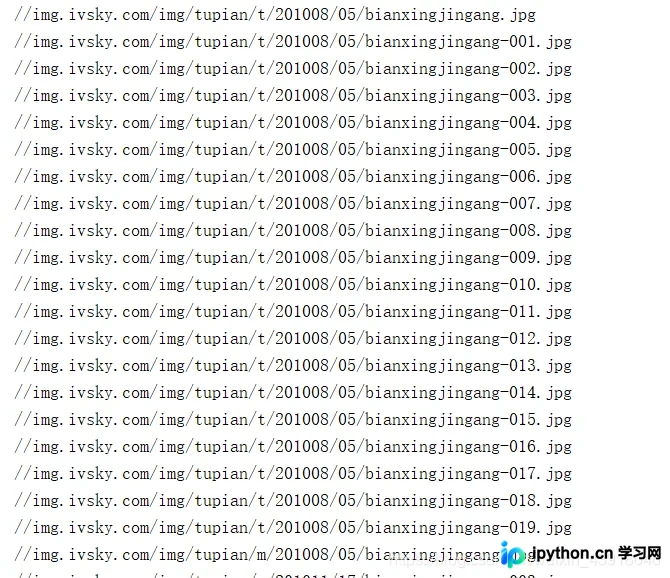 打印结果如下。
批量下载执行与结果验证
获取到图片 URL 列表后,直接将其传入之前定义的 get_pictures 函数中,即可开始批量爬取图片。
import requests
def get_pictures(url,path):
  headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
  re=requests.get(url,headers=headers)
  print(re.status_code)#查看请求状态,返回200说明正常
  with open(path, 'wb') as f:#把图片数据写入本地,wb表示二进制储存
        for chunk in re.iter_content(chunk_size=128):
          f.write(chunk)
def get_pictures_urls(text):
  st='img src="'
  m=len(st)
  i=0
  n=len(text)
  urls=[]#储存url
  while i<n:
    if text[i:i+m]==st:
      url=''
      for j in range(i+m,n):
        if text[j]=='"':
          i=j
          urls.append(url)
          break
        url+=text[j]
    i+=1
  return urls

headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.25 Safari/537.36 Core/1.70.3861.400 QQBrowser/10.7.4313.400'}
url='https://www.ivsky.com/tupian/bianxingjingang_v622/'
re=requests.get(url,headers=headers)
urls=get_pictures_urls(re.text)#获取当前页面所有图片的url
for i in range(len(urls)):#批量爬取图片
  url='https:'+urls[i]
  path='变形金刚'+str(i)+'.jpg'
  get_pictures(url,path)
最终运行结果如下。
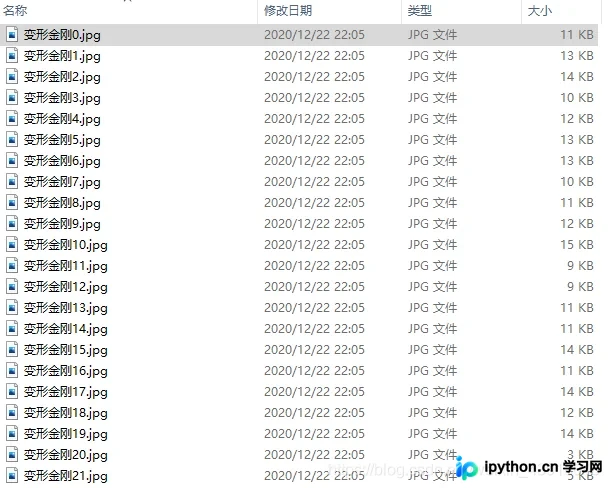
至此,批量下载过程完成。这里仅简要介绍了批量爬取图片的基本流程,实际应用中需针对不同网站的具体结构进行适配分析。本文尽可能详细地展示了从分析到实现的完整过程,希望能为你的学习提供参考。如有问题,欢迎指正。
关于 Python 爬虫批量下载网页图片并保存到本地的内容介绍至此。如需了解更多相关技术,请搜索本站历史文章或继续阅读后续教程。感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









