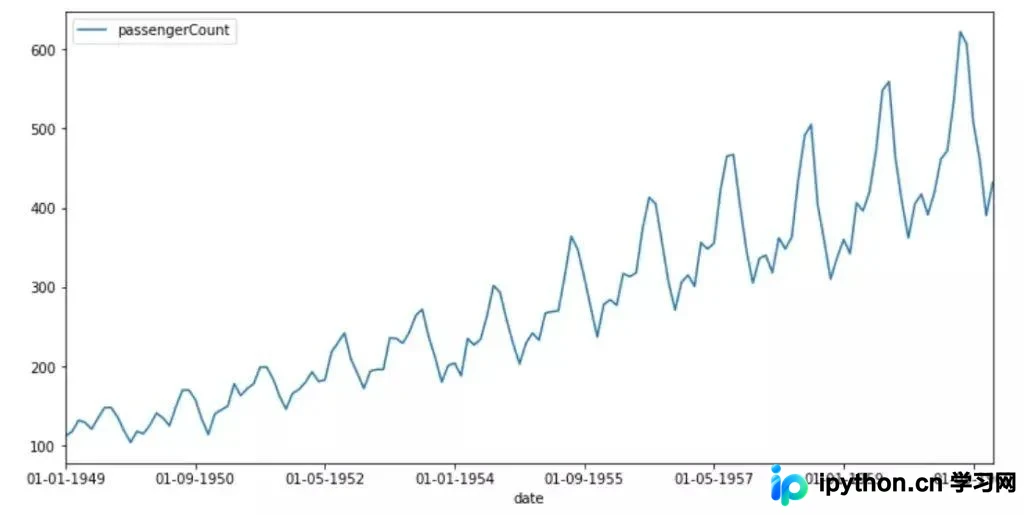
Python时间序列分析与预测:从分解到移动平均实战
本文深入解析Python中的时间序列预测技术。从基础概念入手,详解如何可视化AirPassengers数据,识别趋势、季节性与周期性要素。重点对比经典分解、X11与STL分解算法,并演示简单移动平均(SMA)、加权移动平均(WMA)及指数平滑(EMA/Holt)等预测模型的Python实现与代码应用。
2026-10-14
11

本文深入解析Python中的时间序列预测技术。从基础概念入手,详解如何可视化AirPassengers数据,识别趋势、季节性与周期性要素。重点对比经典分解、X11与STL分解算法,并演示简单移动平均(SMA)、加权移动平均(WMA)及指数平滑(EMA/Holt)等预测模型的Python实现与代码应用。
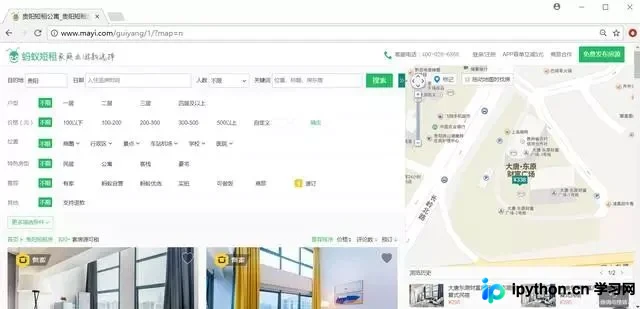
本文详细介绍如何使用Python爬虫应对网站反爬机制。针对蚂蚁短租的访问拦截,通过浏览器开发者工具获取Cookie和User-Agent,并在Python代码中通过urllib2设置Headers提交请求。结合BeautifulSoup解析HTML节点,成功获取贵阳地区短租房的名称、价格、评分及链接等详细信息,并存储为CSV文件。
本文详解Python中利用scipy.stats模块生成指定概率分布随机数的方法。重点讲解norm.rvs函数的loc和scale参数对期望与标准差的设定,以及size参数控制数组形状。通过具体代码实例展示如何生成正态分布等随机数,适用于统计分析场景。
本文详细解析Python模块中的内置属性,包括__doc__、__name__、__file__等常用属性及其作用。通过import导入方式、dir()方法获取属性列表以及具体代码实例,帮助开发者深入理解模块内部机制,掌握查看和使用内置属性的技巧。
本文详细介绍如何使用Python编写一个基于CSV文件的学生电子考勤系统。内容涵盖学生信息的加载、基于学号和密码的登录验证机制(含三次重试逻辑)、考勤数据的写入以及按姓名查询出勤记录的功能实现。通过解析main.py与stu_attendance.py两个核心文件,帮助开发者掌握基础的数据持久化与交互逻辑。
本文详细介绍Python3中利用openpyxl库进行Excel文件读写的方法。涵盖加载工作簿、遍历所有数据、按行读取、指定单元格读写以及写入新数据并保存文件的完整流程,适用于需要自动化处理Excel数据的开发场景。
本文介绍如何使用 Python 生成无限级分类的树状结构。通过递归算法处理数据库中的 parent 字段,构建层级关系。针对递归可能带来的性能问题,引入缓存机制优化执行效率,避免重复计算。文章包含完整代码示例及优化前后的逻辑对比,适用于权限管理、栏目分级等场景。
本文详细讲解使用Python爬取微博评论的完整流程。内容涵盖微博爬虫的难度分级、接口URL构造、HTML标签去除及正则表达式应用,并提供了基于requests和pandas的两种代码实例,帮助开发者掌握从确定用户ID到保存CSV文件的实际操作步骤。
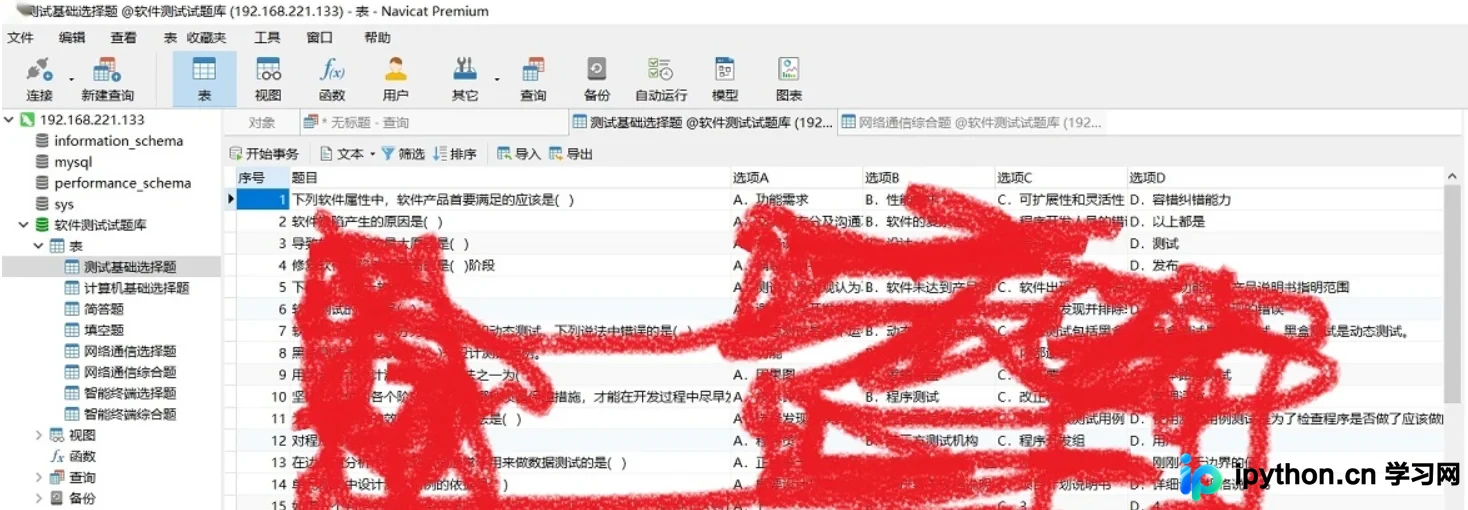
本文介绍如何使用Python连接MySQL数据库,从题库中随机抽取选择题、填空题等试题,并利用python-docx库自动生成包含答案的Word格式试卷。文章涵盖环境准备、数据库结构示例及完整核心代码,支持生成多份不重复的试卷。
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
本文详细介绍Numpy库中np.where函数的两种核心用法:带x,y参数的条件选择与仅带condition参数的坐标提取。通过一维及多维数组示例,解析其返回值机制及与np.searchsorted的区别,并补充奇偶数筛选案例,帮助开发者掌握Numpy数组搜索技巧。
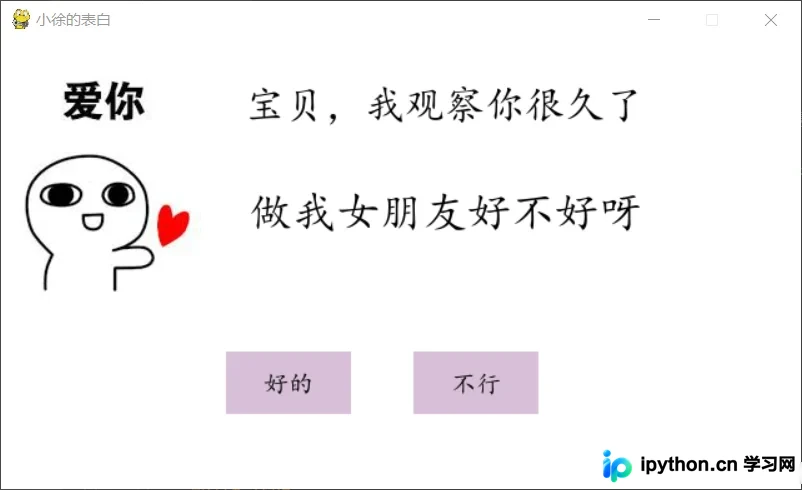
本文介绍使用Python和Pygame库开发的一款交互式表白程序。该程序通过图形界面实现点击交互,当用户尝试关闭或拒绝时,窗口无法退出并展示预设优点信息。文章提供了完整的代码结构说明及字体、图片素材的依赖配置指南,适合Python初学者了解GUI事件循环与窗口控制机制。