

Python集成学习入门:Bagging、Boosting与Stacking原理详解
系统解析Python机器学习中Bagging、Boosting与Stacking三大集成学习范式的核心原理、工作流程、偏差-方差权衡及scikit-learn工程实现代码。
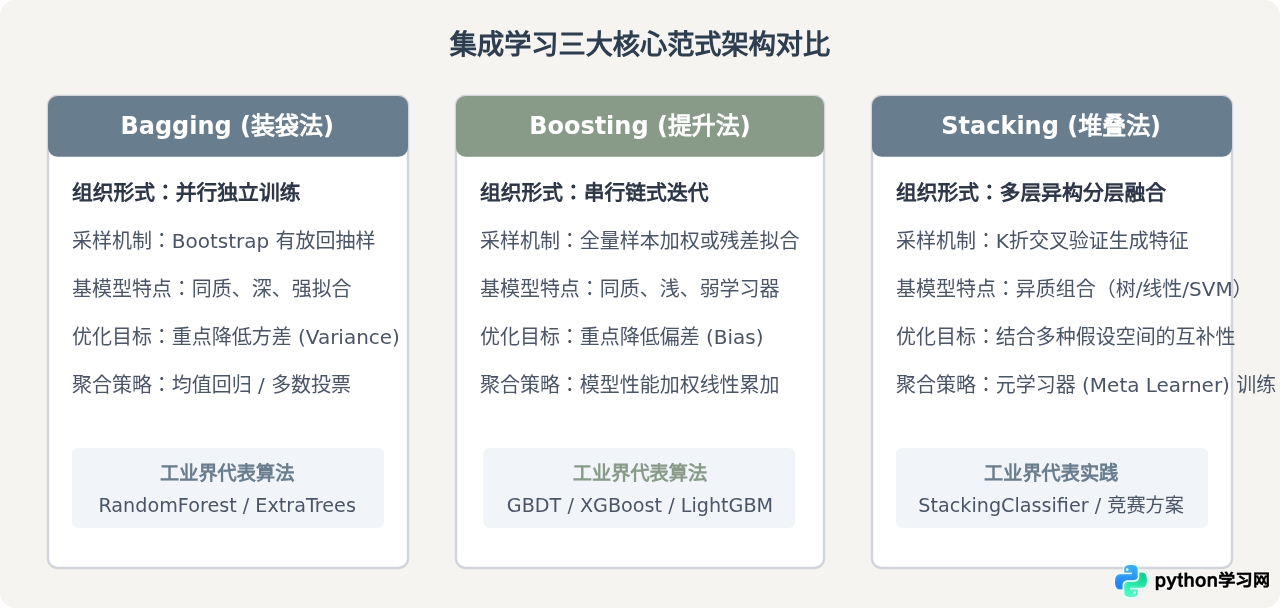
集成学习(Ensemble Learning)的核心思想是通过结合多个基学习器(Base Learners)的预测结果,构建一个泛化误差显著低于任何单一模型的强学习器。在经典机器学习实践中,集成方法按组织逻辑主要划分为三大阵营:基于独立自举采样的并行流派 Bagging、基于残差与权重迭代修正的串行流派 Boosting,以及基于多层元模型预测输出的分层融合流派 Stacking。本文将系统拆解这三者的数学假设、运行流程、偏差-方差优化目标,并结合 Python 的 scikit-learn 库提供完整可运行的代码实践与选型指南。
一、基石认知:偏差-方差分解与“好而不同”原则
理解集成学习的第一步,是明确机器学习泛化误差的来源。在统计学习理论中,模型的期望泛化误差可以严谨地分解为三部分:偏差(Bias)、方差(Variance)与不可约噪声(Noise)。
- 偏差:反映模型对真实数据规律的拟合能力。偏差高意味着欠拟合,即使给再多训练数据也抓不住真实特征。
- 方差:反映模型对训练集波动的敏感程度。方差高意味着过拟合,模型死记硬背了样本里的随机扰动,换一批数据测试精度便大幅崩塌。
集成学习并非盲目把多个模型绑在一起。数学证明表明,若要让集成系统的表现切实优于单模型,基学习器必须同时满足两个约束:准确性(好)与多样性(不同)。如果所有子模型犯错的位置完全相同,集成将毫无意义;只有当子模型在不同特征空间或不同样本子集上各有所长时,集成才能通过抵消独立误差来实现整体提升。
二、Bagging:自助抽样与方差削减机制
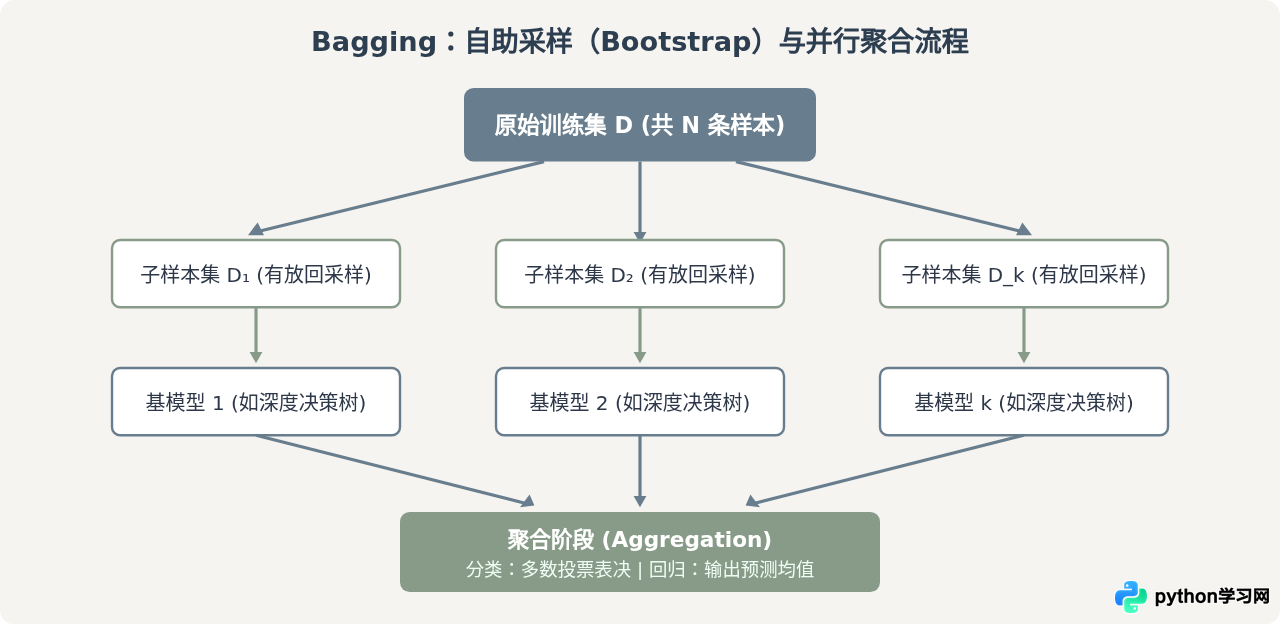
Bagging(Bootstrap Aggregating,装袋自举汇聚法)专为降低高方差模型的泛化波动而设计。其经典逻辑分为两步:
- 自举采样(Bootstrap Sampling):对包含 $N$ 个样本的数据集进行 $N$ 次有放回的随机抽取。在极限状态下,单个样本未被抽中的概率约为 $(1 - 1/N)^N \approx 1/e \approx 36.8\%$。这部分未被抽中的约 36.8% 样本称为包外数据(Out-Of-Bag, OOB),可作为天然的内置验证集。
- 并行汇聚(Aggregating):基于 $K$ 个互不相同的抽格子集分别独立训练 $K$ 个基学习器。在推理阶段,分类任务采用多数投票法(Majority Voting),回归任务采用算术平均法。
关键差异点:为什么 Bagging 需要“强且深”的基模型?
很多初学者误以为集成学习都应该使用弱分类器,这在 Bagging 中是完全相反的。数学上,若 $K$ 个基模型的方差为 $\sigma^2$,协方差为 $\rho \sigma^2$,则集成后的方差为 $\rho \sigma^2 + \frac{1-\rho}{K}\sigma^2$。Bagging 的目标是压制方差。因此,Bagging 的基模型必须本身具有很低的偏差(即拟合能力强,如不剪枝的深决策树),而通过 Bootstrap 抽样使得子模型彼此间尽量弱相关(降低 $\rho$),最终通过平均把方差大幅度打压下去。在实践中,随机森林(Random Forest)还在 Bagging 样本采样的基础上引入了“属性子集随机选择”,进一步降低了树与树之间的相关度。
Python 示例:Bagging 与随机森林实战
在 scikit-learn 中,可以使用 BaggingClassifier 自定义基分类器,或者直接使用高度优化的 RandomForestClassifier:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import BaggingClassifier, RandomForestClassifier
from sklearn.metrics import accuracy_score

# 1. 构造高维且具有噪声的二分类数据集
X, y = make_classification(
    n_samples=1500,
    n_features=25,
    n_informative=18,
    n_redundant=7,
    flip_y=0.08,
    random_state=42
)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)

# 2. 单棵未剪枝决策树(典型的高方差、容易过拟合基模型)
single_tree = DecisionTreeClassifier(max_depth=None, random_state=42)
single_tree.fit(X_train, y_train)
acc_tree = accuracy_score(y_test, single_tree.predict(X_test))

# 3. 经典 Bagging:包裹 100 棵深度决策树
bagging = BaggingClassifier(
    estimator=DecisionTreeClassifier(max_depth=None),
    n_estimators=100,
    max_samples=0.8,
    bootstrap=True,
    oob_score=True,
    n_jobs=-1,
    random_state=42
)
bagging.fit(X_train, y_train)
acc_bagging = accuracy_score(y_test, bagging.predict(X_test))

# 4. 随机森林:样本随机 + 特征分裂子集随机
rf = RandomForestClassifier(
    n_estimators=100,
    max_features="sqrt",
    oob_score=True,
    n_jobs=-1,
    random_state=42
)
rf.fit(X_train, y_train)
acc_rf = accuracy_score(y_test, rf.predict(X_test))

print(f"[示例评估结果]")
print(f"单棵决策树测试集准确率: {acc_tree:.4f}")
print(f"Bagging 集成准确率:   {acc_bagging:.4f} (OOB 分数: {bagging.oob_score_:.4f})")
print(f"随机森林集成准确率:   {acc_rf:.4f} (OOB 分数: {rf.oob_score_:.4f})")
三、Boosting:残差拟合与串行纠错机制
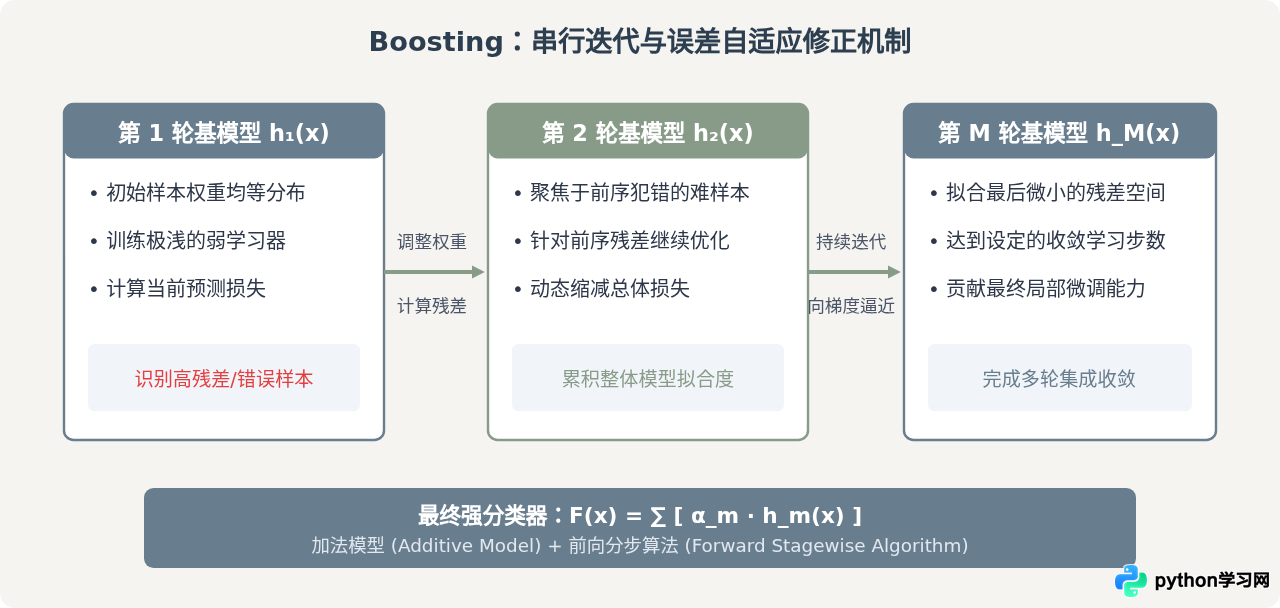
与 Bagging 的并行分散不同,Boosting(提升法)是一种以“串行反馈、步步纠偏”为核心的自适应策略。它的设计哲学是让后一个学习器专门学习前序学习器犯下的错误,其主要优化目标是持续降低模型的系统偏差(Bias)。
工业界主流的 Boosting 机制有两种典型演化:
- AdaBoost(自适应提升):重点改变样本权重。每一轮训练结束后,提高被错分样本的权重,降低正确分类样本的权重;最后依据分类准确率给每个模型分配投票权重 $\alpha_m$。
- Gradient Boosting(梯度提升树 GBDT):重点改变学习目标。每一轮新树不再拟合原真实标签 $y$,而是直接拟合当前集成模型关于损失函数的负梯度(伪残差,Pseudo-residuals),相当于在函数空间执行梯度下降。现代算法如 XGBoost、LightGBM 均是此原理的高度工程优化版。
Python 示例:梯度提升树实践
在实际生产中,推荐使用基于直方图分箱的高性能 HistGradientBoostingClassifier,它在大中型数据上的运算速度比传统 GBDT 快数倍:
from sklearn.ensemble import HistGradientBoostingClassifier, GradientBoostingClassifier
from sklearn.metrics import roc_auc_score

# 初始化基于直方图优化的梯度提升分类器
hgb = HistGradientBoostingClassifier(
    loss="log_loss",
    learning_rate=0.08,    # 学习率/步长:越小越平稳,但需配合更多迭代轮数
    max_iter=150,          # 最大串行迭代轮数(基树数量)
    max_leaf_nodes=31,     # 控制每棵弱树的叶子数,严格约束复杂度
    min_samples_leaf=20,   # 叶节点最小样本数,防止切分过度敏感
    early_stopping=True,   # 启用内置早停机制,验证集损失不再下降时自动终止
    random_state=42
)

hgb.fit(X_train, y_train)

# 预测测试集概率与准确率
y_pred_proba = hgb.predict_proba(X_test)[:, 1]
y_pred = hgb.predict(X_test)

auc = roc_auc_score(y_test, y_pred_proba)
acc = accuracy_score(y_test, y_pred)

print(f"[梯度提升模型评估]")
print(f"迭代实际轮数: {hgb.n_iter_}")
print(f"测试集 ROC-AUC 分数: {auc:.4f}")
print(f"测试集最终准确率:   {acc:.4f}")
四、Stacking:多层异构与交叉元学习机制
Bagging 与 Boosting 通常使用同质基学习器(如决策树)。而 Stacking(Stacked Generalization,堆叠泛化法)的核心假设在于:不同算法(如逻辑回归、SVM、KNN、随机森林、LightGBM)具有完全不同的归纳偏置(Inductive Bias)。通过分层结构,让第一层的多种异构基模型分别输出预测概率,再将这些预测概率作为“新特征”,交由第二层的元学习器(Meta Learner)完成最终决策。
初学者在手写 Stacking 时极易犯下严重错误:直接用全量训练集 $X_{train}$ 训练第一层模型,再拿这些模型预测 $X_{train}$ 输出元特征。这会导致元特征充满第一层模型的“记忆标签”,使元学习器发生灾难性的严重过拟合。解决这一问题的工业界标准方案是 K 折交叉 OOF 生成法:只有当第一层模型在未见过的折(Out-Of-Fold)上做出的预测,才能拼装为元特征矩阵。
Python 示例:Stacking 严谨实现
scikit-learn 的 StackingClassifier 已经在底层封装了严格的 K 折交叉验证 OOF 特征生成逻辑,确保不出现数据穿越:
from sklearn.ensemble import StackingClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier
from sklearn.svm import SVC

# 1. 定义第一层多样化异构基学习器 (Base Estimators)
# 选择算法逻辑差异极大的三类模型:近邻、树系、支持向量机
base_estimators = [
    ('rf', RandomForestClassifier(n_estimators=50, max_depth=6, random_state=42)),
    ('knn', KNeighborsClassifier(n_neighbors=7)),
    ('svc', SVC(probability=True, kernel='rbf', C=1.0, random_state=42))
]

# 2. 定义第二层元学习器 (Meta Learner)
# 元学习器应当采用高正则化、结构简单的线性分类器,避免二次过拟合
meta_learner = LogisticRegression(C=0.5, max_iter=500, random_state=42)

# 3. 组装 Stacking 模型
stacking = StackingClassifier(
    estimators=base_estimators,
    final_estimator=meta_learner,
    cv=5,                 # 核心:使用 5 折交叉验证严格生成 OOF 预测特征
    stack_method='predict_proba', # 将各基模型的输出概率向量作为二级特征
    passthrough=False,    # False 表示元分类器仅接收基模型概率,不混入原始特征
    n_jobs=-1
)

stacking.fit(X_train, y_train)
acc_stacking = accuracy_score(y_test, stacking.predict(X_test))

print(f"[Stacking 评估结果]")
print(f"5折异构堆叠最终测试集准确率: {acc_stacking:.4f}")
五、三大集成范式对比与工程选型决策
在面对具体的业务任务或竞赛场景时,该如何清晰地选择最适配的集成流派?我们先通过下表在一致的评估维度下审视其核心差异:
| 对比维度 | Bagging | Boosting | Stacking |
|---|---|---|---|
| 主要优化目标 | 显著降低方差 (Variance) | 显著降低偏差 (Bias) | 综合异构偏差与方差 |
| 基学习器要求 | 同质、强模型(深决策树) | 同质、弱模型(浅决策树桩) | 异质、多样化算法组合 |
| 模型相关性依赖 | 期望相关性越低越好 | 依赖前序模型误差反馈 | 依赖算法归纳偏置的多样性 |
| 训练计算并发度 | 天然支持全并行训练 | 强串行依赖,单树内部可微并行 | 基模型可并行,元模型需等待 |
| 调参复杂度 | 低(增加树数量通常不会恶化) | 高(需微调学习率、步数、正则项) | 极高(需分层调优及防泄露管理) |
| 抗噪声鲁棒性 | 较强(均值平均平滑异常) | 较弱(容易被标签噪声带偏) | 中等(取决于元分类器与基模型) |
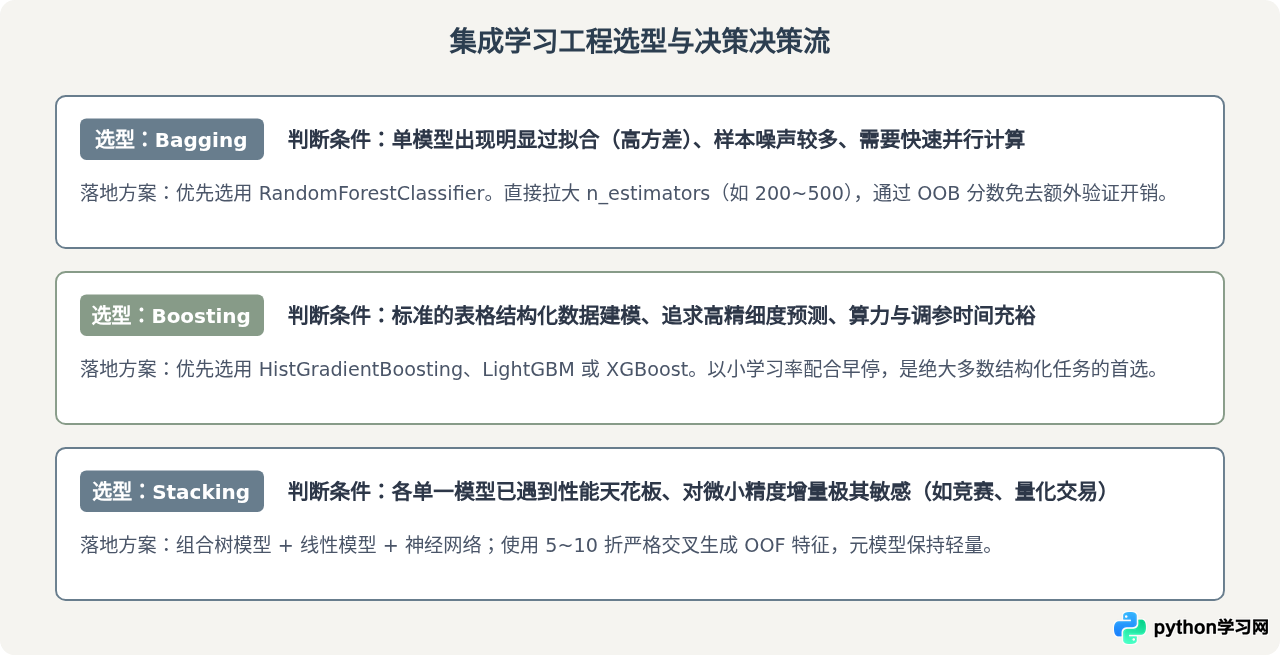
六、避坑与调优关键清单
- 警惕“盲目增加树的数量”:在 Bagging 中增加
n_estimators不会增加过拟合风险,但边际收益在 200 棵树后极快衰减;而在 Boosting 中,树的数量(迭代步数)与过拟合风险直接挂钩,绝不能无限增大,必须搭配early_stopping。 - 树模型的特征缩放误区:虽然树模型本身不需要特征归一化,但如果你在 Stacking 的第一层混入了 KNN、SVM 或线性回归,输入数据必须先通过
StandardScaler,否则距离敏感模型将完全失效,进而拉垮整个元学习器。 - 推理延迟的工程取舍:Stacking 虽然往往能刷出最高的分数,但在线上实时推理场景下,需要串行等待多个异构基模型依次出结果,内存占用和响应延迟极大。在对吞吐敏感的生产环境中,经过精调的轻量 Boosting 往往性价比更高。
通过掌握 Bagging 的方差消减逻辑、Boosting 的残差递进机制以及 Stacking 的多模型堆叠技术,开发者即可根据数据特性与业务约束,在 Python 中精准配置最具鲁棒性与竞争力的机器学习解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









