

Python字符串切片省略start或stop时的默认规则
深入解析Python字符串切片中省略start或stop参数时的默认规则,讲解正向与负向步长下的端点确定逻辑、底层slice.indices解析机制与常见避坑指南。
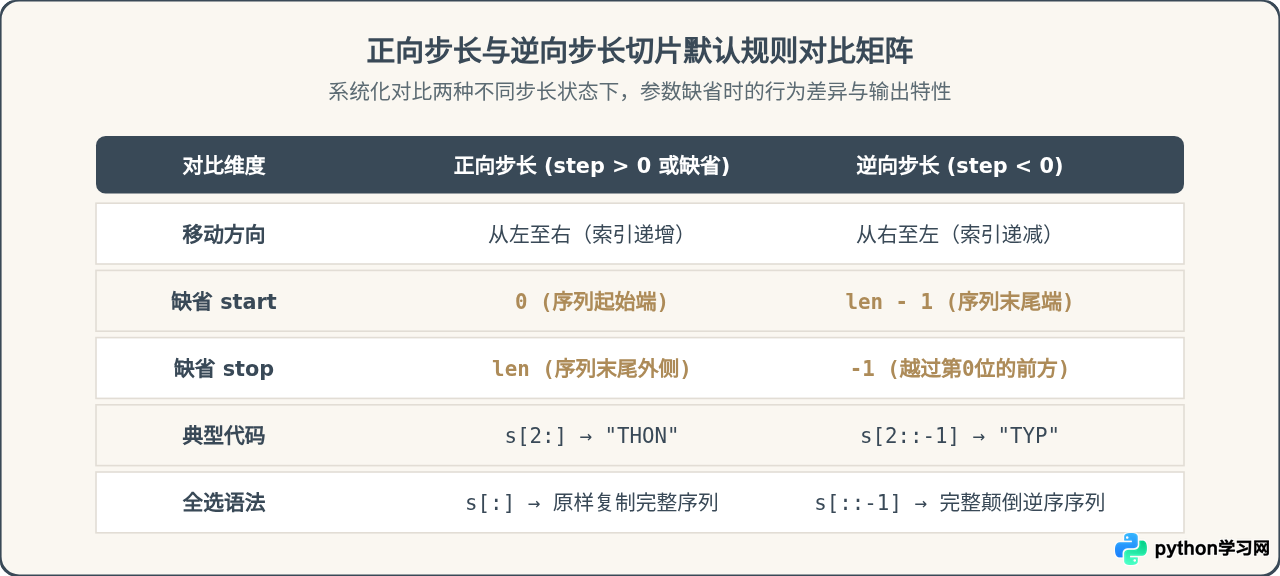
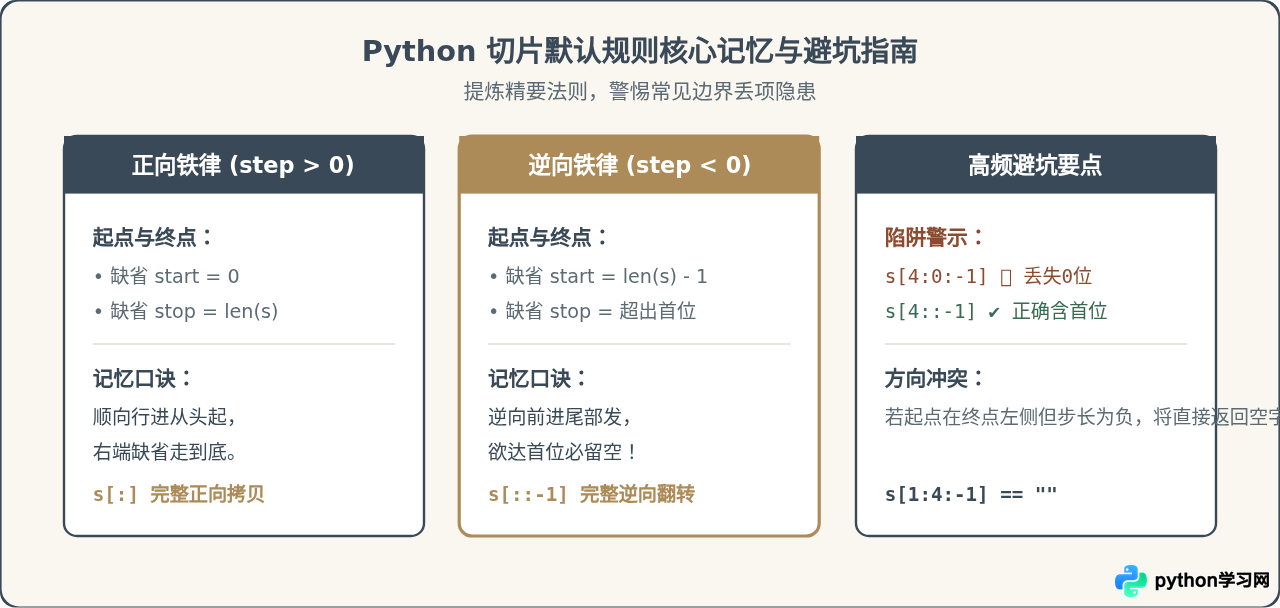
在 Python 中对字符串进行切片操作(形式为 s[start:stop:step])时,如果省略 start 或 stop,其默认值并非固定不变的常量。很多初学者常误以为“省略 start 一定是 0,省略 stop 一定是字符串末尾”,这一假设仅在步长为正数时成立。实际上,切片端点的缺省值完全取决于步长 step 的符号方向:当步长为正时,start 缺省为 0,stop 缺省为字符串长度;当步长为负时,start 缺省为最末尾字符的索引,而 stop 则缺省为越过字符串首字符的虚拟边界。本文将详细讲解这两套规则的判定机制、底层实现与常见避坑要点。
一、切片基础:边界坐标与正向默认规则
Python 切片遵循“左闭右开”原则,即截取区间包含 start 处的元素,但不包含 stop 处的元素。直观地理解,切片的索引位置实际上落在字符之间的缝隙(即切片边界)上,而不是单独指向某个字符。
当 step 被省略或指定为正整数时(最常见的情况是 step=1),遍历方向是从左至右递增:
- 省略 start 时:默认从序列的最左端开始,即
start = 0。 - 省略 stop 时:默认截取到序列的最右端,包含最后一个字符,即
stop = len(s)。 - 两者同时省略时:形如
s[:],表示完整截取整个字符串的浅拷贝。
# 环境:Python 3.8+
text = "PYTHON"

# 1. 省略 start:默认从 0 开始,截取到索引 3 之前
print(text[:3])    # 输出: PYT

# 2. 省略 stop:从索引 2 开始,默认截取到末尾(包含第 5 个字符)
print(text[2:])    # 输出: THON

# 3. 同时省略 start 与 stop
print(text[:])     # 输出: PYTHON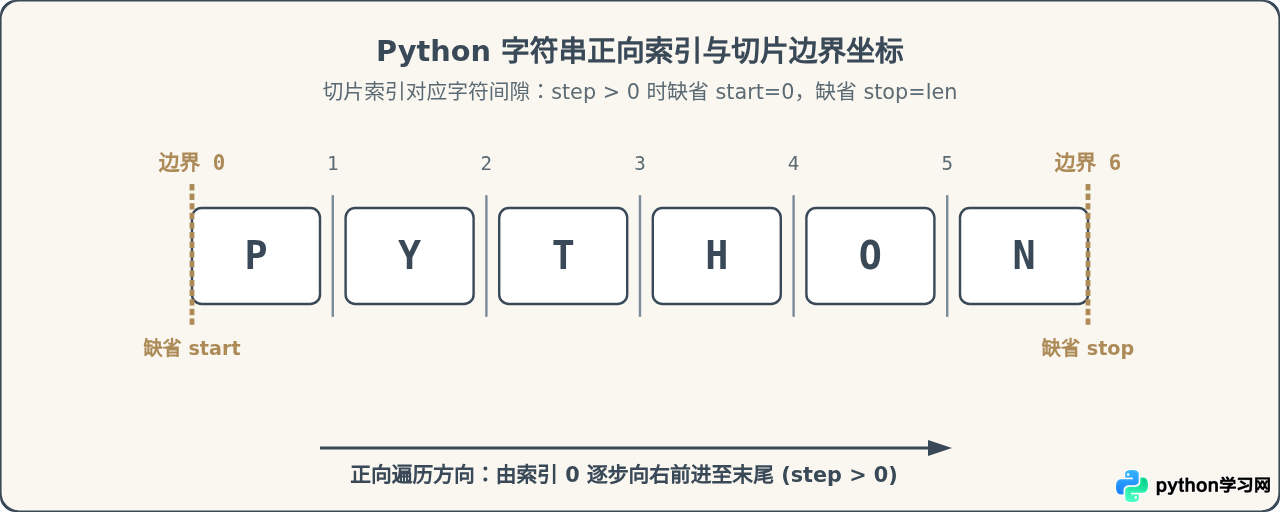
二、逆向步长:当 step 小于 0 时的端点反转
当 step < 0 时,切片的读取顺序彻底颠倒为从右向左。为了保证“从起点出发向左移动”能够顺畅读取,Python 颠覆了正向切片的端点设定:
- 省略 start 时:默认从序列的最右端字符开始,即
start = len(s) - 1(对应最后一个元素的索引)。 - 省略 stop 时:默认一直向左读取并包含最开头的第一个字符(即索引 0 处的元素),直到超出首端边界。
如果读者希望反向截取直到字符串开头,必须省略 stop。若误将 stop 显式指定为 0,由于切片区间不包含 stop 处的元素,索引 0 的字符就会被舍弃。
text = "PYTHON"

# 1. 经典逆序:同时省略 start 和 stop
print(text[::-1])     # 输出: NOHTYP

# 2. 省略 start:默认从末尾(索引 5)出发,向左切到索引 2(不含 2)
print(text[:2:-1])    # 输出: NOH

# 3. 指定 start,省略 stop:从索引 3 向左切,直至包含索引 0
print(text[3::-1])    # 输出: HTYP

# 4. 常见误区:若显式指定 stop=0,索引 0 处的 'P' 会被丢弃!
print(text[3:0:-1])   # 输出: HTY (缺少了 'P')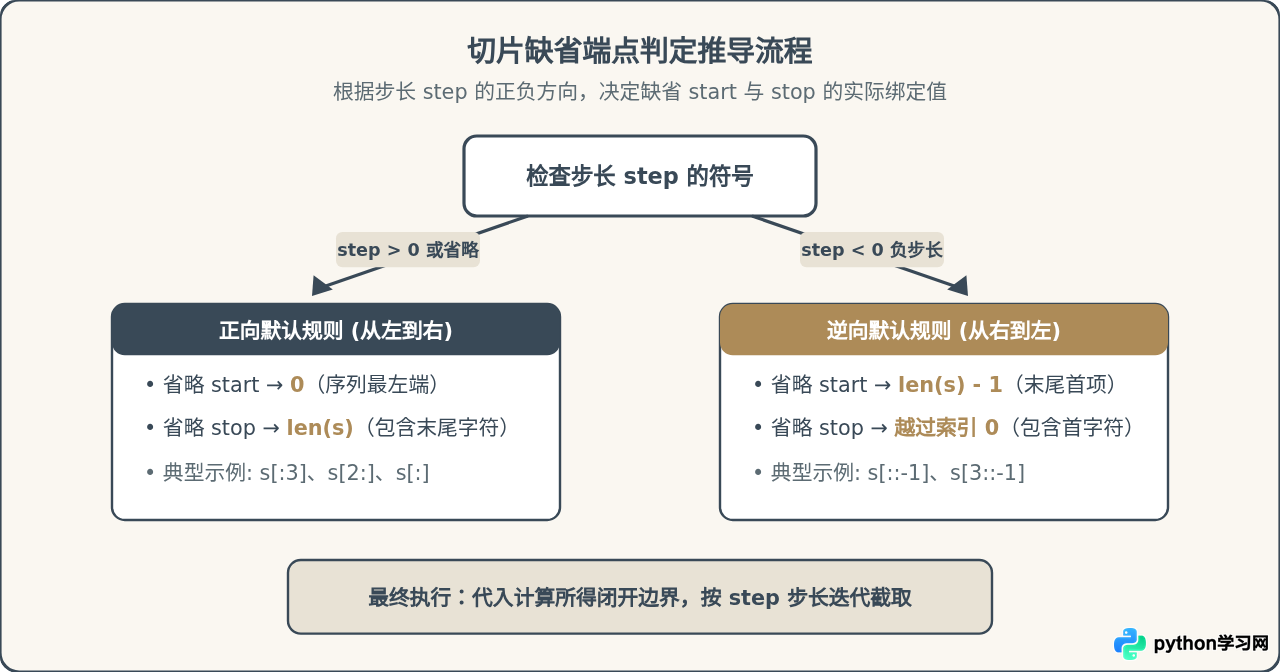
三、底层解析:slice.indices() 如何处理 None
在 Python 内部,语法糖 s[start:stop:step] 会被转换为内置的 slice 对象,即 slice(start, stop, step)。未指定的切片参数在底层均表示为 None。
序列在底层解析切片时,会调用 slice.indices(length) 方法。该方法接收序列长度作为参数,将所有 None 以及超出范围的索引规范化为一个确定的三元组 (start, stop, step):
# 演示内置 slice.indices 的解析结果
length = 6  # 例如 "PYTHON" 的长度

# 场景 A:正向步长
print(slice(None, 4, 1).indices(length))     # 输出: (0, 4, 1)
print(slice(2, None, 1).indices(length))     # 输出: (2, 6, 1)

# 场景 B:负向步长
print(slice(None, None, -1).indices(length))  # 输出: (5, -1, -1)
print(slice(3, None, -1).indices(length))    # 输出: (3, -1, -1)
print(slice(None, 2, -1).indices(length)) # 输出: (5, 2, -1)关键观察:在负向步长解析结果中,省略的 stop 被规范化为了 -1。在 Python 的 range(start, -1, -1) 语义下,下限 -1 表示遍历将在索引 0 处停止并包含 0(因为左闭右开),这优雅地解决了“如何逆向截取到第 0 位”的边界表示问题。
四、避坑指南与核心记忆卡
在日常编写 Python 代码时,因混淆切片缺省值而导致的 Bug 主要集中在负步长场景。牢记以下三条要诀即可彻底避免错误:
- 逆向切片到开头必须留空 stop:千万不要写成
s[4:0:-1],这会使索引 0 丢失;正确写法是保留冒号并省略 stop,即s[4::-1]。 - 方向矛盾会导致空结果:若
start在stop的左侧,但step却为负数(例如s[1:4:-1]),切片不会报错,而是直接返回空字符串""。 - 善用 slice().indices() 进行验证:在调试复杂或动态计算的切片区间时,使用内置方法直接打印解析后的三元组,能迅速确认边界是否如预期设定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









