

Python机器学习新手入门:环境搭建与Scikit-learn实战指南

一、为什么需要隔离环境与基础工具链准备
在进入具体的算法前,搭建一个干净、独立的 Python 运行时环境是首要前提。机器学习项目涉及大量的底层数值计算库(如 NumPy、SciPy、OpenBLAS 等 C/Fortran 扩展),如果直接安装到系统全局 Python 环境中,极易因不同项目的依赖版本冲突导致动态链接库加载失败。
Python 官方内置的 venv 模块或轻量级环境管理工具能够为每个项目提供独立的 Python 解释器二进制文件与 site-packages 目录。建议使用 Python 3.9 至 3.11 版本,既兼顾绝大多数基础算法库的预编译二进制包(Wheel),又能避免过旧版本的特性缺失。
1. 搭建专用虚拟环境的标准步骤
在终端或命令行工具中,按照以下指令新建项目文件夹并激活专属虚拟环境:
# 1. 创建项目目录并进入
mkdir ml_starter && cd ml_starter

# 2. 创建名为 .venv 的虚拟环境
python3 -m venv .venv

# 3. 激活虚拟环境
# macOS / Linux:
source .venv/bin/activate
# Windows (PowerShell):
# .venv\Scripts\Activate.ps1

# 4. 升级 pip 至最新版本
python -m pip install --upgrade pip
2. 安装 Scikit-learn 及其科学计算依赖栈
Scikit-learn(简称 sklearn)是 Python 生态中最经典的通用机器学习库,涵盖分类、回归、聚类、降维以及模型选择工具。它依赖 NumPy 提供高效多维数组计算,依赖 SciPy 提供稀疏矩阵与优化函数支持。通过 pip 安装即可自动解析并下载适配系统的依赖项:
# 安装基础计算与建模套件
pip install numpy scipy scikit-learn pandas matplotlib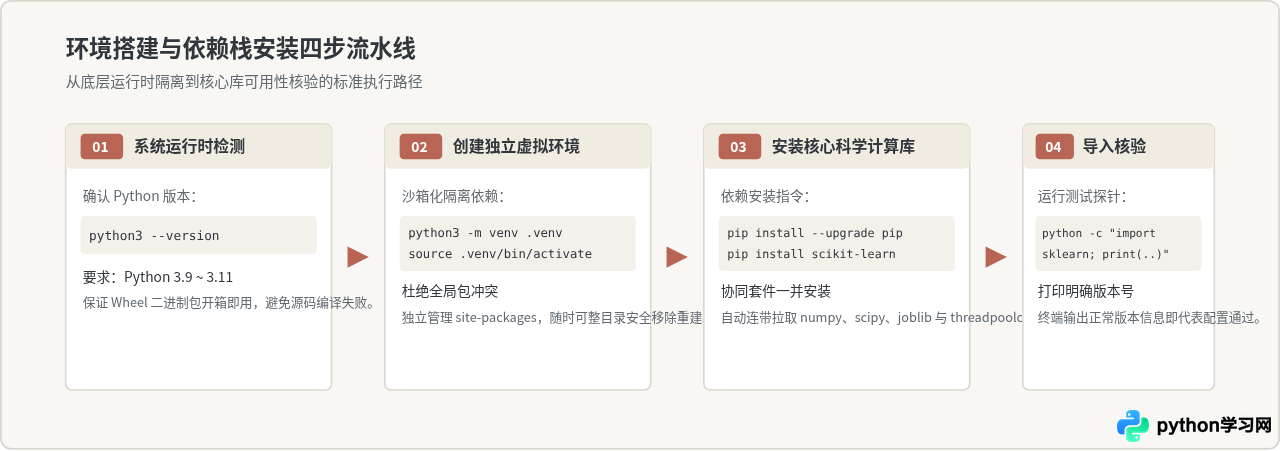
3. 验证环境是否可用
安装完成后,在终端直接执行以下单行 Python 测试命令:
python -c "import sklearn, numpy, scipy; print('Scikit-learn 版本:', sklearn.__version__); print('NumPy 版本:', numpy.__version__)"示例输出:
Scikit-learn 版本: 1.4.2
NumPy 版本: 1.26.4
只要能正常打印出版本号且没有任何报错,说明环境已成功就绪。
二、理解 Scikit-learn 的核心设计与 API 规范
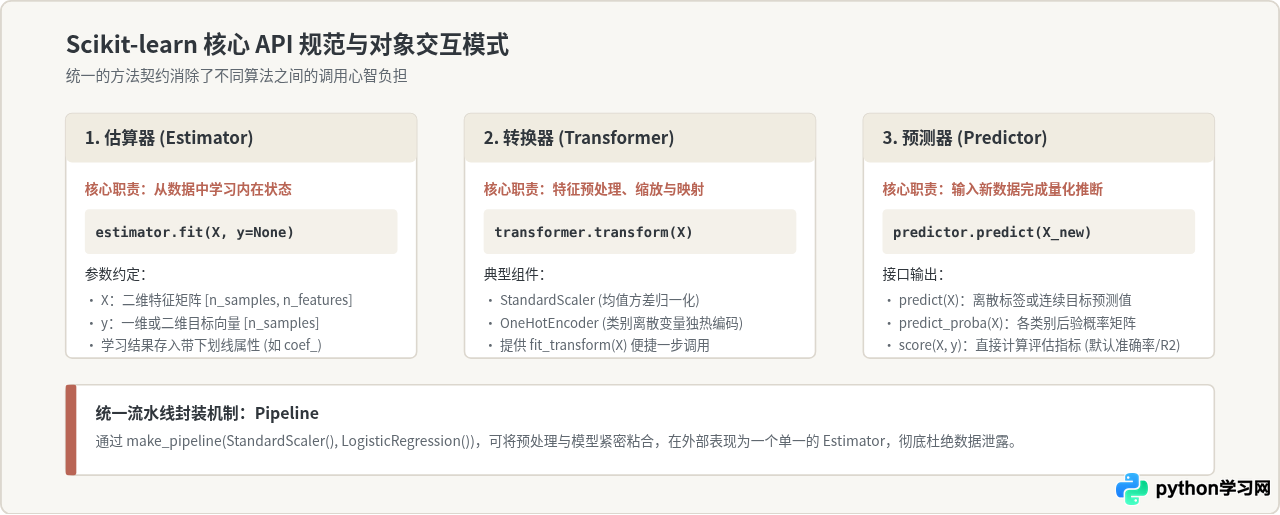
Scikit-learn 能够成为机器学习业界事实标准的原因之一,在于其极其优雅且一致的面向对象接口设计。不论使用简单的逻辑回归,还是复杂的随机森林、支持向量机,所有算法对象均遵循统一的三个核心设计规范:
- Estimator(估算器):一切能够基于数据估算参数的模型对象。通过调用
fit(X, y)方法从训练数据中学习参数,并将学习到的内部状态保存在带有下划线后缀的属性中(例如model.coef_、model.classes_)。 - Transformer(转换器):用于特征缩放、编码与清洗的数据预处理对象。除了具备
fit()学习转换规则外,还提供transform(X)将规则应用到新数据,以及fit_transform(X)快捷执行这两步。 - Predictor(预测器):负责在新样本上执行推断的估算器。通过
predict(X)输出离散类别或连续数值,分类任务还常通过predict_proba(X)输出样本归属于各个类别的预测概率。
三、实战演练:端到端分类模型构建
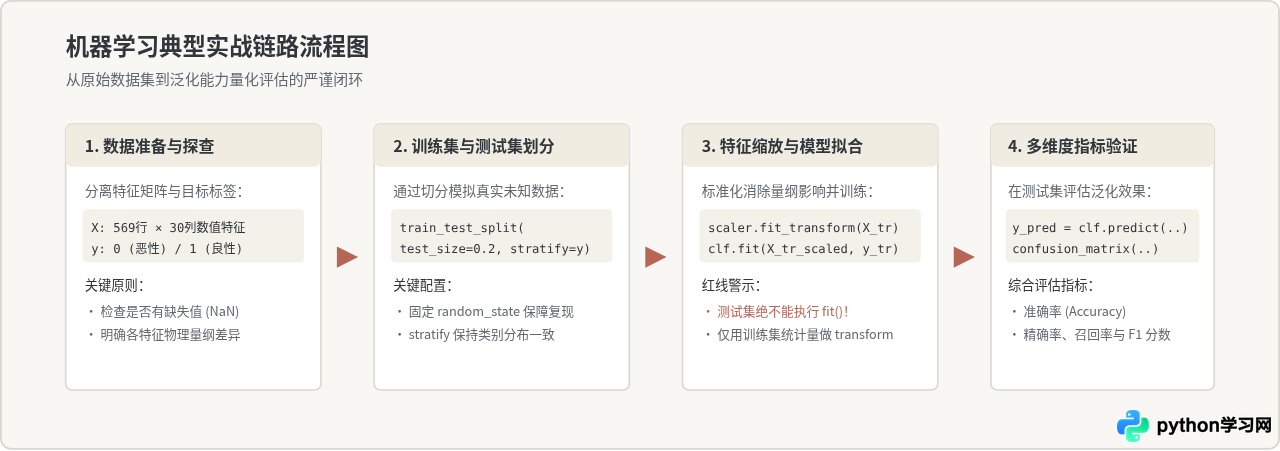
为了完整理解实际开发中的各个环节,我们以 Scikit-learn 内置经典的乳腺癌诊断数据集(Breast Cancer Wisconsin Dataset)为例。该任务是一个标准的二分类问题(恶性 vs 良性),拥有 569 个样本与 30 个连续型数值特征。我们将完整走过数据读取、特征切分、标准化、模型训练与全维度指标评估五大阶段。
完整实战代码示例
将以下代码保存为 main.py 并在激活虚拟环境后运行:
# main.py
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

def run_classification_pipeline():
    # 1. 加载内置数据集
    data = load_breast_cancer()
    X, y = data.data, data.target
    print(f"[数据概况] 样本总量: {X.shape[0]}, 特征维度: {X.shape[1]}")
    print(f"[类别标签] {data.target_names[0]}: 0 (恶性), {data.target_names[1]}: 1 (良性)\n")

    # 2. 划分训练集与测试集 (80% 训练, 20% 测试)
    # stratify=y 确保训练集与测试集中正负样本比例严格一致
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42, stratify=y
    )

    # 3. 特征标准化 (Z-score 变换: (x - mean) / std)
    scaler = StandardScaler()
    # 仅在训练集拟合均值与方差,并转换训练集
    X_train_scaled = scaler.fit_transform(X_train)
    # 使用训练集学到的均值和方差转换测试集
    X_test_scaled = scaler.transform(X_test)

    # 4. 构建并拟合逻辑回归分类器
    classifier = LogisticRegression(max_iter=1000, random_state=42)
    classifier.fit(X_train_scaled, y_train)

    # 5. 推理预测与指标评估
    y_pred = classifier.predict(X_test_scaled)

    acc = accuracy_score(y_test, y_pred)
    cm = confusion_matrix(y_test, y_pred)

    print(f"[测试集准确率] Accuracy: {acc:.4f}\n")
    print("[混淆矩阵 Confusion Matrix]:")
    print(cm)
    print("\n[分类报告 Classification Report]:")
    print(classification_report(y_test, y_pred, target_names=data.target_names))

if __name__ == "__main__":
    run_classification_pipeline()
示例输出结果:
[数据概况] 样本总量: 569, 特征维度: 30
[类别标签] malignant: 0 (恶性), benign: 1 (良性)

[测试集准确率] Accuracy: 0.9825

[混淆矩阵 Confusion Matrix]:
[[41  1]
 [ 1 71]]

[分类报告 Classification Report]:
              precision    recall  f1-score   support

   malignant       0.98      0.98      0.98        42
      benign       0.99      0.99      0.99        72

    accuracy                           0.98       114
   macro avg       0.98      0.98      0.98       114
weighted avg 0.98 0.98 0.98 114四、新手最常踩入的三大误区与规避准则
初学者在跑通基础 Demo 后,在面对自定义真实业务数据时,往往会出现“本地测试集指标极高,一上线真实场景效果暴跌”的现象。这通常源自以下三类隐蔽错误:
1. 数据泄露(Data Leakage)
这是最致命的错误。如果对整个数据集统一做 scaler.fit_transform(X),测试集的均值和方差信息就已经被提前泄露给了归一化转换器。模型在训练时实际上间接“看到”了测试集的全局分布,导致测试集评估完全失真。
铁律:任何包含 fit() 的统计学习步骤(无论是缺失值填充、离群点截断还是标准化),都必须且只能在训练集执行;测试集只能调用 transform()。
2. 样本不均衡下的“准确率陷阱”(Accuracy Paradox)
如果数据集中 99% 的样本都是良性(正例),只有 1% 是欺诈或恶性(负例)。即使模型什么都不学、无脑全部预测为良性,也能轻而易举得到 99% 的准确率,但该模型在业务上毫无价值。
对策:不能只看 accuracy,必须同步观测 Precision(精确率)、Recall(召回率)以及两者的调和平均 F1-score;在样本严重不平衡时,还可以调整算法的类别权重(如 class_weight='balanced')。
3. 使用 Pipeline 消除重复代码与泄漏隐患
Scikit-learn 提供了 Pipeline 工具,将预处理和模型连接为单一对象。使用 Pipeline 时,交叉验证或网格搜索在切分每一折折叠时,都会自动且严格地仅在训练子集上做 fit,从工程结构上彻底阻断数据泄露。
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import cross_val_score

# 将标准化与分类器打包为单条流水线
pipe = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))

# 采用 5 折交叉验证 (5-Fold Cross Validation) 评估模型鲁棒性
cv_scores = cross_val_score(pipe, X, y, cv=5, scoring='accuracy')
print(f"5折交叉验证平均分: {cv_scores.mean():.4f} (标准差: {cv_scores.std():.4f})")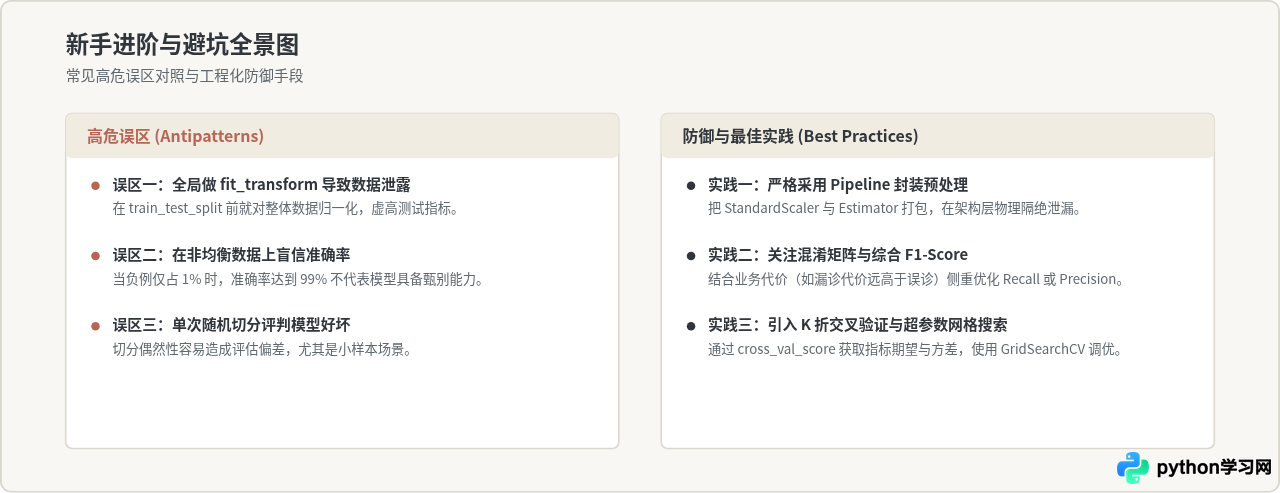
五、常用速查清单与总结
为了便于在日常编写代码时快速排查,下表整理了核心接口、标准调用位置及常见注意事项:
| 处理阶段 | 标准接口 / 函数 | 适用对象 | 注意事项与常见报错 |
|---|---|---|---|
| 环境隔离 | python -m venv .venv |
系统 Shell | 激活后终端前缀应显示 (.venv),避免与全局库混淆。 |
| 样本切分 | train_test_split() |
X, y 数据集 | 分类务必设置 stratify=y,固定 random_state 确保可重现。 |
| 特征工程 | StandardScaler() |
数值型特征 | 训练集用 fit_transform(),测试集仅用 transform()。 |
| 模型拟合 | model.fit(X_train, y_train) |
各类 Estimator | 确保输入矩阵为二维浮点型数组,无空值 (NaN) 或无穷大 (Inf)。 |
| 模型推理 | model.predict(X_test) |
训练就绪的模型 | 传入特征列顺序必须与训练时完全一致,否则推断失效。 |
| 工程封装 | make_pipeline() |
预处理 + 算法 | 彻底规避交叉验证过程中的数据泄漏,推荐作为工程标配。 |
掌握 Python 机器学习并不需要一上来就钻研晦涩的数学推导。从配置干净的虚拟环境开始,理解 Scikit-learn 的 Estimator 接口契约,严格遵循“训练-测试隔离”的工程防线,并通过混淆矩阵理性评估算法表现,你就已经建立起了标准且扎实的机器学习工程开发基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









