

Python sorted函数key参数原理:它怎么影响排序结果
深入解析 Python sorted 函数中 key 参数的工作机制与底层原理,通过施瓦茨变换机制、多维排序实现、性能表现与稳定性分析,帮助读者全面掌握自定义排序的核心规则与避坑指南。
在 Python 中,sorted() 函数的 key 参数接收一个单参数可调用对象(例如函数、方法或 lambda 表达式)。它的核心作用是为待排序序列中的每个元素提取出一个临时的“代理比较键”(Proxy Key)。排序算法在决定元素先后次序时,严格比对这些代理键的大小,而非直接比对原始对象;排序完成后,列表将以原始对象的形态返回。理解 key 的工作机制与底层原理,是掌握 Python 自定义排序、保障排序性能与稳定性的关键。
一、key 参数的核心作用:提取代理比较键
默认情况下,sorted() 按照元素本身的天然大小关系进行升序排序。例如数字比大小、字符串按字典序排列。当需要对不具备直接大小关系的对象(如字典、自定义类)进行排序,或者需要改变现有的对比维度(如忽略字母大小写、按字符串长度排列)时,就需要借助 key 参数。
下面的示例展示了常规排序与通过 key 自定义排序的行为差异:
# 默认按字符串 ASCII / 字典序排序(大写字母排在小写字母前)
words = ['banana', 'Apple', 'cherry', 'Date']
print(sorted(words))
# 输出: ['Apple', 'Date', 'banana', 'cherry']

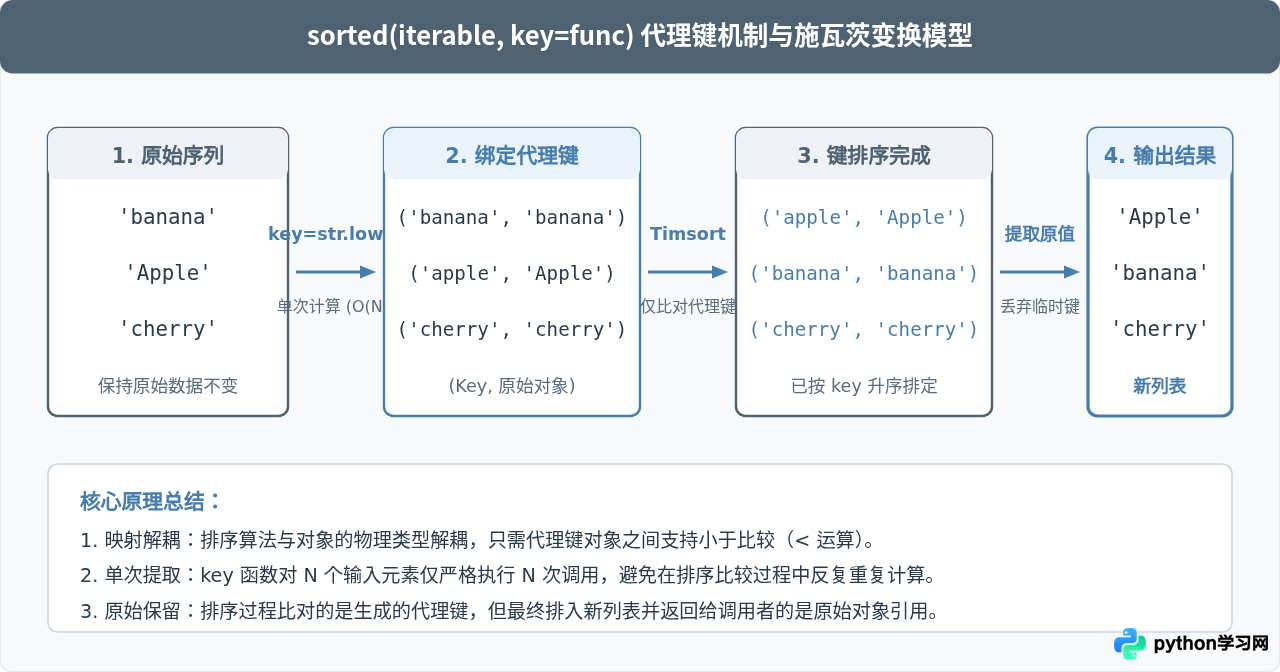
# 借助 key=str.lower,将每个字符串映射为其全小写形式作为代理键
print(sorted(words, key=str.lower))
# 输出: ['Apple', 'banana', 'cherry', 'Date']在这个例子中,'Apple' 与 'banana' 比较时,底层调用的并非 'Apple' < 'banana',而是 str.lower('Apple') < str.lower('banana'),即 'apple' < 'banana'。因此最终的排列顺序反映了小写形式的大小关系,但最终输出结果依旧保留了原始单词的大写形态。
二、底层运作机制:施瓦茨变换(Decorate-Sort-Undecorate)
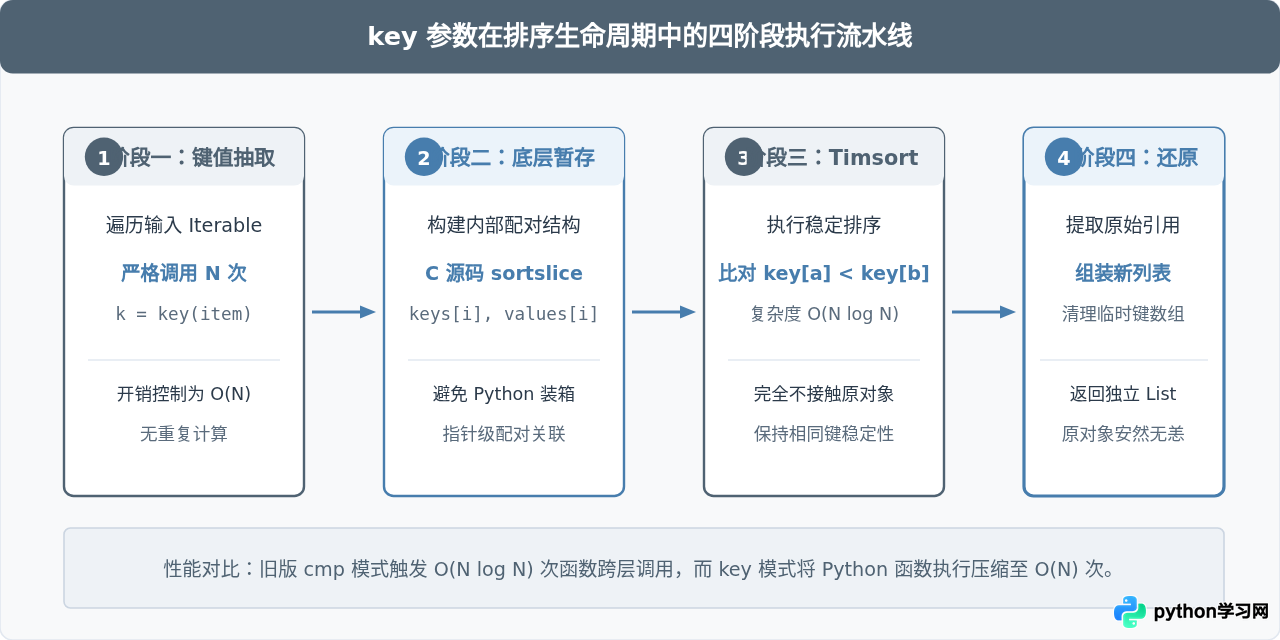
在 Python 2 早期版本中,排序主要依赖 cmp 参数。cmp 接收一个接受两个参数的双目函数 cmp(a, b),每次元素两两比对时都会触发执行。在一个长度为 N 的序列中,快速排序或 Timsort 平均需要进行约 O(N log N) 次两两比较。如果比较函数本身涉及较重的格式转换或属性读取,多次重复计算会导致严重的性能损耗。
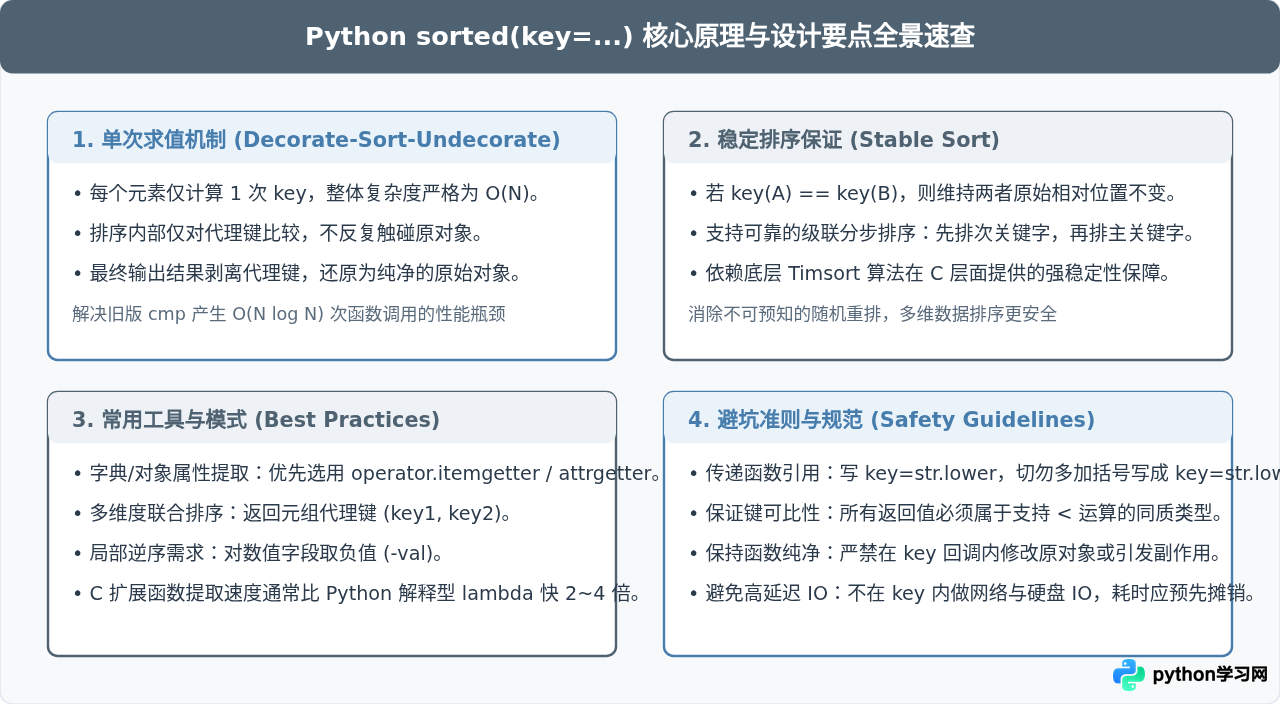
从 Python 2.4 开始引入、并在 Python 3 中成为唯一标准的 key 参数,彻底采用了计算机科学中经典的施瓦茨变换(Schwartzian Transform)模式,也常被称为 Decorate-Sort-Undecorate(装饰-排序-去装饰) 模式:
- Decorate(装饰):在排序真正启动前,遍历待排序序列。对每个元素
x仅调用一次key(x),在底层 C 语言结构中将key(x)计算出的代理键与原始对象打包暂存。这个过程的时间复杂度严格为O(N)。 - Sort(排序):底层 Timsort 算法完全针对暂存的“代理键”执行升序比较。排序期间不需要再调用任何 Python 层的
key函数。 - Undecorate(去除装饰):排序就绪后,沿着排序好的中间数组顺序提取出原始对象的指针,构建全新的 Python 列表并返回,同时释放暂存的代理键对象。
三、常见应用场景与排序逻辑调控
明确了代理键的映射原理后,可以通过设计不同的 key 函数精准控制最终输出结果。以下是三种最常见的高频场景:
1. 结构化数据按特定属性/键值排序
当列表中包含字典、命名元组或自定义对象时,这些对象默认可能无法直接比较(如 Python 3 不支持两个普通字典直接使用 < 比大小)。此时 key 参数可以指定提取其中的某一个字段作为排序凭证:
students = [
    {'name': '张三', 'score': 88},
    {'name': '李四', 'score': 95},
    {'name': '王五', 'score': 72}
]

# 按分数从低到高排序
sorted_by_score = sorted(students, key=lambda s: s['score'])
# 输出李四排最后,王五排最前
为了提升性能,Python 的 operator 模块提供了由 C 语言实现的 itemgetter 和 attrgetter,速度通常比纯 Python 的 lambda 更快:
from operator import itemgetter

# 使用 itemgetter 提取键值,执行效率更高
sorted_by_score = sorted(students, key=itemgetter('score'))
2. 多维度优先级排序(元组代理键)
当排序需要按多个规则级联判定(例如:首先按成绩降序,若成绩相同则按年龄升序)时,key 函数可以返回一个元组(Tuple)。
在 Python 中,元组的比较规则是逐项比较:先比较第 0 个元素;若第 0 个元素相等,再比较第 1 个元素;以此类推。利用这一特性,我们可以把多个维度的优先级编码进同一个代理键中:
students = [
    {'name': '张三', 'score': 95, 'age': 16},
    {'name': '李四', 'score': 90, 'age': 15},
    {'name': '王五', 'score': 95, 'age': 14}
]

# 成绩降序(加负号转换),年龄升序(直接比较正整数)
result = sorted(students, key=lambda x: (-x['score'], x['age']))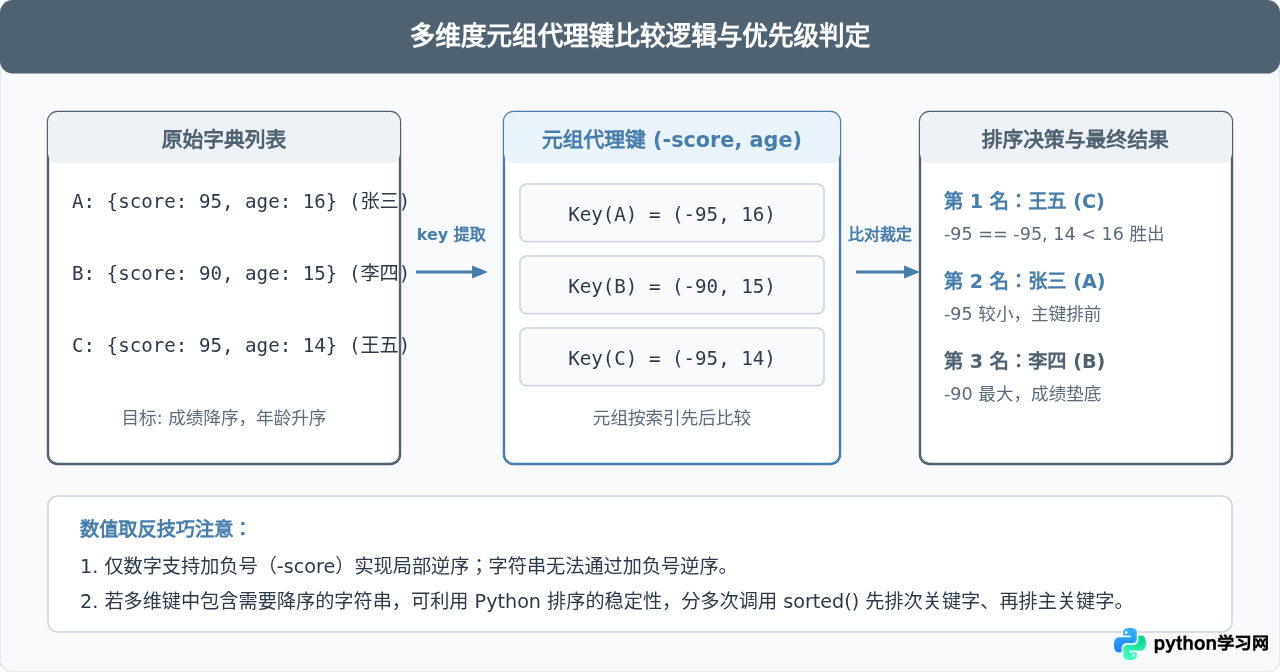
四、排序稳定性与相等键值的顺序保障
Python 采用的底层排序算法是 Timsort,它是一种严格的稳定排序算法(Stable Sort)。
排序稳定性的定义是:如果待排序序列中有两个元素通过 key 计算出的代理键完全相等(即 key(a) == key(b)),那么在最终排序结果中,它们之间的相对先后顺序严格保持与原始输入一致。
items = [('apple', 1), ('banana', 2), ('avocado', 1)]

# 仅根据第二个数字元素排序
result = sorted(items, key=lambda x: x[1])

print(result)
# 输出: [('apple', 1), ('avocado', 1), ('banana', 2)]在上面的例子中,('apple', 1) 和 ('avocado', 1) 的代理键均为 1。因为排序算法具备稳定性,原始序列中排在前面的 ('apple', 1) 仍然稳固排在 ('avocado', 1) 之前,绝不会发生任意颠倒。
稳定性的核心应用价值在于多轮级联排序。当无法在一个元组中同时处理升序与降序字符串时,可以从最次要的规则开始排序,最后对最主要的规则排序,每次排序都不会打乱上一轮已排好的相对次序。
五、key 参数使用规范与避坑指南
在实际编码中,错误使用 key 参数不仅可能导致 TypeError 运行时异常,还可能引入隐蔽的性能瓶颈。以下是必须注意的四个准则:
| 避坑点 | 错误写法 | 正确规范 | 底层原因分析 |
|---|---|---|---|
| 传入调用结果而非函数 | key=str.lower() |
key=str.lower |
必须传入函数对象本身;若写括号则是在排序前立刻执行并传回一个具体字符串,导致类型报错。 |
| 代理键不可比 | 返回无法比对的类型,如 (None, 1) 与 (2, 3) |
保证所有元素生成的 key 属于同构且支持 < 的类型 |
Python 3 移除了不同类型之间的默认大小比较规则,类型不匹配会抛出 TypeError。 |
| 在 key 函数中修改原对象 | 在 lambda 中执行 item.append(...) 等带有副作用的写操作 |
key 函数应保持为纯函数(Pure Function) | 副作用破坏对象原有状态,可能产生不可预测的时序依赖与数据污染。 |
| 在 key 中重复做重度计算 | 在 key 内部查询数据库或执行网络请求 | 先在内存中预处理好计算结果,排序时仅做简单属性读取 | 虽然 key 仅调用 N 次,但若单次耗时过高,整体排序耗时仍会显著劣化。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









