

Python列表怎么用key参数实现自定义排序规则
深入浅出讲解Python列表排序中key参数的原理与实战方法,涵盖单条件排序、元组多条件组合排序、operator模块优化以及处理None和复杂结构的技巧。
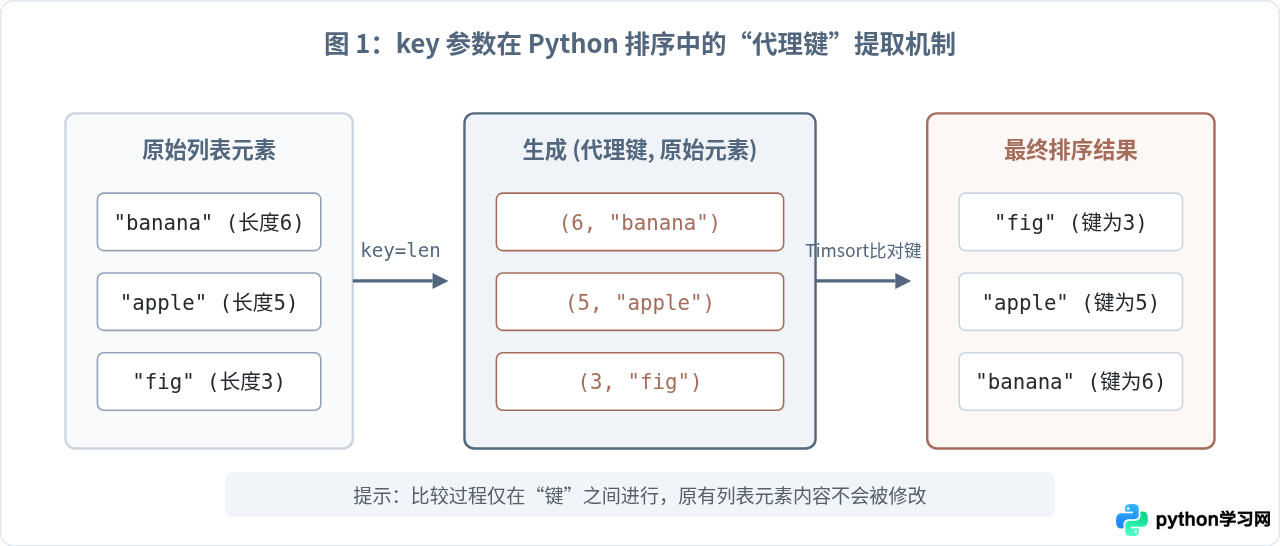
list.sort() 还是返回新列表的 sorted(),要实现自定义排序规则,核心都是向 key 参数传入一个单参数函数。该函数为列表中的每个元素提取一个可供比较的“代理键”(Proxy Key),排序算法仅比对这些键值的大小,完成排序后输出原元素。
一、key 参数的本质与工作机制
很多初学者容易把 key 参数误解为某种“两两比对”的判定函数。实际上,早期 Python 2 中曾支持过接受两个元素比较的 cmp 参数,但早已被废弃并全面由 key 取代。理解 key 的机制只需要记住一个核心事实:它是一个单参数提取函数。
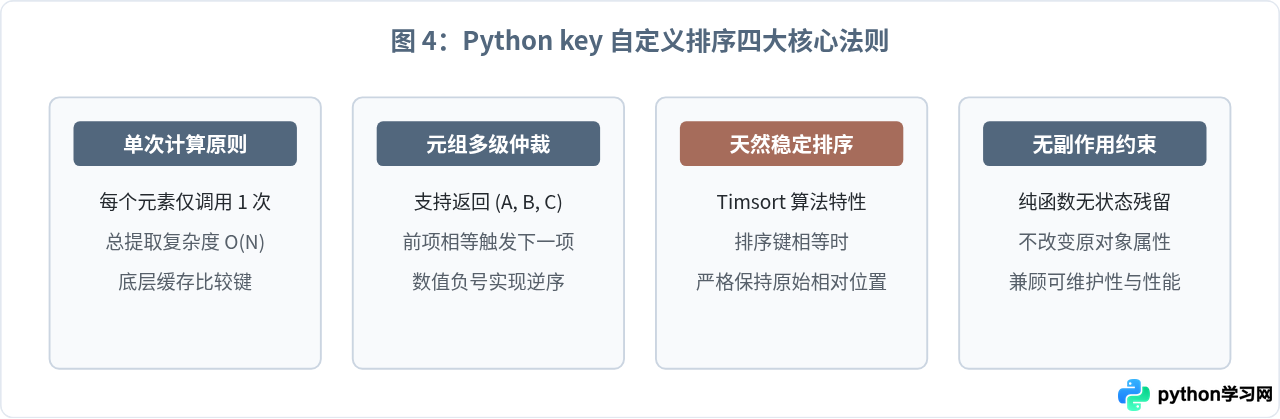
当执行带有 key=func 的排序时,Python 内部并不会在每次两两比较时都调用一次 func。它在排序开始前对列表中的 $N$ 个元素分别调用且仅调用一次该函数,将原元素与提取出的排序键绑定。实际参与底层 Timsort 算法比对的是提取出来的排序键。这种设计被称为“施瓦茨变换”(Schwartzian Transform),不仅执行效率极高(时间复杂度仅有 $O(N)$ 次键提取),而且天然保证了排序的稳定性。
二、基础实践:使用内置函数与 lambda 表达式
在日常开发中,自定义规则往往可以从最直观的单维度属性开始。最简单的写法是直接复用 Python 原生内置函数或方法。
1. 传入内置函数名
如果目标规则恰好有现成的转换函数,直接把函数名作为参数传入即可,切勿在传参时带上圆括号调用的 ():
words = ["banana", "pie", "watermelon", "apple"]

# 规则:按字符串长度由短到长排序
words.sort(key=len)
print(words)
# 输出结果: ['pie', 'apple', 'banana', 'watermelon']

# 规则:忽略大小写的字母序排序
mixed_cases = ["beta", "Alpha", "gamma", "DELTA"]
sorted_cases = sorted(mixed_cases, key=str.lower)
print(sorted_cases)
# 输出结果: ['Alpha', 'beta', 'DELTA', 'gamma']
2. 使用 lambda 提取嵌套结构字段
当列表元素是字典、元组或复杂自定义对象时,我们需要指定元素内部的某个具体字段进行排序。此时 lambda 表达式是最轻量的选择:
students = [
    {"name": "小明", "score": 85, "age": 16},
    {"name": "小红", "score": 92, "age": 15},
    {"name": "小刚", "score": 78, "age": 17}
]

# 规则:按分数从低到高排序
students.sort(key=lambda s: s["score"])
print([s["name"] for s in students])
# 输出结果: ['小刚', '小明', '小红']

# 规则:若要从高到低,可配合 reverse=True 或在数值型键前加负号
students.sort(key=lambda s: s["score"], reverse=True)
三、核心进阶:利用元组(Tuple)实现多级多条件排序
实际业务很少只有单一排序条件。例如在排行榜中,常见的规则是:“先按积分降序排序;积分相同时,再按提交时间升序排序;若时间还相同,按用户注册 ID 排序”。
许多开发者在面对这种需求时会尝试写多次循环或复杂的条件判断。但在 Python 中,实现多级排序只需要让 key 函数返回一个元组(Tuple)。
Python 在对比两个元组时遵循从左至右的词典比较法则:先比较第一个元素,如果已经能决出胜负,则直接得出大小结果;只有当第一个元素相等时,才会触发第二个元素的比对,以此类推。
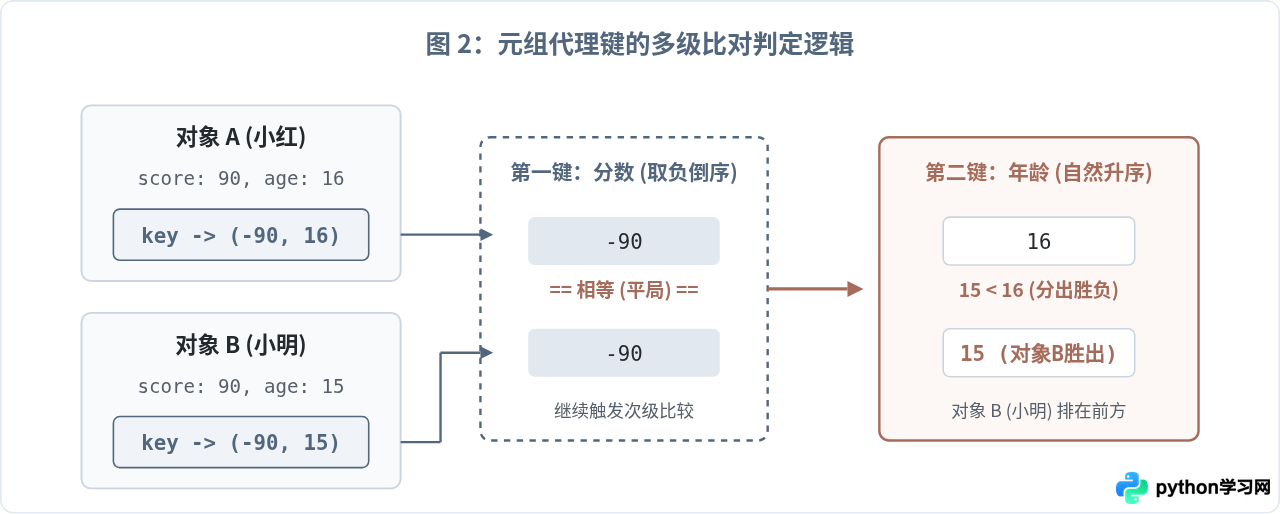
多级排序的代码实现非常直观。如果某个字段是数值类型且需要降序排,只需要加上一个负号 -:
students = [
    {"name": "小明", "score": 90, "age": 16},
    {"name": "小红", "score": 90, "age": 15},
    {"name": "小刚", "score": 82, "age": 18},
    {"name": "小华", "score": 95, "age": 17}
  ]

# 规则:分数从大到小(降序),分数相同则年龄从小到大(升序)
students.sort(key=lambda s: (-s["score"], s["age"]))

for s in students:
    print(f"{s['name']}: 分数 {s['score']}, 年龄 {s['age']}")
# 输出示例:
# 小华: 分数 95, 年龄 17
# 小红: 分数 90, 年龄 15 (同分,小红年龄15先排)
# 小明: 分数 90, 年龄 16 (同分,小明年龄16后排)
# 小刚: 分数 82, 年龄 18- 只能作用于支持算术取负的数值(int、float)。如果第二级排序是字符串且需要降序,不能写 -s["name"]。此时有两种推荐解法:
- 分步稳定排序:利用 Python Timsort 稳定排序的特性,先对次级键进行排序,再对主键排序。
- 自定义包装类或辅助函数:构建一个翻转比较逻辑的简单反向包装对象。
四、效率利器:使用 operator 模块简化代码
虽然 lambda 足以应对绝大多数属性提取场景,但在高频循环或海量列表排序中,频繁在 Python 层解释执行匿名函数存在一定的开销。Python 标准库提供的 operator 模块提供了由 C 语言底层加速的提取器,既快又整洁。
| 场景需求 | lambda 常见写法 | operator 模块推荐写法 | 主要优势 |
|---|---|---|---|
| 提取字典键或列表索引 | lambda x: x["age"] |
itemgetter("age") |
C 底层优化,速度快 20%~30%,支持多键提取 |
| 提取对象实例的属性 | lambda x: x.created_at |
attrgetter("created_at") |
语义鲜明,避免繁琐的点操作符函数定义 |
| 调用元素自身的某个无参方法 | lambda x: x.strip() |
methodcaller("strip") |
表达优雅,免去参数传递的心智负担 |
from operator import itemgetter, attrgetter

records = [
    ("Alice", "Engineering", 3),
    ("Bob", "Marketing", 1),
    ("Charlie", "Engineering", 2)
]

# 按部门(索引1)排序,部门相同按工龄(索引2)排序
# itemgetter 支持直接传入多个键
records.sort(key=itemgetter(1, 2))
print(records)
# 输出: [('Charlie', 'Engineering', 2), ('Alice', 'Engineering', 3), ('Bob', 'Marketing', 1)]
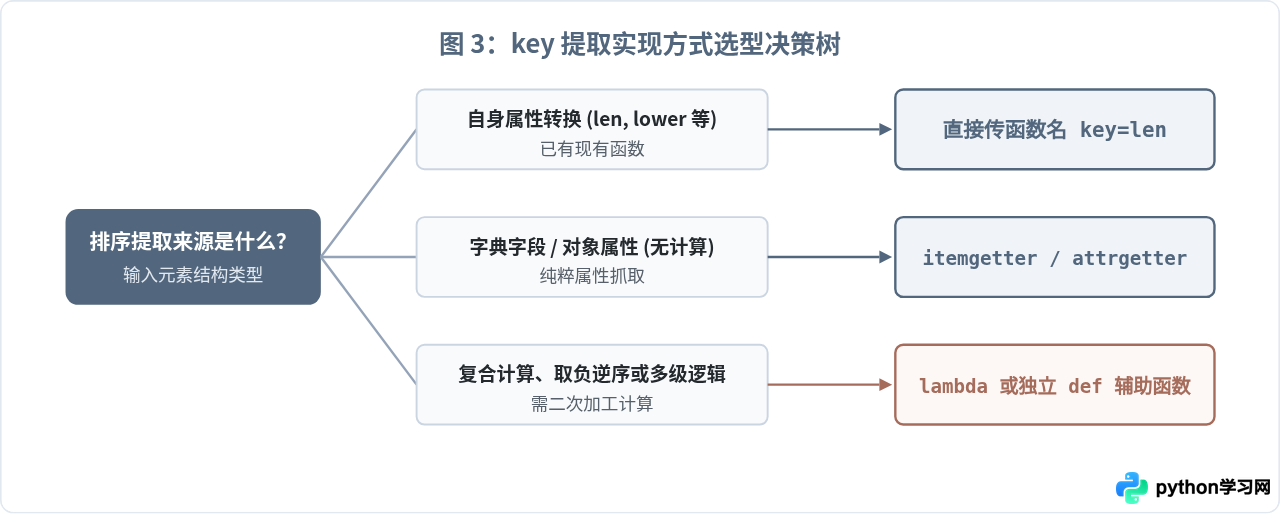
在不同工程阶段,我们应该如何根据实际需求在这些写法之间做出选择?以下决策流程给出了明确的选型路径:
五、高频踩坑点与边界处理
1. 包含 None 值的排序异常
在 Python 3 中,尝试对 None 和整型/字符串进行直接比对会立即触发 TypeError: '<' not supported between instances。如果列表中某些项缺少排序列(值为 None),通常的业务需求是将 None 统统沉到底部或置于顶端。
利用元组的首项布尔值标记,可以极度优雅地化解这一报错:
raw_data = [10, None, 45, 3, None, 28]

# 需求:数值升序排列,None 排在最后面
# 利用 (x is None) 作为第一键:False 对应 0,True 对应 1,因此有效值在前,None 在后
sorted_data = sorted(raw_data, key=lambda x: (x is None, x))
print(sorted_data)
# 输出结果: [3, 10, 28, 45, None, None]

# 若希望 None 排在最前,只需反转布尔值:
sorted_front = sorted(raw_data, key=lambda x: (x is not None, x))
print(sorted_front)
# 输出结果: [None, None, 3, 10, 28, 45]
2. 保持代码可读性:何时该放弃单行 lambda
当排序规则涉及多重正则提取、异常捕获或多级 fallback 时,强行在一行 lambda 中塞入三元运算符会导致代码极难维护。此时应当大大方方地定义一个标准的命名函数:
import re

file_names = ["img1.png", "img10.png", "img2.png", "readme.txt", "img100.png"]

def natural_sort_key(filename):
    """提取文件名中的数字和文本片段,实现自然数字序排序"""
    parts = re.split(r'(\d+)', filename)
    # 将其中的纯数字字符串转为整数,便于数字比较而非字典序
    return [int(p) if p.isdigit() else p.lower() for p in parts]

file_names.sort(key=natural_sort_key)
print(file_names)
# 输出: ['img1.png', 'img2.png', 'img10.png', 'img100.png', 'readme.txt']
六、总结与关键心智模型
掌握 key 参数不仅是记住几个常见代码片段,更是建立一套稳定、高效的排序思维模型。无论面对何种复杂的数据格式,只要能用函数映射出具有可比性的代理键(单一数值、文本或元组),排序问题就能迎刃而解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









