

Python sorted内置函数怎么实现自定义排序?
在 Python 中,内置函数 sorted() 实现自定义排序的核心机制在于 key 参数。通过向 key 传入一个单参数函数(Callable),该函数会将待排序序列中的每个元素映射为一个专门用于比较的“代理键值”(Key);Python 内部底层的 Timsort 算法随后仅比较这些计算出的键值,并输出一个包含原元素、顺序调整后的全新列表。无论是处理复杂字典、对象属性、多字段组合还是忽略大小写,都可以通过合理构造 key 函数高效实现。
一、核心语法与 key 参数工作机制
sorted() 是 Python 提供的通用排序内置函数,它接受任何可迭代对象(如列表、元组、字典、集合等),并在排序完成后返回一个新的列表,原序列保持不变。其完整函数签名如下:
sorted(iterable, key=None, reverse=False)该函数的两个可选命名参数承担着明确的分工:
iterable:待排序的目标可迭代对象。key:自定义排序的核心。接收一个单参数可调用对象(函数、lambda 表达式或方法引用),输入为当前迭代元素,输出为可比较的键(如数字、字符串或元组)。默认为None,表示直接比较元素本身。reverse:布尔值。设为True时按降序排列,默认为False(升序排列)。
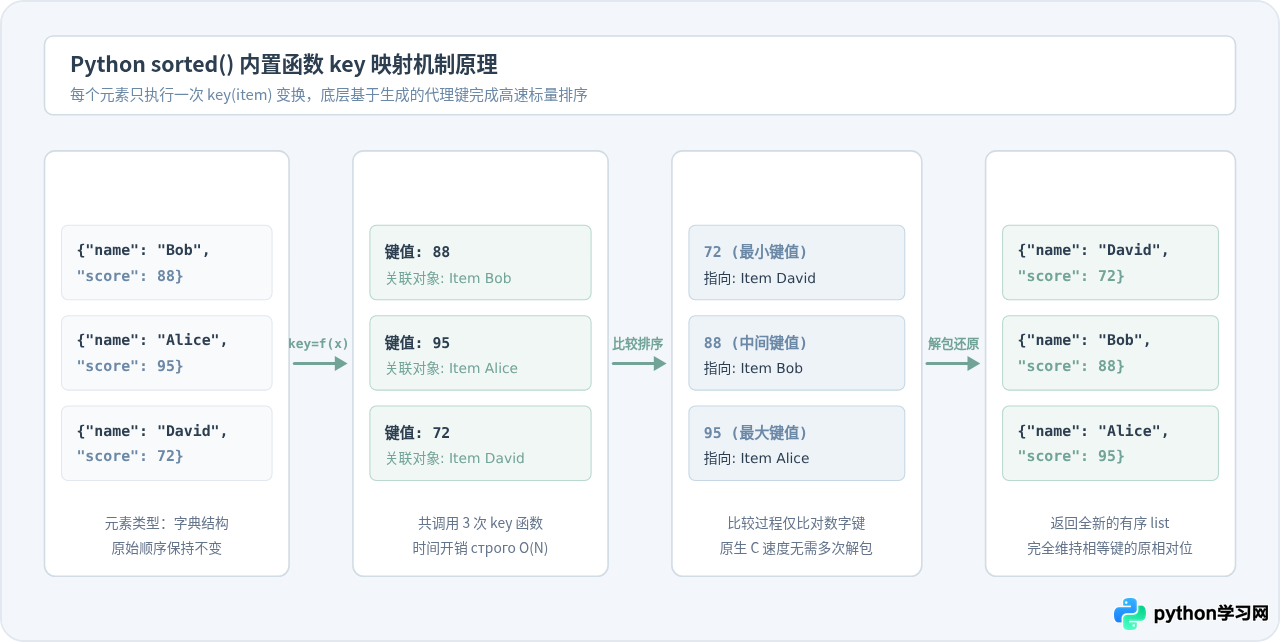
为了直观理解 key 参数的运作流程,可以观察其背后的映射机制:每个元素在排序前仅调用一次 key 函数提取出对应的代理键,随后算法直接对代理键排序并还原原始元素。这种设计称为 Schwartzian 变换,避免了在多次两两比对中重复计算键值的性能损耗。
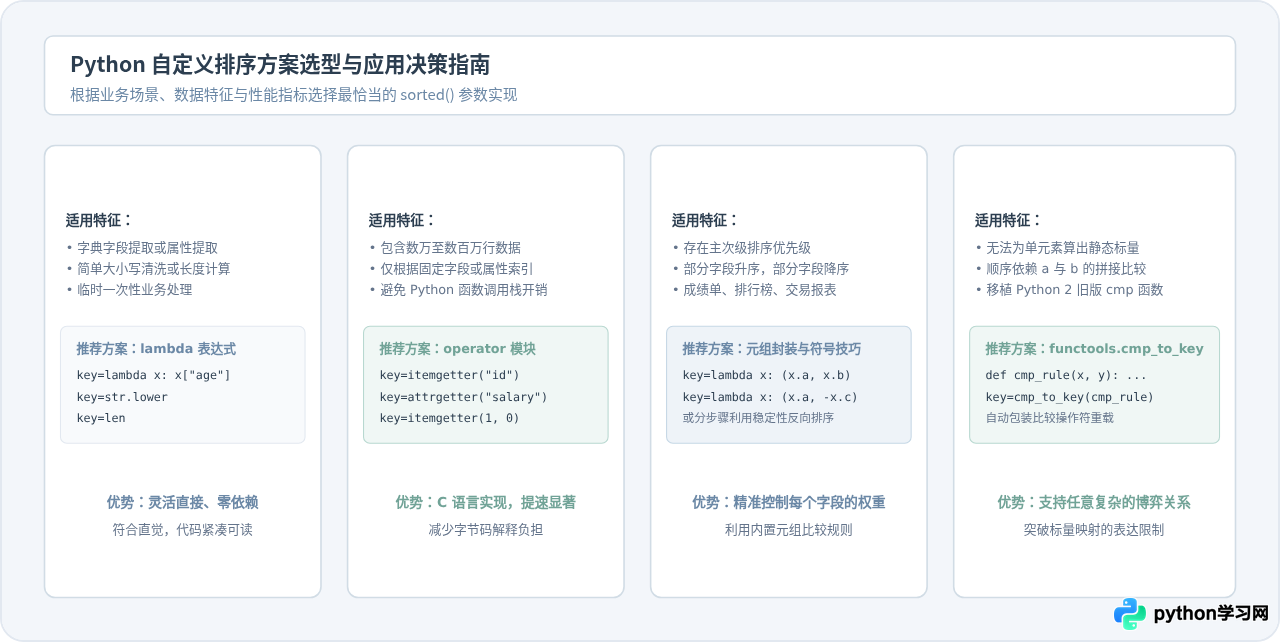
二、使用 Lambda 表达式实现常用自定义排序
在日常开发中,最常见也最轻量的方式是结合 lambda 匿名函数。通过在 lambda 中指定提取规则,可以轻松完成结构体、字典或特定计算逻辑的排序。
1. 字典列表按指定键排序
当列表中包含多个字典时,直接使用 sorted() 会触发 TypeError,因为 Python 3 默认不支持字典之间的直接比较(< 操作符未在字典间定义)。通过 key=lambda x: x['key_name'] 指定具体字段即可:
students = [
    {"name": "Bob", "score": 88},
    {"name": "Alice", "score": 95},
    {"name": "David", "score": 72}
]

# 按成绩升序排列
result_asc = sorted(students, key=lambda item: item["score"])
print("成绩升序:", [s["name"] for s in result_asc])
# 示例输出:成绩升序: ['David', 'Bob', 'Alice']

# 按成绩降序排列:设置 reverse=True
result_desc = sorted(students, key=lambda item: item["score"], reverse=True)
print("成绩降序:", [s["name"] for s in result_desc])
# 示例输出:成绩降序: ['Alice', 'Bob', 'David']
2. 自定义对象按实例属性排序
对于自定义类实例,可以通过 lambda 表达式访问其成员属性:
class Employee:
    def __init__(self, name, salary):
        self.name = name
        self.salary = salary

    def __repr__(self):
        return f"{self.name}({self.salary})"

staff = [Employee("Zhang", 9000), Employee("Li", 12000), Employee("Wang", 7500)]

# 按薪资由低到高排列
sorted_staff = sorted(staff, key=lambda emp: emp.salary)
print("员工排序结果:", sorted_staff)
# 示例输出:员工排序结果: [Wang(7500), Zhang(9000), Li(12000)]
3. 字符串不区分大小写与按长度排序
Python 默认按照字符的 Unicode 编码排序,大写字母排在小写字母前(例如 'Banana' < 'apple')。若要实现不区分大小写的字母排序,可以直接将字符串的内置方法 str.lower 作为 key 传入,无需显式写成 lambda:
words = ["banana", "Apple", "cherry", "Date"]

# 忽略大小写排序
print("忽略大小写:", sorted(words, key=str.lower))
# 示例输出:忽略大小写: ['Apple', 'banana', 'cherry', 'Date']

# 按字符串长度排序
print("按长度排序:", sorted(words, key=len))
# 示例输出:按长度排序: ['Date', 'Apple', 'banana', 'cherry']
三、工程推荐:使用 operator 模块提升性能与可读性
尽管 lambda 灵活性高,但如果只是纯粹提取字典键或对象属性,Python 标准库中的 operator 模块提供了由 C 语言底层实现的专门提取器:itemgetter 和 attrgetter。它们在运行频率极高、数据量庞大的场景下比 lambda 性能更优,且语法更加声明式。
from operator import itemgetter, attrgetter

# 1. 字典列表:使用 itemgetter 代替 lambda
users = [{"id": 3, "score": 85}, {"id": 1, "score": 92}, {"id": 2, "score": 85}]
sorted_users = sorted(users, key=itemgetter("score"))

# 2. 对象列表:使用 attrgetter 代替 lambda
# sorted_staff = sorted(staff, key=attrgetter("salary"))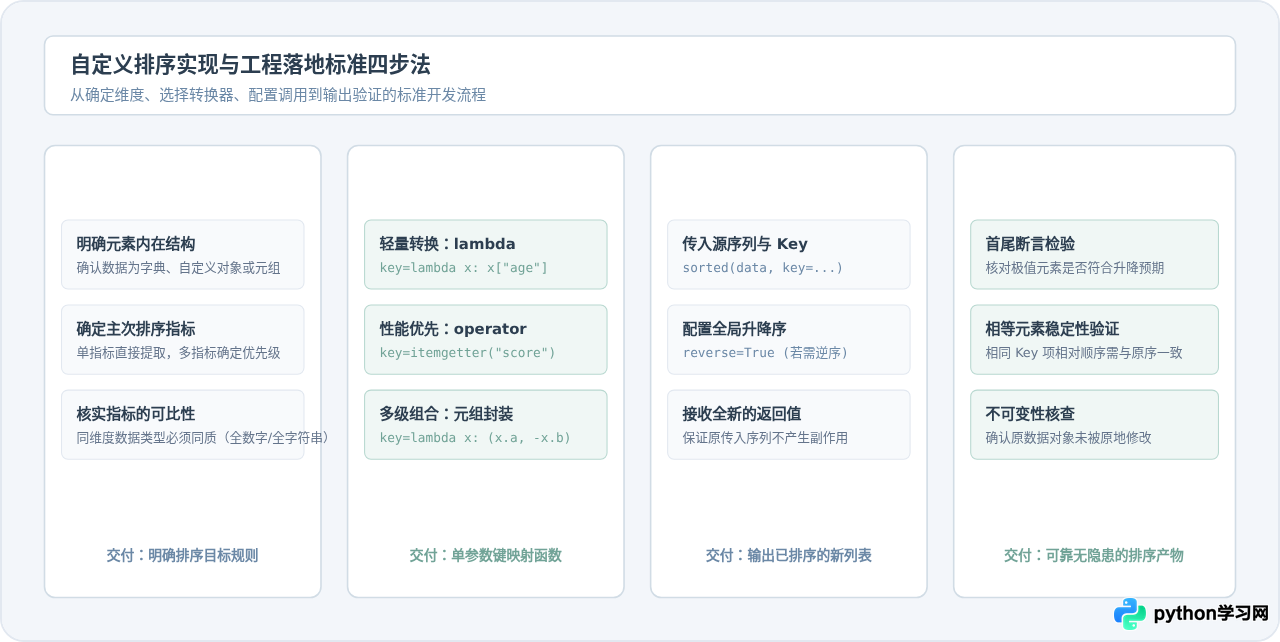
四、多维度与复合字段自定义排序
现实场景常常需要按照多个条件复合排序。例如:“先按班级升序排序;如果班级相同,再按成绩降序排序;如果成绩仍相同,最后按年龄升序排序”。在 Python 中,实现这种多字段排序的核心是依赖元组(Tuple)的内置比较规则。
1. 元组的逐位比较特性
Python 对元组进行大小比对时,会从第一个元素开始逐个比对:
- 如果第 1 项已经区分出大小,则直接确定整体大小关系;
- 只有当第 1 项相等时,才会继续比对第 2 项;以此类推。
2. 同向多字段排序
当多个字段都采用同一排序方向(全升序或全降序)时,只需在 key 函数中返回一个元组,按优先级将字段依次排列:
students = [
    {"class": 2, "name": "Bob", "score": 85},
    {"class": 1, "name": "Alice", "score": 92},
    {"class": 1, "name": "Charlie", "score": 85},
    {"class": 2, "name": "David", "score": 85}
]

# 先按班级升序,班级相同时按成绩升序
res = sorted(students, key=lambda s: (s["class"], s["score"]))
for item in res:
    print(item)
# 示例输出:
# {'class': 1, 'name': 'Charlie', 'score': 85}
# {'class': 1, 'name': 'Alice', 'score': 92}
# {'class': 2, 'name': 'Bob', 'score': 85}
# {'class': 2, 'name': 'David', 'score': 85}
如果使用 operator.itemgetter,也可以直接传递多个字段名:key=itemgetter("class", "score"),效果完全一致且执行效率更高。
3. 混合升降序排序技巧
如果希望“班级升序,但成绩降序”,由于 reverse 参数是全局生效的,无法单独对某一列取反。此时可以利用以下两种核心方案:
# 班级升序 (s["class"]),成绩降序 (-s["score"])
res_mixed = sorted(students, key=lambda s: (s["class"], -s["score"]))
for item in res_mixed:
    print(item)
# 示例输出:
# {'class': 1, 'name': 'Alice', 'score': 92}
# {'class': 1, 'name': 'Charlie', 'score': 85}
# {'class': 2, 'name': 'Bob', 'score': 85}
# {'class': 2, 'name': 'David', 'score': 85}# 目标:按 name 降序,再按 class 升序
# 步骤 1:先按次要键 name 排序(降序)
step1 = sorted(students, key=lambda s: s["name"], reverse=True)
# 步骤 2:再按主要键 class 排序(升序)
final_res = sorted(step1, key=lambda s: s["class"])五、复杂规则与传统比较器桥梁:functools.cmp_to_key
在 Python 2 中,排序允许传入 cmp(a, b) 双参数比较函数。当 a < b 时返回负数,a == b 返回 0,a > b 返回正数。然而,在 Python 3 中,cmp 参数被彻底移除。这是因为两两对比机制在每次元素比对时都要执行一次转换计算,总计算量高达 $O(N \log N)$ 次;而现代 key 机制仅需 $O(N)$ 次计算。
但是,当排序规则高度依赖两个元素之间的上下文关联,无法抽象成单个元素的独立键值时(例如经典算法题“将一组正整数拼接成最大的数字”:判断 str(a) + str(b) 与 str(b) + str(a) 的相对大小),Python 提供了 functools.cmp_to_key 作为适配器。
from functools import cmp_to_key

# 经典案例:拼接最大数
nums = [3, 30, 34, 5, 9]

def compare_combine(x, y):
    # 如果 y+x 组合字符串更大,说明 y 应该排在 x 前面(即 x 应该在后,返回 1)
    if str(x) + str(y) > str(y) + str(x):
        return -1  # 降序排列,x 优先
    elif str(x) + str(y) < str(y) + str(x):
        return 1
    else:
        return 0

# 使用 cmp_to_key 转换为合法的 key 函数
sorted_nums = sorted(nums, key=cmp_to_key(compare_combine))
print("拼接最大数排序序列:", sorted_nums)
# 示例输出:拼接最大数排序序列: [9, 5, 34, 3, 30]
print("最终最大数字:", "".join(map(str, sorted_nums)))
# 示例输出:最终最大数字: 9534330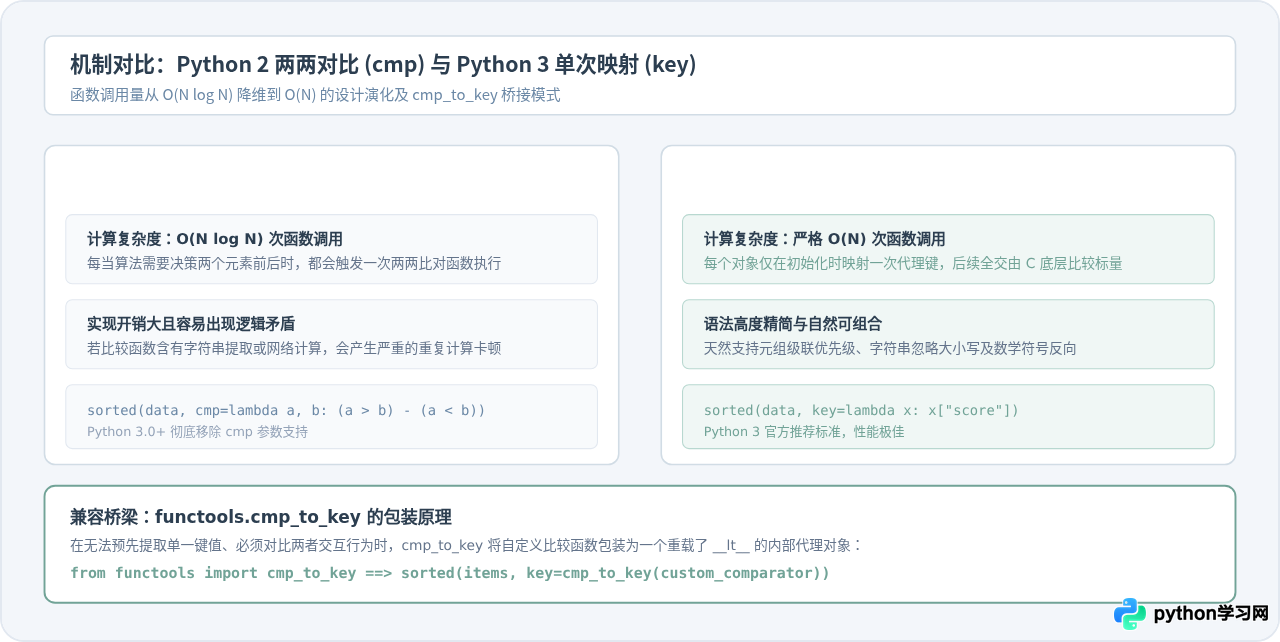
六、避坑要点与注意事项
在使用 sorted() 实现自定义排序时,以下几个关键边界条件和行为细节极易引发线上 Bug 或性能隐患:
| 避坑维度 | 常见错误与现象 | 正确处理方法 |
|---|---|---|
| 原地排序 vs 产生新列表 | 写出 items = items.sort() 导致变量变成 None |
list.sort() 是列表原地方法,返回 None;内置函数 sorted(items) 总是返回全新列表,不改变原对象。 |
| 类型不可比异常 | 列表中混有 None 或数字与字符串,抛出 TypeError: '<' not supported |
在 key 函数中做好类型归一化。例如将 None 转化为极小值或极大值:key=lambda x: (x is not None, x)。 |
| Key 函数内的繁重操作 | 在 key 函数中读取文件、请求外部接口或执行深拷贝 |
key 函数虽然只执行 $N$ 次,但如果 $N$ 很大仍会阻塞主线程。应先在外部预处理数据,再传入纯内存键值。 |
| 多维混合排序的负号限制 | 对非数值类型(如字符串或日期对象)直接加负号 -x["name"] 导致 TypeError |
非数值类型的反向排序应通过多轮次稳定排序分别处理,或通过 cmp_to_key 编写明确的反向逻辑。 |
七、总结
掌握 sorted() 自定义排序的精髓可以概括为以下三条黄金准则:
- 单一键优先用内置与 operator:简单属性提取优先使用
itemgetter和attrgetter,既直观又享受底层加速;快速变换使用lambda。 - 多条件排序优先用元组:通过元组打包实现多层级优先权,数值字段加负号可快速反转该列排序方向。
- 始终牢记返回值与稳定性:
sorted()永远创建新列表,原数据不受干扰;其内置的 Timsort 算法保证相同键元素的相对顺序严格稳定,为分步链式排序提供了坚实保障。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









