

NumPy genfromtxt处理CSV缺失值与非数值数据的方法
系统介绍使用NumPy的genfromtxt函数解析复杂CSV文件的方法,全面解决缺失值填充、非数值文本转换、编码处理以及结构化数组映射等关键技术问题。
在利用 Python 进行科学计算与工程分析时,读取外部 CSV 格式表格是极为频繁的基础步骤。标准的 numpy.loadtxt 针对纯数值且结构整齐的规则数据有极高的读取速度,但当遇到真实世界中夹杂空字段、文本标签、非规范日期或缺失记号的 CSV 数据时,便会频繁抛出类型转换失败与维度不匹配的异常。NumPy 针对此类容错场景提供了专门的双扫描解析器 numpy.genfromtxt。本文将围绕 genfromtxt 的解析逻辑展开,详细说明如何使用其内置参数与函数钩子,精确解决数据缺失与非数值混合这两大阻碍数据导入的核心问题。
一、认识 genfromtxt 的底层解析机制
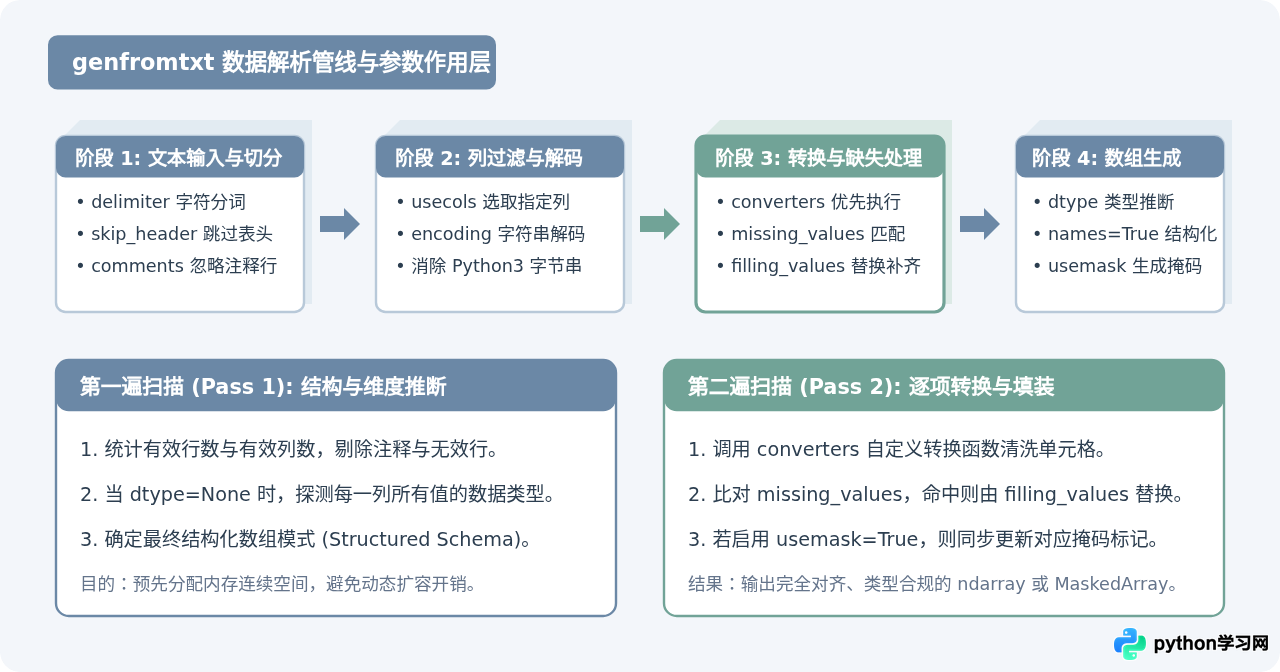
np.loadtxt 与 np.genfromtxt 最核心的差异在于执行逻辑。loadtxt 采用单遍扫描,假设输入文件的每一行格式严格一致,遇到无法直接转换为指定 dtype 的字符即刻报错中断。而 genfromtxt 内部实现了清晰的两遍扫描(Two-pass)机制:
- 第一遍扫描:按行遍历文件,计算总行数、有效列数,跳过通过
skip_header和comments指定的无效内容。如果在读取时指定了dtype=None,系统会在该阶段分析各列的内容特征,推断其最适合的数据类型(如整型、浮点型、布尔型或字符串)。 - 第二遍扫描:根据第一遍确立的模式分配连续内存块,逐行执行转换逻辑。针对每一列,依次经过用户自定义的
converters、缺失值规则匹配missing_values,以及默认值填补filling_values,最终把合格数据填装到预定结构中。
因此,掌握 genfromtxt 的关键在于弄清楚各个参数在第二遍扫描中的介入顺序与协作边界。
二、处理 CSV 中的缺失值:从默认填充到掩码数组
缺失值在 CSV 文件中通常有两种表现形式:连续的逗号导致单元格为空字符串(如 12, ,45.8),或者使用特定字符占位(如 NA、N/A、NULL、-999)。如果不做配置,genfromtxt 默认会把空单元格视为缺失值,但针对非空标记则需要用户显式声明。
1. 默认填充行为与 filling_values 的使用
当 genfromtxt 发现缺失值且未开启掩码时,会使用预设规则进行静默填充:浮点数列填充 np.nan,整数列填充 -1,字符串列填充 b'???'。这种整型默认填入 -1 的做法在实际统计中极易引起歧义,因此应当使用 filling_values 参数明确指定补全策略。
import numpy as np

# 模拟含有空值的 CSV 文本内容
csv_data = """id,score,category
1,88.5,A
2,,B
3,95.0,
4,72.3,C"""

from io import StringIO

# 统一填充:所有缺失均替换为 -999.0
data_uniform = np.genfromtxt(
    StringIO(csv_data),
    delimiter=',',
    skip_header=1,
    filling_values=-999.0
)
print("统一填充结果:\n", data_uniform)
2. 按列差异化指定填充值与自定义缺失标记
各数据列往往代表不同的业务物理量。例如第一列 ID 不应出现缺失,第二列成绩缺失建议填补该列均值或中位数,第三列类别缺失应当填补固定字符。missing_values 与 filling_values 均支持传入字典,以列索引作为键分别定制:
# 按列指定缺失标识与补充值
data_custom = np.genfromtxt(
    StringIO(csv_data),
    delimiter=',',
    skip_header=1,
    dtype=None,
    encoding='utf-8',
    missing_values={1: '', 2: ''},       # 第1列和第2列以空字符串作为缺失依据
    filling_values={1: 0.0, 2: 'Unknown'} # 第1列填 0.0,第2列填 'Unknown'
)
print("差异化列填充结果:\n", data_custom)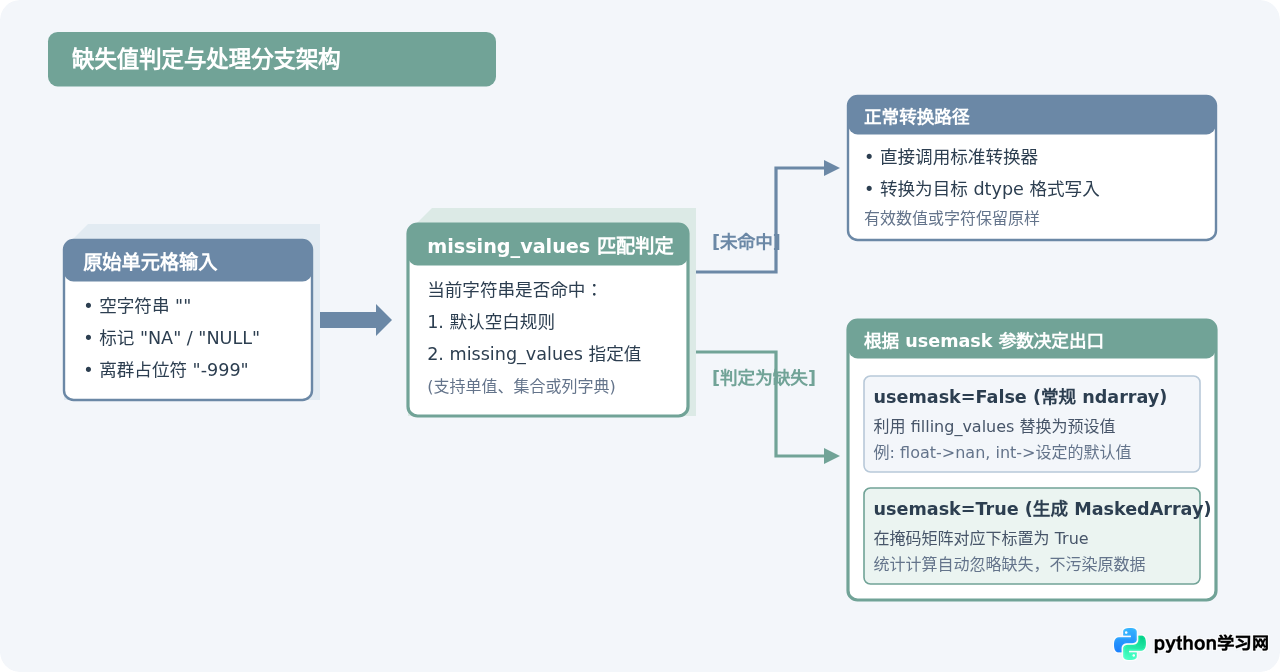
3. 使用掩码数组避免填充“伪数据”
在严谨的统计分析中,填入 0 或 -1 容易对后续的均值、极值及方差计算造成严重干扰;而全浮点填入 np.nan 则无法保留原始整型语义。对此,设置 usemask=True 是最佳方案。它会返回一个 np.ma.MaskedArray,缺失处自带布尔掩码,进行 mean()、sum() 等运算时会自动规避缺失位置:
# 启用掩码数组读取
masked_data = np.genfromtxt(
    StringIO(csv_data),
    delimiter=',',
    skip_header=1,
    usecols=(0, 1),
    usemask=True
)
print("掩码数组对象:\n", masked_data)
# 掩码计算会自动跳过缺测值
print("计算均值(自动排除缺失):", masked_data[:, 1].mean())
三、处理非数值数据:自动推断与结构化字段
CSV 中经常包含字符串(如姓名、类别代码、状态说明)。标准 NumPy 二维数组要求所有元素具备同构类型,若包含字符串,整个数组会被迫向上兼容为大型字符类型(如 <U32),导致所有数值无法进行数学运算。解决非数值数据有两条标准路径。
1. 自动推断与结构化模式:dtype=None
设置 dtype=None 会激活内部类型推断,NumPy 会将数据转为一维“结构化数组”(Structured Array),每一列具有独立的类型。在 Python 3 中,必须同时指定 encoding='utf-8'(或文件实际编码),否则解析出的文本会变成 Python 字节串(形如 b'A')。配合 names=True 还可以自动将第一行转为字段名访问:
# 包含结构化表头的 CSV 样例
mixed_csv = """student_id,name,math_score,pass_flag
101,Alice,92.5,True
102,Bob,64.0,True
103,Charlie,48.5,False"""

structured_data = np.genfromtxt(
    StringIO(mixed_csv),
    delimiter=',',
    names=True,        # 提取第一行为字段名称
    dtype=None,        # 启用全列自动类型推断
    encoding='utf-8'   # 正确解码字符串,避免产生 b'...'
)

print("结构化字段列表:", structured_data.dtype.names)
print("提取姓名列:", structured_data['name'])
print("数学成绩平均分:", structured_data['math_score'].mean())
2. 手动指定结构化模式(精确控制内存与精度)
自动推断在遇到大数据文件时会因为第一遍全量扫描带来性能消耗。若预先了解列的分布,推荐显式指定 dtype 复合类型,例如由字段名和类型字符组成的元组列表:
custom_dtype = [
    ('student_id', 'i4'),      # 4字节有符号整型
    ('name', 'U10'),           # 最多10个字符的Unicode字符串
    ('math_score', 'f8'),      # 8字节双精度浮点
    ('pass_flag', '?')         # 布尔型
]

precise_data = np.genfromtxt(
    StringIO(mixed_csv),
    delimiter=',',
    skip_header=1,
    dtype=custom_dtype,
    encoding='utf-8'
)
print("显式指定模式结果:\n", precise_data['math_score'])
四、使用 converters 参数实现灵活字段清洗
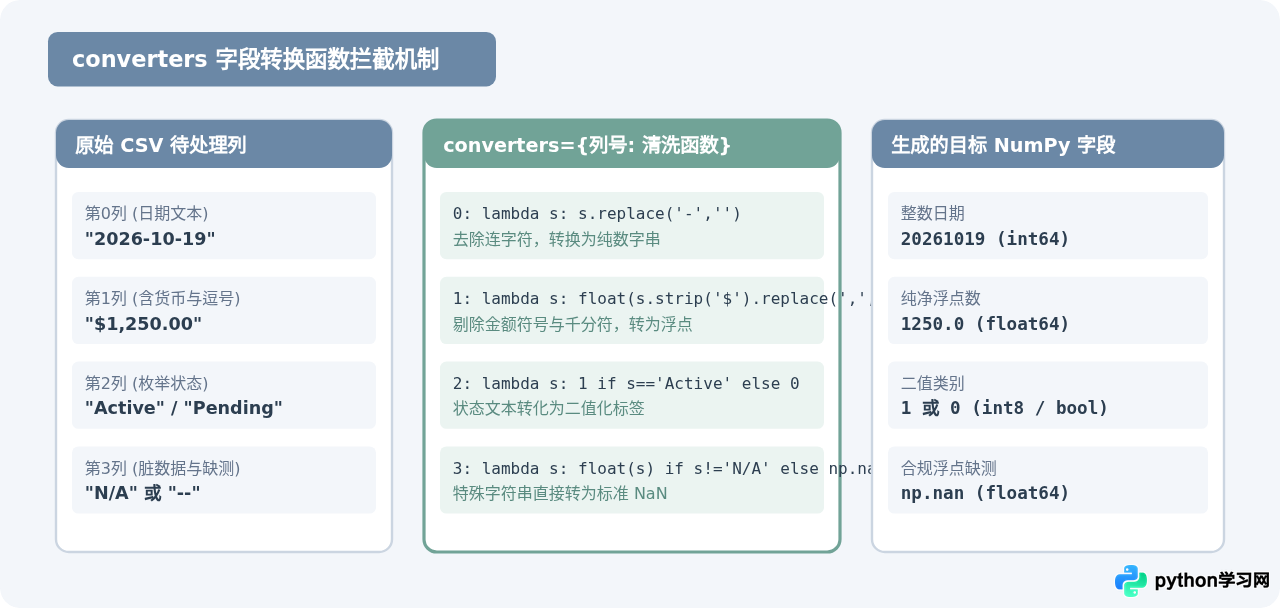
现实中的非数值数据往往不规范,例如带有货币符号的金额($1,250.00)、带百分号的比率(15.8%)、多格式日期(2026-10-19)或枚举缩写(M/F)。这些数据无法直接被标准解析器识别为数值,此时必须依靠 converters 参数。
converters 接收一个字典,其键为列的索引(从 0 开始),值为对应的转换函数。需要特别注意:在内部扫描中,传入转换函数的内容为原始解码后的字符串,转换函数必须直接返回合规的目标格式。
实战示例:利用 converters 进行复合清洗
下面是一个包含货币格式、日期格式及异常占位符的典型复杂清洗示例:
raw_records = """order_date,amount,status,satisfaction
2026-03-01,"$1,200.50",PAID,5
2026-03-02,"$850.00",UNPAID,N/A
2026-03-03,,PAID,4
2026-03-04,"$2,100.25",REFUND,1"""

# 定义各列专用的转换函数
def parse_currency(val):
    val = val.strip()
    if not val:
        return 0.0  # 空值直接填补 0.0
    # 剥离货币符号和千分位分隔符
    clean_str = val.replace('$', '').replace(',', '')
    return float(clean_str)

def parse_satisfaction(val):
    val = val.strip()
    if val in ('N/A', '', 'NULL'):
        return np.nan
    return float(val)

# 调用 genfromtxt 并挂载 converters
orders_array = np.genfromtxt(
    StringIO(raw_records),
    delimiter=',',
    skip_header=1,
    encoding='utf-8',
    dtype=None,
    names=True,
    converters={
        1: parse_currency,       # 第1列金额清洗
        3: parse_satisfaction    # 第3列评分清洗
    }
)

print("提取金额序列:", orders_array['amount'])
print("金额均值计算:", orders_array['amount'].mean())
print("提取满意度评分:", orders_array['satisfaction'])注意优先级陷阱:当某一列配置了 converters 时,该列的单元格在第二遍扫描中会直接交由转换函数处理,而不会触发 missing_values 和 filling_values 的自动替换。因此,若该列存在空值,转换函数内部必须自行包含对空字符串 if not val: 的容错判断。
五、综合实战:多类型混合 CSV 的完整导入范例
为了将以上所有技术点串联起来,我们模拟一个包含表头、注释、非数值文本、货币、带空值的典型工业 CSV 场景:
# 设备运行监控记录 (包含注释与缺失字段)
log_data = """# 站点:北京机房01区
# 采集时间:2026-10-19
device_id,temperature,power_kw,status_code,memo
DEV_001,24.5,12.8,0,Normal
DEV_002,NA,15.2,1,Overheat Warning
DEV_003,26.1,,0,Normal
# DEV_004,38.0,20.1,2,Offline
DEV_005,22.0,9.5,0,"""

# 清洗与导入脚本
parsed_log = np.genfromtxt(
    StringIO(log_data),
    delimiter=',',
    comments='#',             # 过滤以 # 开头的注释
    names=True,                # 读取首个有效行为字段名
    dtype=None,                # 自动推断基础字段类型
    encoding='utf-8',          # 统一字符集编码
    missing_values={'temperature': 'NA', 'power_kw': ''},
    filling_values={'temperature': -999.0, 'power_kw': 0.0},
    converters={
        'memo': lambda s: s.strip() if s.strip() else 'No_Remarks'
    }
)

print("导入成功的结构化字段:", parsed_log.dtype.names)
print("设备ID列表:", parsed_log['device_id'])
print("处理后的温度:", parsed_log['temperature'])
print("处理后的功率:", parsed_log['power_kw'])
print("补全后的备注:", parsed_log['memo'])
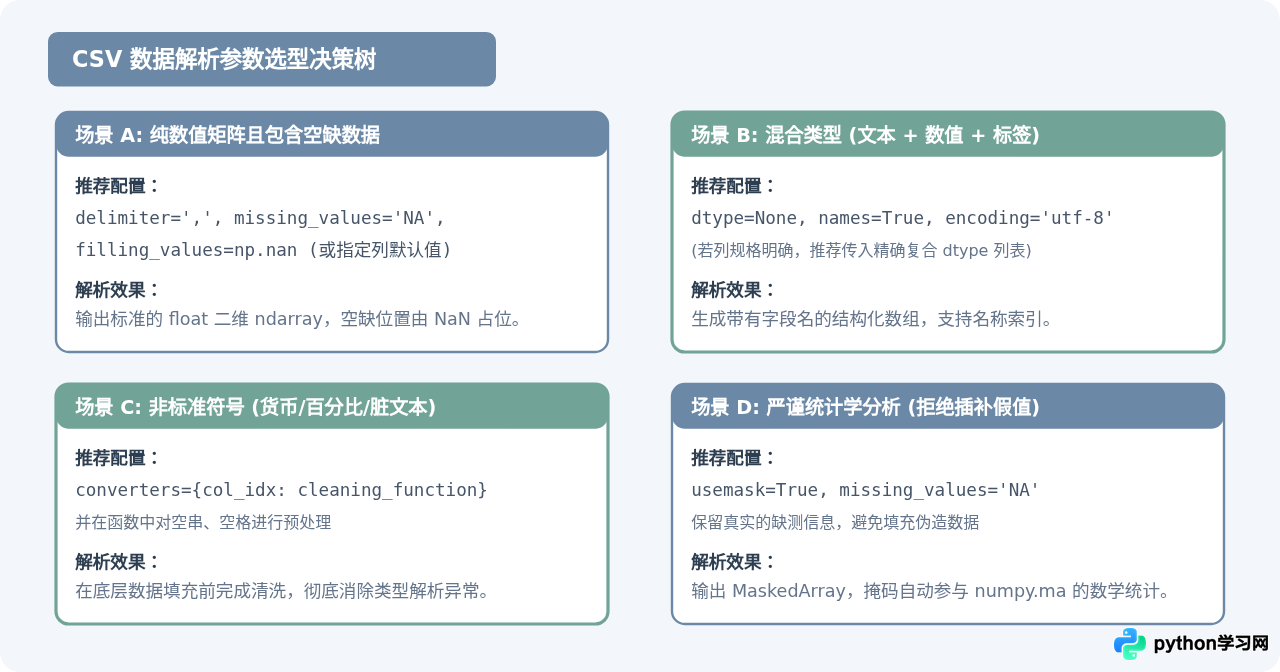
六、核心参数与选型决策速查
面对不同的 CSV 数据特征,合理组合参数可以事半功倍。下表总结了常用参数的职能边界:
| 参数名称 | 典型输入值 | 核心功能说明 | 适用场景 |
|---|---|---|---|
delimiter |
',' 或 '\t' |
指定列分隔符号,支持单字符或固定宽度列表 | 绝大部分非单空格分隔的表格数据 |
skip_header |
整数 (如 1) |
在开始解析数据前跳过文件开头的指定行数 | 有表头但不打算作为结构化字段名时 |
names |
True 或 字段名列表 |
将第一行作为列名或手动赋予每列名称 | 构建可按列名直接检索的结构化数组 |
dtype |
None 或复合结构列表 |
指定整体类型或触发自动推断 (Two-pass) | 存在文本、布尔值或多类型混合列时 |
encoding |
'utf-8' 或 'gbk' |
指定文本解码格式 | Python 3 中读取任何包含中文/字符的 CSV 文件 |
missing_values |
字符串或字典 {列号: 'NA'} |
定义触发缺失逻辑的特定标记 | CSV 使用非空字符(如 NULL、--)占位时 |
filling_values |
标量值或字典 {列号: 0.0} |
定义缺失位置替换写入的默认值 | 需要对缺失值进行标准化插补时 |
usemask |
True / False |
是否生成自带掩码的 MaskedArray | 需要严格保留缺失状态、防止伪值参与运算时 |
converters |
字典 {列号: 处理函数} |
挂载针对特定列的原生转换与清洗钩子 | 含有货币符号、千分符、复杂格式或业务编码时 |
七、常见注意事项与排错指南
- 避免整型列默认填入 -1:当某一列被判定为整数类型而未显式指定
filling_values时,genfromtxt默认会以-1填充空位。如果该列原本包含非负数(如年龄、计数值),-1会被误当作合法值参与后续计算。建议对可能存在缺失的数值列显式指定filling_values=np.nan并将该列类型设为浮点。 - Python 3 下的字符串字节串问题:如果不显式声明
encoding='utf-8'(或对应实际文件编码),即使设置了dtype=None,解析器在 Python 3 中依然会把文本读取为bytes类型(例如b'Alice'而非'Alice')。在后续进行字符串比对或字典映射时会导致条件失败。 - 内存占用与超大文件限制:
genfromtxt由于采用纯 Python 解析层配合两遍扫描,在灵活性上极佳,但处理上千万行或者数个吉字节(GB)的超大型 CSV 文件时,解析耗时和内存开销相对显著。若遇到超大规模混合表格,应优先考虑使用pandas.read_csv或polars.read_csv;而在轻量级工程、嵌入式场景或严格依赖标准 NumPy 的轻量计算流程中,genfromtxt依然是最稳定、无需额外三方重型依赖的首选方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









