

python必背源代码属性property代码
深入解析Python中@property属性装饰器的核心机制与必背源代码模板,涵盖Getter、Setter、Deleter完整写法、数据校验、只读计算属性以及避免递归死循环的避坑指南。
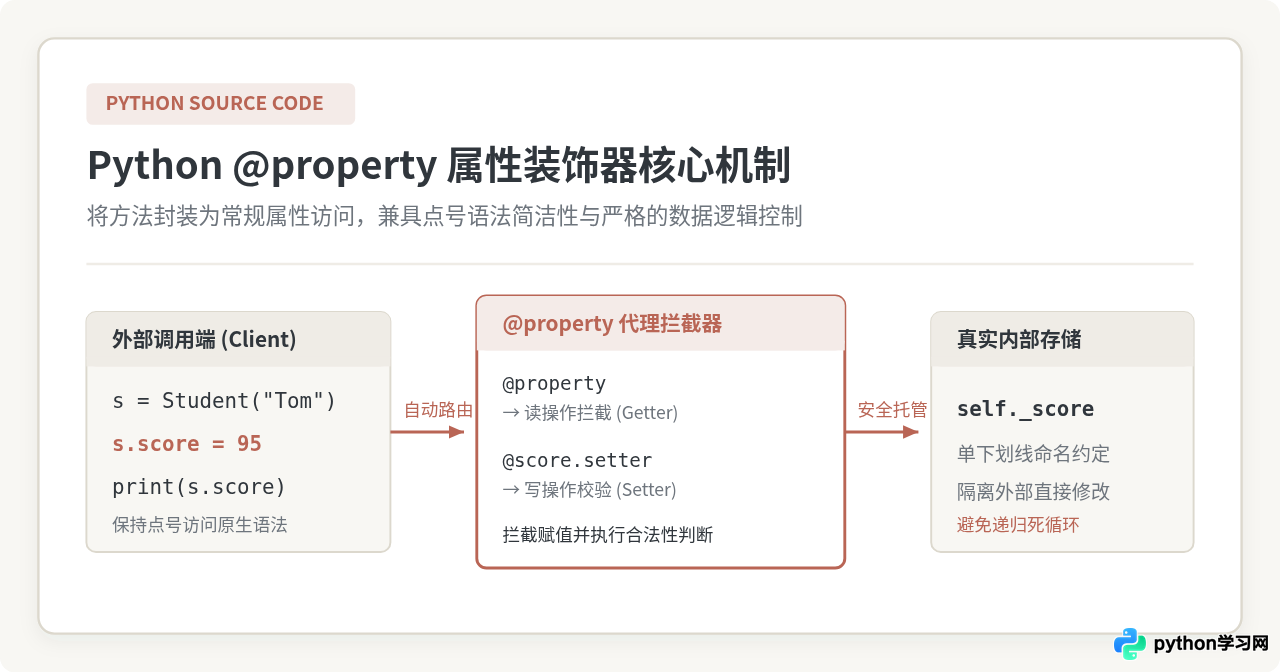
@property 是一段必须熟练背诵并规范落地的核心源代码模板。它通过将类方法转换为常规属性访问语法,既保留了直接使用点号读取或赋值(例如 obj.score = 95)的简洁性,又赋予了开发者在底层插入数据校验、动态计算与访问拦截的完全控制权。掌握其标准代码结构,是编写高质量、工程化 Python 类的基石。
一、为什么 @property 是面向对象编程中的必背代码
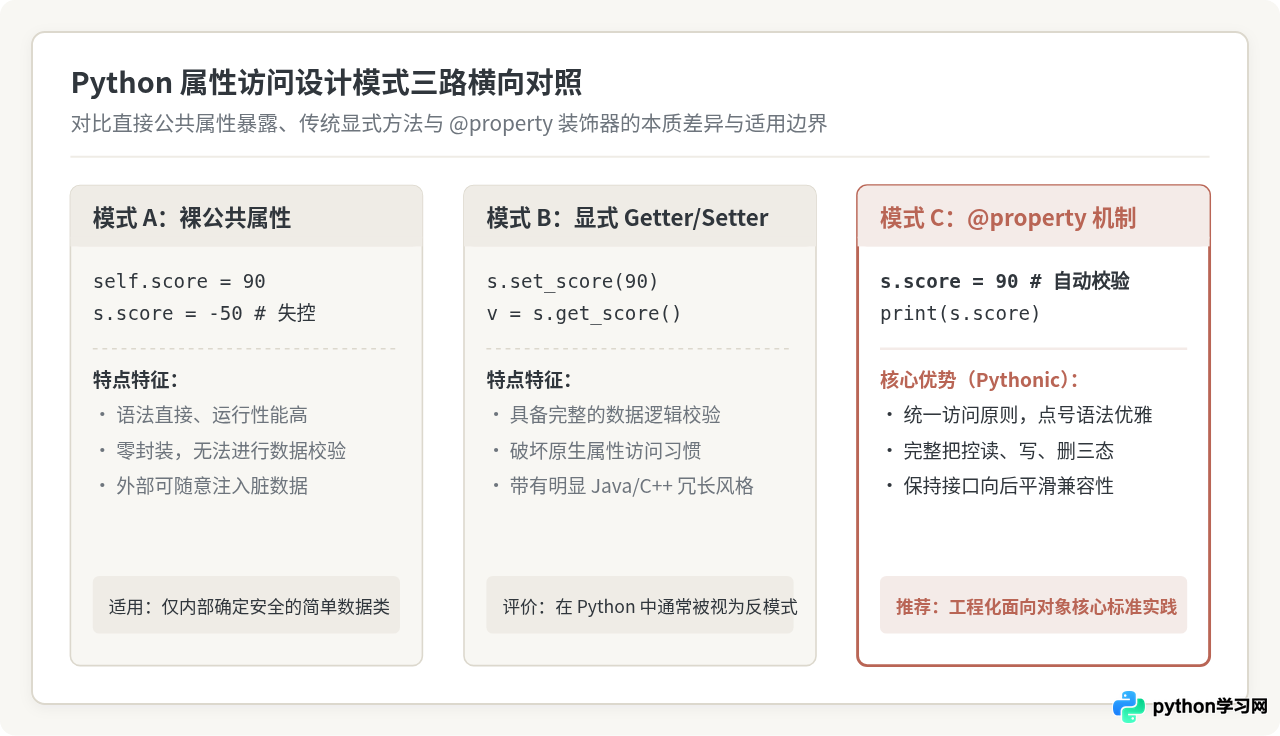
在许多传统面向对象语言(如 Java 或 C++)中,为了保护对象内部状态,开发者通常将属性设为私有,并显式编写成对的 get_value() 和 set_value() 方法。然而在 Python 中,如果一开始就为每一个属性编写冗长的 getter 与 setter 方法,不仅让代码显得繁琐,也背离了 Pythonic 的简洁美感。
若直接将属性公开为普通字段(例如 self.score = 90),初期调用虽然简短,但一旦后续业务要求“分数必须介于 0 到 100 之间”时,直接暴露字段将彻底丧失拦截能力。此时如果中途改为 s.set_score(90),所有已经调用该类的外部业务代码都必须同步修改,破坏了向后兼容性。
@property 完美解决了这个两难问题:它遵循“统一访问原则”(Uniform Access Principle)。调用方始终像访问普通属性一样书写代码,而类的编写者可以在不变更调用接口的前提下,随时在底层装配验证与拦截逻辑。
二、核心必背源代码模板:标准实现与逐行剖析
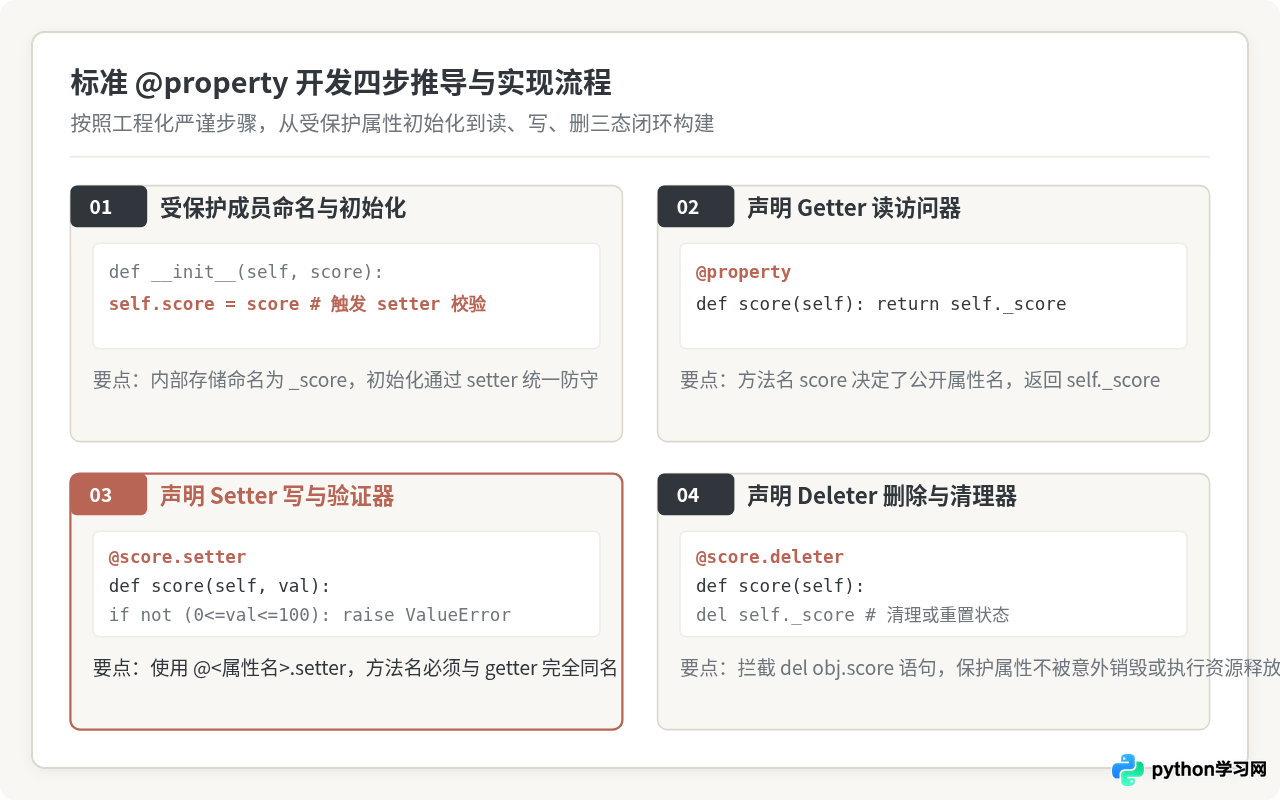
生产环境下最标准、最完备的 property 实现包含四个核心组成部分:构造方法拦截、读取器(Getter)、修改器(Setter)以及删除器(Deleter)。以下是需要完整记忆的标准范式:
class Student:
    def __init__(self, name: str, score: float):
        self.name = name
        # 注意:此处直接赋值给 self.score,统一走 setter 校验,防止初始化绕过检查
        self.score = score

    # 1. 读访问器 (Getter)
    @property
    def score(self) -> float:
        """获取学生成绩"""
        return self._score

    # 2. 写访问器与数据校验 (Setter)
    @score.setter
    def score(self, value: float) -> None:
        """设置学生成绩,包含严格的类型与数值范围校验"""
        if not isinstance(value, (int, float)):
            raise TypeError(f"成绩必须为数值类型,当前传入: {type(value).__name__}")
        if not (0.0 <= value <= 100.0):
            raise ValueError(f"成绩超出合理范围 [0, 100],当前传入: {value}")
        self._score = float(value)

    # 3. 删除访问器 (Deleter)
    @score.deleter
    def score(self) -> None:
        """清理成绩属性"""
        print(f"[Deleter] 正在清理学生 {self.name} 的成绩记录")
        del self._score
该模板代码的各部分职能解析如下:
- 真实私有属性
self._score:变量名前添加单下划线,作为内部受保护属性存放实际数据。外部或内部公开交互只通过无下划线的属性名score进行。 - 只读装饰器
@property:将紧随其后的def score(self)注册为 Getter。当外部读取s.score时,Python 底层自动执行该函数。 - 赋值装饰器
@score.setter:格式为@<属性名>.setter。前缀必须与先前定义的 Getter 函数名完全一致,方法签名必须接收两个参数:self与待写入的值value。 - 删除装饰器
@score.deleter:拦截del s.score操作。在需要执行资源回收、缓存注销或敏感状态重置时使用。若未定义 deleter,执行del将直接抛出AttributeError。
代码调用与运行结果示例
使用上述标准类执行正常的创建、读取、合法赋值、非法拦截与删除操作:
# 正常操作示例
s = Student("李华", 88.5)
print(f"学生姓名: {s.name}, 成绩: {s.score}")

# 修改属性(合法)
s.score = 96.0
print(f"更新后成绩: {s.score}")

# 删除属性
del s.score更新后成绩: 96.0
[Deleter] 正在清理学生 李华 的成绩记录
当外部传入不合法参数时,setter 将立即阻断写入并抛出明确异常:
# 非法赋值示例(触发边界拦截)
try:
    s = Student("王强", 120)
except ValueError as e:
    print(f"捕获预期异常: {e}")

try:
    s = Student("张伟", 90)
    s.score = "优秀"  # 类型错误
except TypeError as e:
print(f"捕获预期异常: {e}")捕获预期异常: 成绩必须为数值类型,当前传入: str
三、三大核心实战场景与必背扩展代码
在实际工程开发中,@property 主要衍生出三种关键应用模式:只读动态计算、数据约束防护,以及耗时操作的惰性求值。
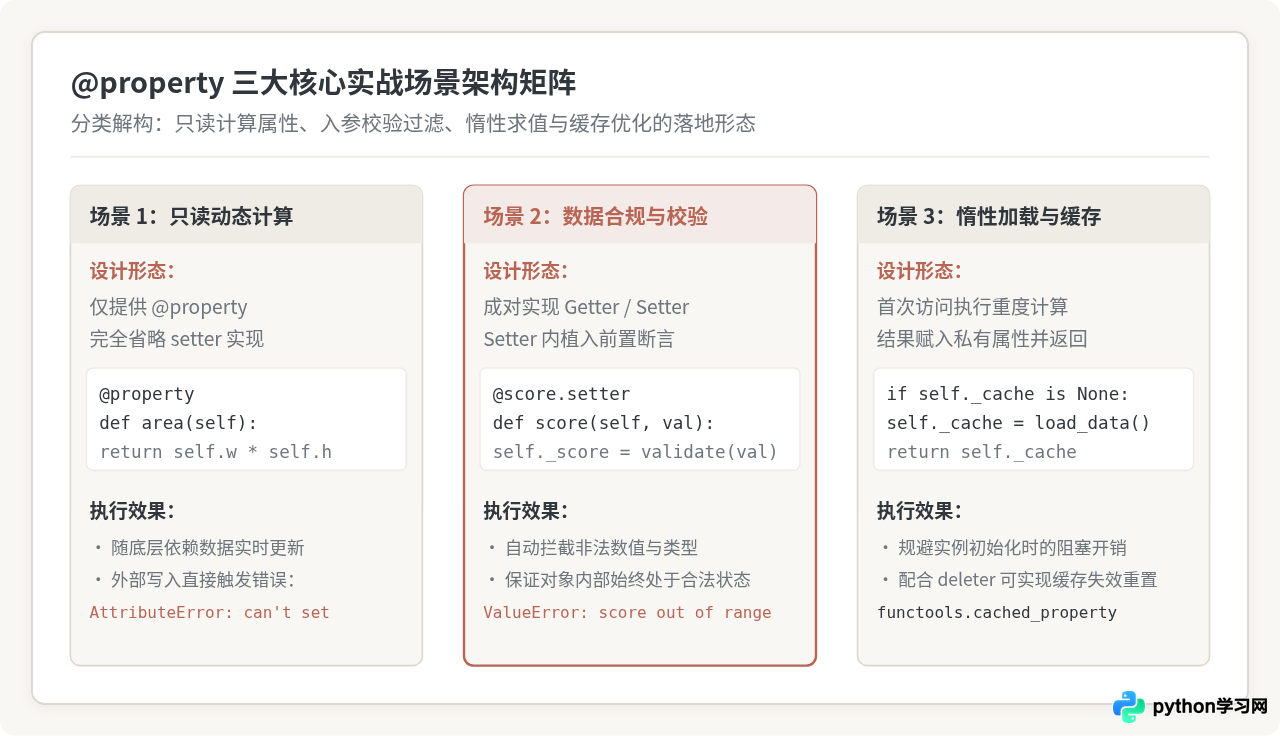
场景 1:只读动态计算属性(不声明 setter)
当某个属性的值完全依赖于实例的其他基础字段时,将其设计为只读计算属性最为合适。这样既避免了在每个修改点手动同步维护冗余字段,又防止了外部随意篡改。
class Rectangle:
    def __init__(self, width: float, height: float):
        self.width = width
        self.height = height

    # 动态只读属性:面积
    @property
    def area(self) -> float:
        return self.width * self.height

    # 动态只读属性:周长
    @property
    def perimeter(self) -> float:
        return 2 * (self.width + self.height)

rect = Rectangle(4.0, 5.0)
print(f"初始面积: {rect.area}")  # 输出 20.0

rect.width = 10.0
print(f"宽度变更后面积自动重算: {rect.area}")  # 输出 50.0

# 尝试对只读属性直接赋值
try:
    rect.area = 100.0
except AttributeError as err:
print(f"赋值失败提示: {err}")宽度变更后面积自动重算: 50.0
赋值失败提示: property 'area' of 'Rectangle' object has no setter
场景 2:数据合规与格式标准化
在写入属性前对输入值进行清洗与格式归一化。例如邮箱统一小写、手机号去除空格与连字符、金额精度自动截断保留等:
class UserProfile:
    def __init__(self, email: str):
        self.email = email

    @property
    def email(self) -> str:
        return self._email

    @email.setter
    def email(self, raw_email: str) -> None:
        if not isinstance(raw_email, str):
            raise TypeError("邮箱必须为字符串")
        cleaned = raw_email.strip().lower()
        if "@" not in cleaned or "." not in cleaned.split("@")[-1]:
            raise ValueError(f"邮箱格式无效: {raw_email}")
        self._email = cleaned

user = UserProfile("  Alex.Tech@EXAMPLE.Com  ")
print(f"清洗归一化后的邮箱: {user.email}")场景 3:惰性加载与结果缓存(Lazy Property)
对于耗时计算、网络请求或文件读取,我们希望在首次访问属性时才执行计算,并将结果缓存到内部私有变量中,后续读取直接命中缓存;同时通过 deleter 具备主动刷新缓存的能力:
import time

class DataReport:
    def __init__(self, dataset_id: str):
        self.dataset_id = dataset_id
        self._summary_cache = None

    @property
    def summary(self) -> dict:
        """首次访问时耗时聚合,后续读取直接使用缓存"""
        if self._summary_cache is None:
            print("[Calc] 正在执行大型数据集统计运算...")
            time.sleep(0.5)  # 模拟耗时统计操作
            self._summary_cache = {"id": self.dataset_id, "row_count": 100000, "status": "ok"}
        return self._summary_cache

    @summary.deleter
    def summary(self) -> None:
        """清除缓存,触发下一次重新计算"""
        print("[Cache] 清除缓存数据")
        self._summary_cache = None

report = DataReport("D-2026-X")
# 第一次读取:触发运算
print(report.summary)
# 第二次读取:直接返回内存缓存
print(report.summary)
# 重置缓存并重新获取
del report.summary
print(report.summary){'id': 'D-2026-X', 'row_count': 100000, 'status': 'ok'}
{'id': 'D-2026-X', 'row_count': 100000, 'status': 'ok'}
[Cache] 清除缓存数据
[Calc] 正在执行大型数据集统计运算...
{'id': 'D-2026-X', 'row_count': 100000, 'status': 'ok'}
functools.cached_property 装饰器,专门用于无参的纯只读缓存属性。如果无需手动编写 setter 或复杂的 deleter 控制,推荐优先使用标准库内置的 cached_property。
四、原理进阶:property() 函数式语法
平时我们常用 @property 装饰器,实际上装饰器语法是内置函数 property() 的语法糖。在查看 Python 底层源码或阅读早期经典框架时,经常能见到原生函数式写法:
class VoltageSensor:
    def __init__(self, voltage: float):
        self._voltage = voltage

    def _get_voltage(self) -> float:
        return self._voltage

    def _set_voltage(self, val: float) -> None:
        if val < 0:
            raise ValueError("电压不能为负数")
        self._voltage = val

    def _del_voltage(self) -> None:
        del self._voltage

    # 使用函数式构造完整的属性对象
    # 签名格式: property(fget=None, fset=None, fdel=None, doc=None)
    voltage = property(_get_voltage, _set_voltage, _del_voltage, "传感器电压读数(V)")

sensor = VoltageSensor(220.0)
print(f"当前电压: {sensor.voltage} V")
sensor.voltage = 380.0
print(f"调压后: {sensor.voltage} V")
print(f"属性文档: {VoltageSensor.voltage.__doc__}")
装饰器语法与函数式写法在底层生成的描述符对象完全等价。理解这一层关系,有助于读者透彻领悟 Python 中“一切皆对象”以及描述符协议(Descriptor Protocol,即 __get__、__set__、__delete__)的本质。
五、关键陷阱与排查清单
在编写 property 代码时,初学者甚至有经验的开发者都极易踩入几个高频陷阱,其中最具破坏性的是 Setter 内部的无限递归。
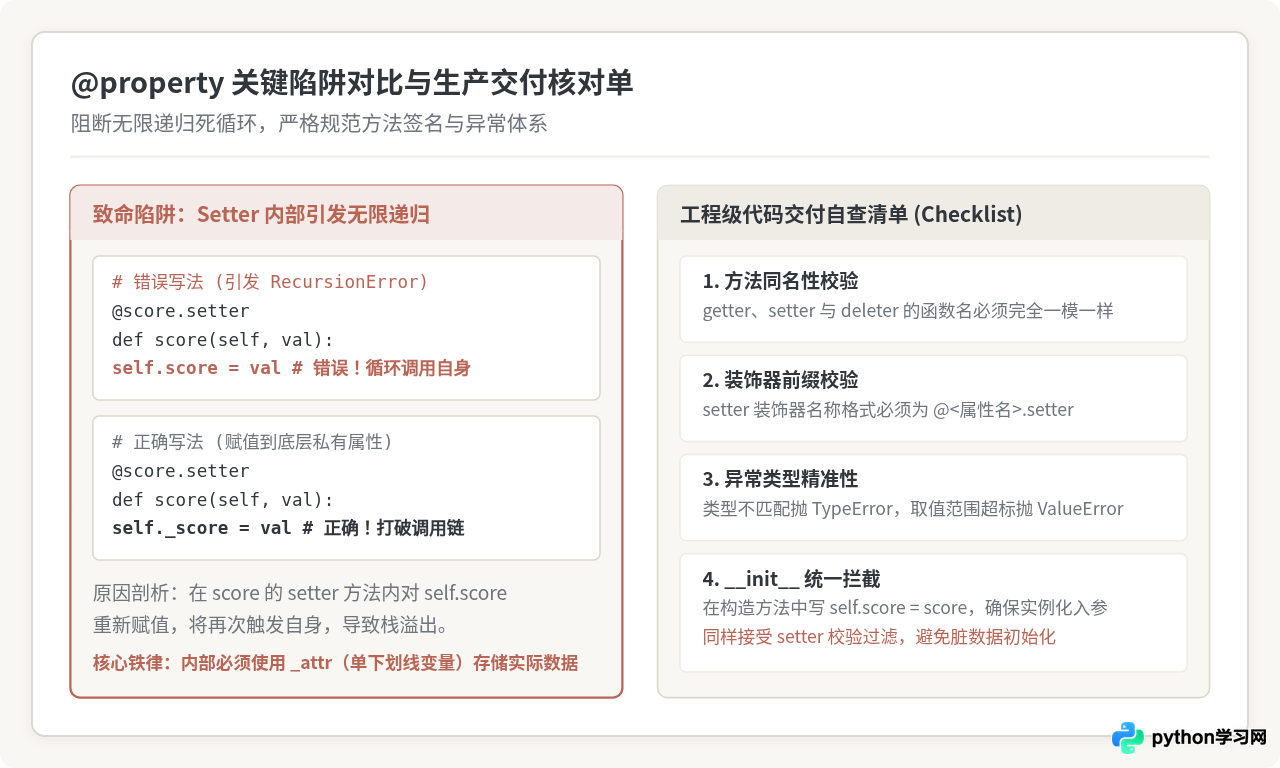
陷阱 1:Setter/Getter 内部误用公共属性名导致无限递归
这是 property 最经典的报错原因。在 score 的 setter 方法中,如果错误地将赋值写为 self.score = value,该语句本身又会触发 setter,从而陷入自我调用的死循环,最终抛出:
避坑准则:类内部必须保留一个名字略有差异的变量用来实际存值(通常加单下划线前缀,例如 self._score)。在 getter 与 setter 内部,一律操作带下划线的内部变量 self._score。
陷阱 2:函数名不一致或装饰器前缀写错
使用装饰器定义时,Getter、Setter 与 Deleter 的方法名必须完全保持一致。以下为典型错误示范:
# 错误示例:方法名不统一
@property
def get_score(self):      # 错误:命名为了 get_score
    return self._score

@score.setter             # 报错:NameError: name 'score' is not defined
def set_score(self, val):
    self._score = val
避坑准则:全部统一使用最终期望暴露的属性名 score,前缀装饰器也必须严格书写为 @score.setter。
陷阱 3:在 __init__ 中跳过 setter 校验
有些开发者在 __init__ 中直接书写 self._score = score,这会导致在对象实例化创建时,即使传入了非法参数(例如负数),也不会经过 setter 的逻辑拦截,使得脏数据悄悄进入系统。
避坑准则:在 __init__ 中优先使用 self.score = score(不带下划线),让构造过程直接经过 setter 进行防守。
六、生产级速查对比表
| 特性维度 | 直接公共属性 (self.x) | 显式方法 (get_x / set_x) | @property 装饰器 (推荐) |
|---|---|---|---|
| 调用语法 | obj.x = 10 |
obj.set_x(10) |
obj.x = 10 |
| 数据输入校验 | 无法拦截,零防守 | 完全支持 | 完全支持,内部平滑拦截 |
| 只读属性控制 | 不支持 | 通过不提供 set 方法实现 | 仅声明 @property 即可锁定只读 |
| 重构兼容性 | 一旦改为方法则破坏旧代码 | 良好,但初始调用代码冗长 | 最高,支持从普通字段无缝平滑升级 |
| Pythonic 程度 | 适用于简单纯数据载体 | 偏冗长,不符合惯用风格 | 符合官方标准库与主流框架首选规范 |
掌握 @property 的核心模板,是写出优雅、健壮、可维护 Python 面向对象代码的必备基本功。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









