

Python sorted函数key参数详解:怎么实现自定义排序
深入讲解 Python sorted() 函数的 key 参数原理与实战用法。从单参数键提取机制、元组多字段优先级比对,到 operator 性能加速和 cmp_to_key 复杂场景,带你彻底掌握自定义排序的核心技巧。
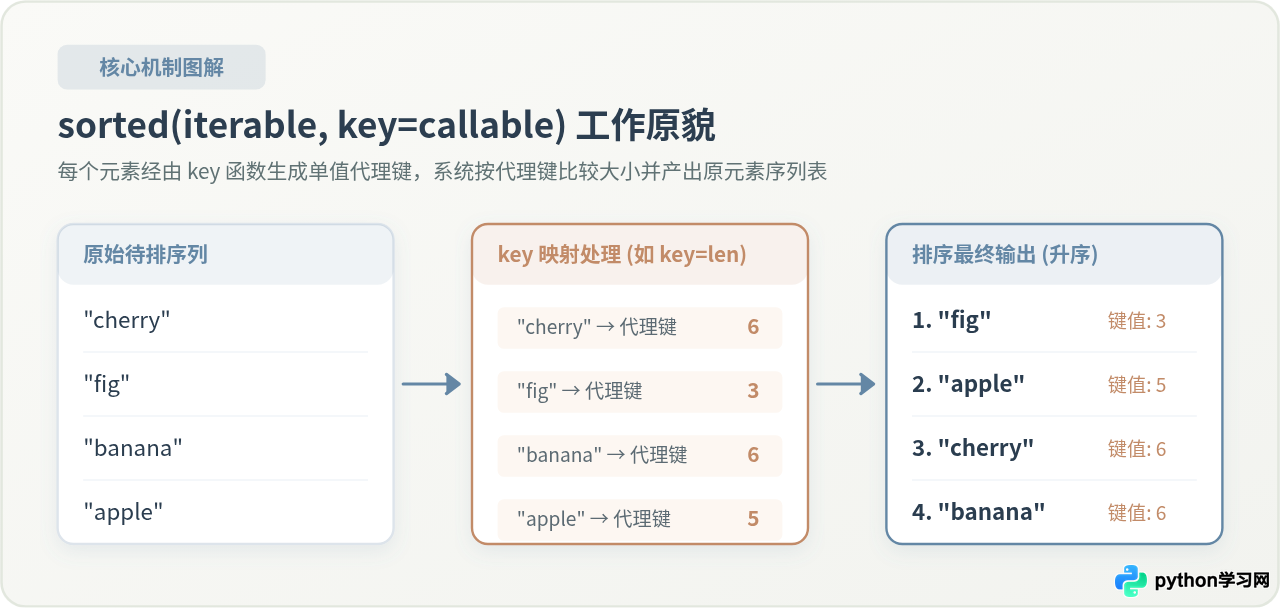
在 Python 中实现自定义排序的核心途径是使用 sorted() 函数(或列表的 list.sort() 方法)提供的 key 参数。key 参数接收一个只有一个参数的可调用对象(如内置函数、自定义函数、lambda 表达式或类方法),负责为待排序序列中的每个元素计算一个临时的“代理比较键(proxy key)”。排序算法在底层并不直接比较原始元素,而是通过比较这些计算出来的键值来决定元素的前后顺序,最终返回排好序的原元素列表。
一、key 参数的执行原理:Schwartzian 变换与单次评估
理解 key 参数的高效性,关键在于明白它背后的设计理念。在早期的编程语言或 Python 2 的旧版本中,自定义排序往往依赖比较函数 cmp(a, b),每次比较两个元素并返回负数、零或正数。这种传统模式在对包含 $N$ 个元素的列表进行排序时,通常需要调用比较函数 $O(N \log N)$ 次。如果比较逻辑涉及耗时的提取计算(如文本转换、长度统计、解析日期),这会导致巨大的性能浪费。
Python 的 key 机制采用了被称为 Schwartzian 变换(装饰-排序-取消装饰)的思想,在底层由 C 实现的 Timsort 算法驱动:
- 提取装饰(Decorate):遍历原始列表,对每个元素调用且仅调用一次
key函数,为每个元素生成一个对应的“代理键值”。这一阶段的函数调用次数严格等于元素总数 $N$。 - 内部排序(Sort):将原始元素与代理键以及其原本的索引位置打包为三元组,在底层只针对代理键进行快速比较。由于 Python 的 Timsort 具有稳定性(Stable),相同键值的元素将严格保持它们原本的先后次序。
- 还原解包(Undecorate):排序完成后,直接剥离辅助比较的代理键,将原始元素按排好的顺序组装成新的列表返回。
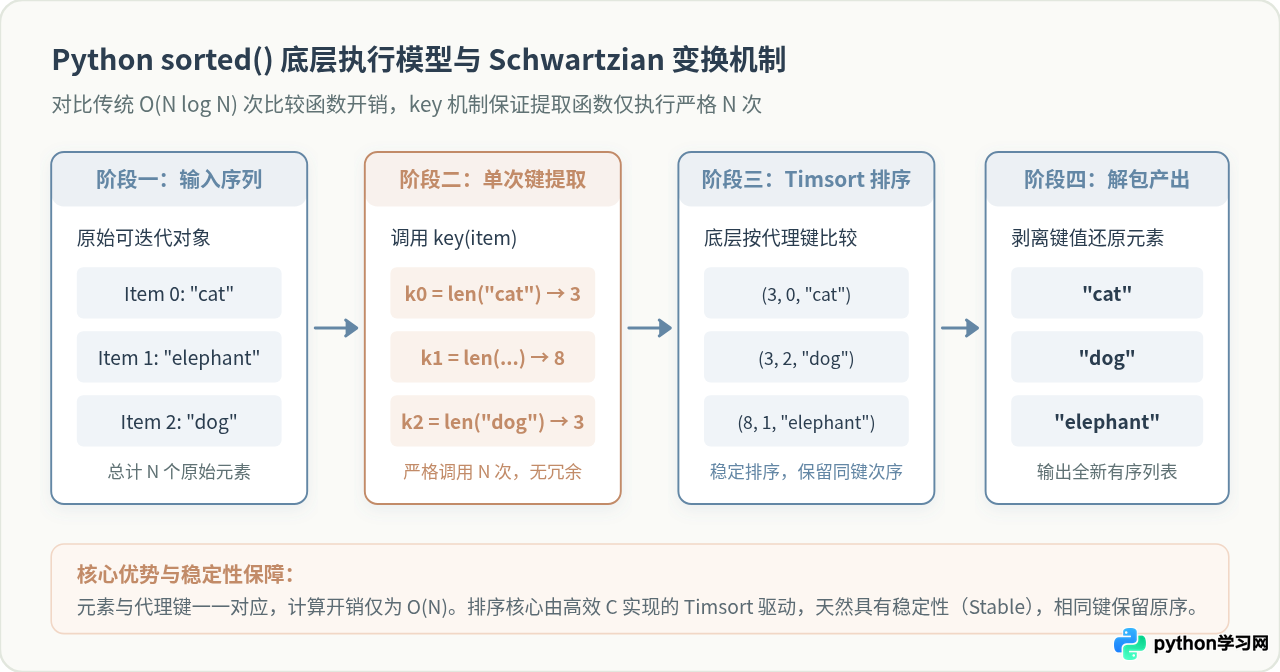
这一机制保证了无论排序过程内部发生了多少次二分查找或元素移动,我们传入的 key 提取逻辑在整个排序周期中对每个元素都只执行一次,兼具极高的执行效率与内存友好性。
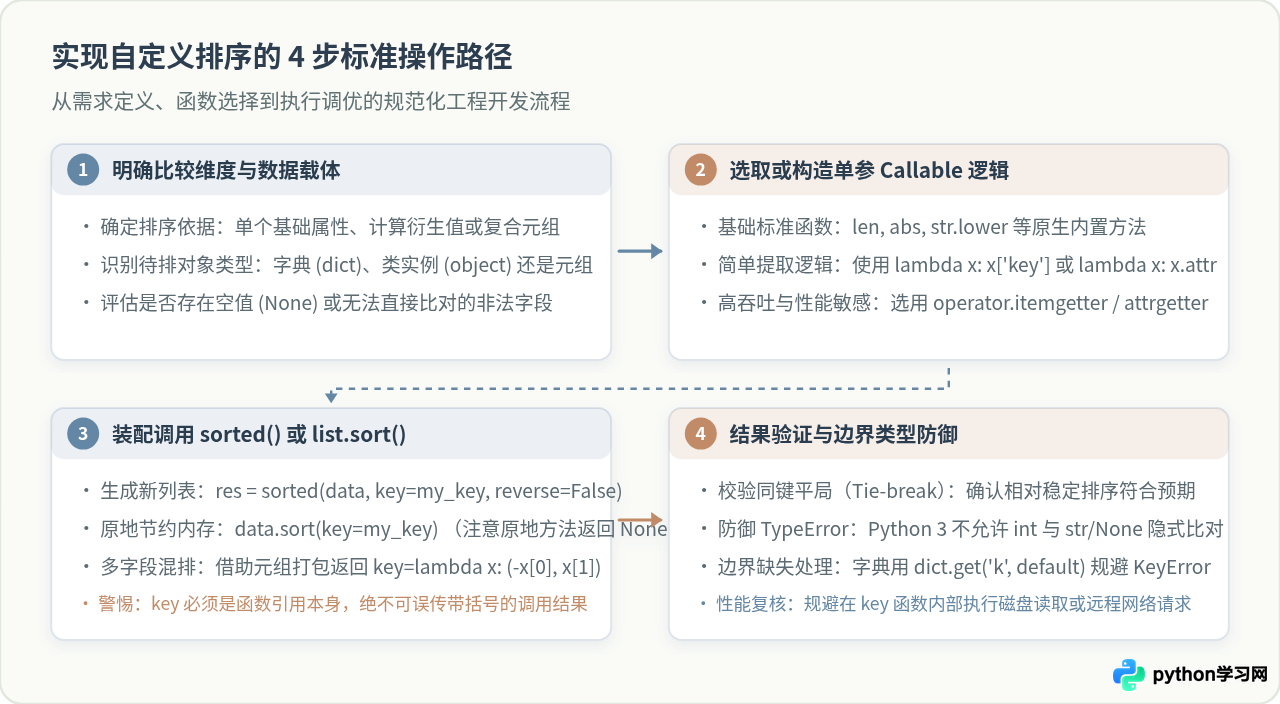
二、实现自定义排序的基本方法与 4 步流程
在日常开发中,实现自定义排序通常遵循标准的 4 个操作步骤:明确比较维度、选取 Callable 形式、调用 sorted 注入规则、验证同键稳定性与异常防御。
1. 直接传入内置函数
当排序维度恰好对应 Python 原生提供的单一入参函数或类型方法时,直接将函数名作为 key 传入是最为简洁且执行速度最快的方式。注意此处传递的是函数对象本身,切勿加括号调用。
# 场景:按单词长度由短到长排序
words = ["python", "go", "rust", "typescript", "c"]
sorted_by_len = sorted(words, key=len)
# 示例输出: ['c', 'go', 'rust', 'python', 'typescript']

# 场景:忽略英文大小写进行字母序排序
mixed_cases = ["Apple", "banana", "Cherry", "date"]
sorted_case_insensitive = sorted(mixed_cases, key=str.lower)
# 示例输出: ['Apple', 'banana', 'Cherry', 'date']

# 场景:按数值绝对值从小到大排序
numbers = [-15, 3, -2, 8, -7]
sorted_by_abs = sorted(numbers, key=abs)
# 示例输出: [-2, 3, -7, 8, -15]
2. 编写 lambda 匿名函数处理结构化数据
当待排列表包含字典、嵌套元组或自定义对象实例时,我们需要指定对象的具体字段进行比对。使用 lambda 表达式可以灵活提取任意内部属性。
students = [
    {"name": "Alice", "score": 85, "age": 20},
    {"name": "Bob", "score": 92, "age": 19},
    {"name": "Charlie", "score": 78, "age": 21}
]

# 按成绩从高到低排序(配合 reverse=True)
by_score_desc = sorted(students, key=lambda s: s["score"], reverse=True)
# 示例输出:
# [
#   {'name': 'Bob', 'score': 92, 'age': 19},
#   {'name': 'Alice', 'score': 85, 'age': 20},
#   {'name': 'Charlie', 'score': 78, 'age': 21}
# ]
三、多字段组合排序与 Tie-break 平局决策
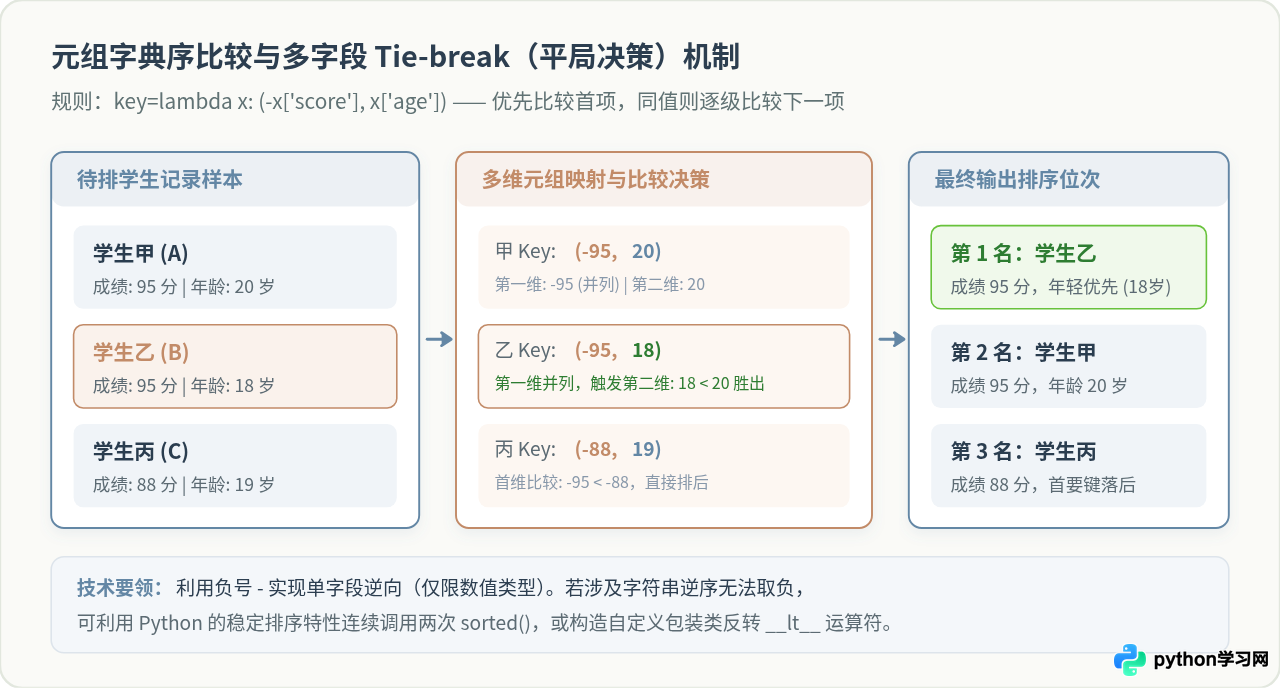
在真实业务场景中,单一维度的排序往往无法满足需求。例如:当两个学生的成绩相同时,需要按年龄升序排列;或者在电商系统中,先按商品库存状态降序,再按销量降序,最后按价格升序。这种多级排序依赖于 Python 原生 元组(tuple)的字典序比较机制。
(a1, a2, ...) 与 (b1, b2, ...) 时,首先比较第 0 个位置的元素 a1 与 b1;如果它们不相等,则以该比较结果作为整体元组的大小关系;如果它们完全相等(发生 Tie 平局),才继续比对第 1 个位置的元素 a2 与 b2,以此类推。
只要让 key 函数返回一个包含多个字段的元组,就能自然实现“主要关键键 + 次要关键键”的多层级排序。
1. 同向多字段排序(全升序或全降序)
如果所有关键键都以相同方向排序,只需在返回的元组中按优先级顺序列出属性即可:
records = [
    {"department": "Tech", "title": "Lead", "level": 5},
    {"department": "HR", "title": "Staff", "level": 3},
    {"department": "Tech", "title": "Junior", "level": 2},
    {"department": "Tech", "title": "Senior", "level": 4}
]

# 优先按部门名称升序,同部门下按职级 level 升序
sorted_records = sorted(records, key=lambda x: (x["department"], x["level"]))
# 示例输出中,HR 部门排在 Tech 前面;Tech 内部严格按 level (2 -> 4 -> 5) 递增
2. 混合异向排序:利用数值取负法
如果需要“字段 A 降序,但字段 A 相同时字段 B 升序”,当降序字段为数值类型时,技巧是直接在字段前添加负号 -。因为 $-95 < -88$,数值取负后在默认升序算法中便会自动排在最前面,从而巧妙避免全局 reverse=True 导致全字段反转的问题。
students = [
    {"name": "Alice", "score": 95, "age": 20},
    {"name": "Bob", "score": 95, "age": 18},
    {"name": "Charlie", "score": 88, "age": 19}
]

# 要求:成绩降序(越高越前),成绩相同时年龄升序(越小越前)
sorted_mixed = sorted(students, key=lambda s: (-s["score"], s["age"]))
# 示例输出:
# [
#   {'name': 'Bob', 'score': 95, 'age': 18},   # 成绩 95,年龄更小排第 1
#   {'name': 'Alice', 'score': 95, 'age': 20}, # 成绩 95,年龄更大排第 2
#   {'name': 'Charlie', 'score': 88, 'age': 19}
# ]
四、进阶提速:使用 operator 模块与复杂比较转换
1. operator.itemgetter 与 operator.attrgetter 的底层性能优势
虽然 lambda x: x['key'] 足够灵活,但在处理数十万行级的大型列表时,频繁在 Python 虚拟机中创建和销毁栈帧会带来可观测的性能损耗。Python 标准库内置的 operator 模块提供了由 C 语言实现的字段提取函数:itemgetter(针对字典和序列索引)与 attrgetter(针对自定义类实例属性)。
from operator import itemgetter, attrgetter

# 针对字典或序列:itemgetter 支持单字段或多字段提取
users = [
    {"id": 101, "role": "admin", "login_count": 42},
    {"id": 102, "role": "user", "login_count": 18},
    {"id": 103, "role": "admin", "login_count": 9}
]

# 多字段提取:等价于 lambda x: (x["role"], x["login_count"])
# 但底层完全在 C 语言循环中完成,吞吐量提升约 20%~40%
fast_sorted = sorted(users, key=itemgetter("role", "login_count"))

# 针对类实例:attrgetter
class Product:
    def __init__(self, name, price, stock):
        self.name = name
        self.price = price
        self.stock = stock

products = [Product("Keyboard", 299, 10), Product("Mouse", 99, 50)]
sorted_products = sorted(products, key=attrgetter("price"))
2. 复杂逻辑与双参数比较转换:functools.cmp_to_key
有些排序规则很难直接映射为一个简单的单值。例如经典的“拼接最大数”算法问题:给定一组正整数,决定它们拼合在一起时的先后顺序。此时判断 $a$ 和 $b$ 谁在前,取决于字符串拼合结果 $str(a) + str(b)$ 与 $str(b) + str(a)$ 的大小,这种比较必须同时依赖两个元素。
为了解决这种双参数依赖问题,Python 在 functools 模块中提供了 cmp_to_key 适配器。它将传统的 cmp(x, y) 函数包装成一个拥有富比较方法(__lt__ 等)的类,使旧式比较逻辑能够无缝接入 sorted() 的 key 机制。
from functools import cmp_to_key

nums = [3, 30, 34, 5, 9]

# 定义双参数比较函数:若希望 x 排在 y 前面,返回负数;反之返回正数
def compare_concat(x, y):
    s1, s2 = str(x) + str(y), str(y) + str(x)
    if s1 > s2:
        return -1  # 降序:拼出数字更大者优先
    elif s1 < s2:
        return 1
    return 0

largest_number_order = sorted(nums, key=cmp_to_key(compare_concat))
# 示例输出: [9, 5, 34, 3, 30]
# 拼接成的最大数字结果为: "9534330"
五、常见陷阱与注意事项
sorted(iterable) 是 Python 内置函数,适用于任何可迭代对象,始终创建并返回一个全新的排好序的列表,原对象不受任何影响。list.sort() 是列表独有的方法,直接在原列表内存中进行原地重排,执行速度略快且节约内存,但其返回值永远是 None。切勿写出 my_list = my_list.sort(key=...),这会导致原数据丢失变为 None。
key 对每个元素只调用一次,但如果列表有 100,000 个元素,该函数依然要执行 100,000 次。切勿在 key 函数内部执行磁盘读取、网络请求、正则表达式重复编译或修改外部状态。
None < 1 是合法的;但在 Python 3 中,跨类型直接比较会抛出 TypeError: '<' not supported between instances of 'NoneType' and 'int'。若数据中存在缺失值
None,可在 key 中将其转换为带有边界标记的元组,例如:key=lambda x: (x is None, x)(所有 None 自动归聚到末尾,正常数值之间正常比较)。
-x 轻松逆序,但字符串没有 -str 运算。如果在多字段排序中需要“字符串字段降序,数值字段升序”,由于 Python 保证排序稳定性,可以通过反向连续排序实现:先按次要键(数值)升序排序,再按主要键(字符串)降序排序。
六、自定义排序方案全景选型与总结
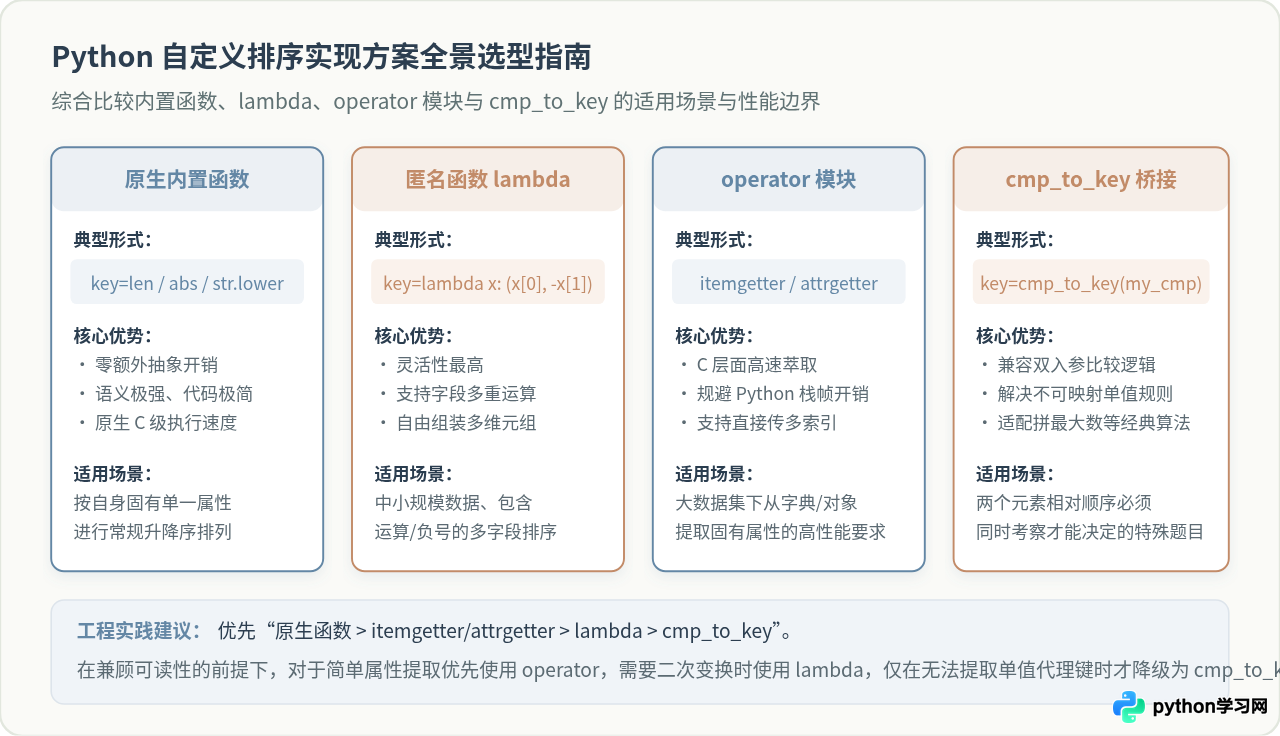
为了在工程项目中写出既健壮又高效的代码,我们可以按照以下选型标准来选择合适的 key 表达形式:
| 实现工具 | 典型代码形式 | 性能评级 | 适用典型场景 |
|---|---|---|---|
| 内置函数 | key=len, key=abs |
最高(原生 C 执行) | 单维度简单属性、字符串大小写折叠 |
| operator 模块 | key=itemgetter('id', 'name') |
极高(C 扩展底层提取) | 大数据量下字典/对象的多字段纯属性萃取 |
| lambda 表达式 | key=lambda x: (-x['val'], x['id']) |
中高(通用灵活) | 中小数据集、包含算术运算、负号取反等二次计算 |
| cmp_to_key | key=cmp_to_key(custom_cmp) |
中等(有包装类转发开销) | 必须同时依赖两两元素相对关系的算法与特殊题目 |
总结而言,Python sorted() 函数的 key 参数不仅赋予了开发者极高的定制灵活性,其底层的 Schwartzian 变换机制更兼顾了现代编程语言对效率与稳定性的严格要求。熟练掌握单值提取、元组字典序判定以及标准库工具的配合,能够帮助我们在面对复杂业务数据时游刃有余地构建出清晰且高性能的排序逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









